
Всем привет! Меня зовут Михаил Поливаха, я являюсь техническим лидером Open Source проекта Axelix.
Представьте довольно простую ситуацию. У Вас есть Spring Boot сервис, который раз в некоторое время ходит во внешнюю систему и синхронизирует какие-то данные. Обычный метод с @Scheduled, ничего особенного. И вот к Вам приходит коллега и говорит:
Что-то часть данных не обновилась. У нас точно синк прошёл?
Вы открываете логи. Потом вспоминаете, что реплик сервиса вообще-то три. Потом выясняется, что задача иногда падает, иногда отрабатывает успешно, а иногда выполняется заметно дольше обычного. И нужно понять, когда именно всё это началось и на каком инстансе происходило.
Если вы хотя бы какое-то время писали код в Enterprise, то я уверен, что для вас это знакомая история. И к сожалению, часто для большинства команд поведение этих самых Scheduled тасок на проде или на тестовом окружении покрыто туманом войны, там до конца непонятно, что происходит.
Недавно мы срелизили Axelix 1.3 и одна из фич, которую мы сделали, это добавили историю выполнения scheduled tasks:
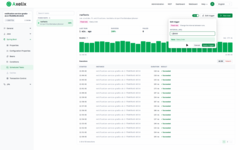 История выполнения scheduled tasks в интерфейсе Axelix 1.3Небольшой факт
Около 10 внешних контрибьютеров приняло участие в релизе. Спасибо вам всем! Если у вас тоже есть желание поконтрибьютить в Open Source — welcome! Мы это приветствуем. Подробнее об этом можно [почитать тут](https://github.com/axelixlabs/axelix?tab=contributing-ov-file#how-to-contribute).
В этой статье я хочу разобрать две задачи, которые возникают при реализации такой истории: как понять, что на разных репликах работает одна и та же scheduled task, и как отличить новый запуск от повторно доставленного результата старого. Покажу, какие идентификаторы мы для этого используем и какие компромиссы за ними стоят.
Ну и отдельно поговорим о перформансе всей этой истории, потому что инструмент для диагностики приложения сам должен довольно аккуратно относиться к его ресурсам.
Если вы инженер, то я надеюсь, статья вам понравится — тут много трейд оффов и различного рода решений, с которыми можно поспорить. Нам будет приятно услышать ваше мнение и советы по поводу того, каким бы вы хотели увидеть продолжение этой фичи. Мы правда стараемся слушать сообщество.
Сначала про саму проблему
Возьмём простой пример:
@Componentpublic class CatalogSync { private final CatalogClient client; public CatalogSync(CatalogClient client) { this.client = client; } @Scheduled(fixedDelayString = "${catalog.sync.delay:60000}") public void sync() { client.synchronize(); }}По исходникам понятно, что задача должна делать. Из конфигурации можно выяснить, с каким интервалом она должна запускаться. Но когда нас спрашивают, почему каталог не обновился, интересуют уже другие вещи:
-
Когда задача действительно запускалась?
-
Завершилась ли она успешно, и если упала с исключением, то с каким именно?
-
На какой реплике это произошло?
-
Это был запуск по расписанию или кто-то нажал кнопку запуска вручную? (В Axelix так можно)
И вот тут важно: описание расписания само по себе не отвечает на вопрос, что реально происходило с задачей.
Можно расставить логи. Можно самостоятельно завести метрики и отдельно сохранять результаты запусков где-либо. Но это повторяющаяся инфраструктурная работа, которую нужно делать для каждой задачи и поддерживать по мере развития приложения.
Нам хотелось, чтобы после подключения Axelix эта информация появлялась сама. Для начала посмотрим, какой путь проходит результат выполнения от конкретной реплики до общей истории.
Как история попадает на мастер
Вернёмся к нашим трём репликам. На каждой работает одна и та же задача синхронизации каталога, но запускается и завершается она независимо. Часто люди пытаются как-то синхронизировать исполнение задач, например, через ShedLock или через нативные блокировки в БД, например SELECT ... FOR UPDATE SKIP LOCKED и т.п. вещи.
Чтобы увидеть общую историю, результаты со всех реплик нужно собрать в одном месте.
В Axelix этим местом служит Master, отдельное приложение с UI и базой данных. Внутри каждого Spring Boot сервиса подключена клиентская библиотека в виде стартера. Она фиксирует результаты локальных запусков и передаёт их мастеру: либо сама отправляет данные в heartbeat-ах, либо возвращает их в ответ на периодический опрос мастера.
В обработку задач Spring мы встраиваемся и для синхронного, и для реактивного выполнения. В первом случае фиксируем результат вокруг выполнения задачи, во втором используем observations Spring Framework 6.1+, чтобы дождаться завершения реактивной работы. Детали можно посмотреть в коде синхронной записи и обработчике реактивных observations. Здесь речь про периодические @Scheduled задачи с cron, fixedDelay и fixedRate.
В запись попадают время начала, длительность, результат, тип запуска и информация об ошибке, если она была. Успех здесь означает завершение без исключения, видимого перехватчику: если задача сама поймала ошибку и вернулась, про бизнес-сбой из этого механизма мы не узнаем.
Стартер хранит только последние 10 завершённых выполнений каждой задачи. Это ротирующийся буфер в памяти сервиса: при добавлении новой записи самая старая вытесняется. Раз в определённый интервал его содержимое передаётся мастеру. Например, в режиме heartbeat интервал по умолчанию составляет 15 секунд. Отдельного сетевого запроса на каждый запуск задачи нет.
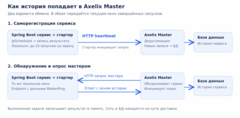 Два варианта доставки истории из стартера на мастер
Мастер сохраняет полученные результаты в своей БД. Поэтому вытеснение записи из локального буфера не удаляет её из общей истории, если мастер уже успел её сохранить. Доставленная история переживает и перезапуск самого сервиса; срок её хранения определяется настройками мастера.
При этом доставка периодическая, а не мгновенная. Если запись так и не попала в успешно доставленный пакет до вытеснения или завершения процесса, мастер её не сохранит. К этому ограничению вернёмся, когда будем разбирать сам буфер.
Почему передаём одни и те же записи повторно
При очередном обмене мы передаём всё текущее окно, включая результаты, которые мастер уже мог получить. После отправки окно не очищается, его содержимое меняется по мере завершения новых запусков.
Допустим, один heartbeat не дошёл. При следующем обмене результат снова попадёт в пакет, если ещё остаётся в окне. А если мастер успел сохранить пакет, но ответ потерялся, повторная доставка не должна создать дубликаты.
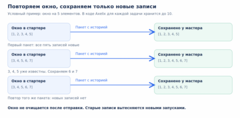 Повторная отправка пересекающихся окон и дедупликация на мастере
Получается, мастер получает результаты с разных реплик, а внутри пакетов встречаются повторы. И тут возникают два вопроса:
-
Как понять, что на разных репликах выполнялась одна и та же задача,
-
И как отличить её новый запуск от повторно доставленного результата старого?
Давайте по порядку.
Разделим задачу от её выполнения
У нашего CatalogSync.sync() есть общая история по трём репликам. При этом каждый запуск принадлежит конкретной реплике и должен появиться в истории ровно один раз, сколько бы раз мы ни передали его результат.
То есть здесь две разные identity:
-
Identity задачи: какая именно scheduled task выполняется. Она должна совпадать на разных инстансах одного приложения.
-
Identity выполнения: какой конкретно запуск этой задачи мы наблюдаем. У разных запусков должны быть разные ID, а при повторной доставке одного результата его ID должен остаться прежним.
Если смешать эти две вещи, история довольно быстро развалится. Привяжем задачу к объекту в конкретной JVM, и у каждой реплики получится собственная задача. Будем выдавать результату новый случайный UUID при каждом получении, и повторная доставка станет выглядеть как ещё один запуск.
Эта проблема возникает в любом похожем инструменте, который собирает историю событий с нескольких процессов. Поэтому давайте разберём, как мы её решаем.
Как определить identity самой задачи
Первое, что приходит в голову: возьмём имя класса и имя метода. Если прямо строго говорить, то сюда ещё и ClassLoader должен быть включен, т.к. класс в Java определяется именно парой ClassLoader + FQCN, но мы сейчас это опустим для упрощения. На практике, у традиционных Spring Boot Java приложений крайне редко бывает так, чтобы классы именно приложения грузились разными класслоадерами (не путать с классами из бут класспаса и т.д.).
Для нашего примера получится com.example.CatalogSync.sync. Такой идентификатор не зависит от адреса Pod-а или от того, в какой JVM сейчас работает приложение. Вроде как окей.
Но есть нюанс, про который мало кто знает: на одном методе может быть несколько @Scheduled, т.к. @Scheduled является repeatable. Например:
@Scheduled(cron = "0 0 2 * * *")@Scheduled(cron = "0 0 14 * * *")@Scheduled(fixedDelay = 60000)public void sync() { client.synchronize();}Метод один, а расписаний три. Если использовать только имя метода, мы смешаем их историю. По сути, нам нужно идентифицировать конкретную @Scheduled аннотацию, которая задаёт отдельную задачу.
Поэтому в текущей реализации taskId имеет следующий вид:
.#Для примера выше:
com.example.CatalogSync.sync#cron0com.example.CatalogSync.sync#cron1com.example.CatalogSync.sync#fixedDelay0Обратите внимание: номер считается с нуля среди аннотаций того же вида, в порядке их обработки Spring. Поэтому у fixedDelay здесь номер 0, хотя на методе он стоит третьим. Для fixedRate будет свой счётчик.
В коде регистратора это выглядит буквально так:
runnable + "#" + annotation.suffix()Здесь используется строковое представление runnable, которое Spring формирует для аннотированного метода, а suffix() добавляет вид расписания и его номер. Это не произвольный Object.toString() с identity hash code. Формирование суффикса можно посмотреть в AxelixScheduledAnnotationBeanPostProcessor, а сборку ID в регистраторе.
Само значение cron-выражения или интервала в ID не входит. То есть изменение интервала при сохранении вида и номера расписания само по себе новую identity не создаёт.
Как объединить историю разных реплик
С taskId мы определились, но он идентифицирует задачу только в рамках приложения. В двух разных сервисах вполне могут оказаться одинаковые имена классов и методов.
На мастере приложение определяется парой groupId и artifactId. Поэтому общая история задачи выбирается по тройке:
(groupId, artifactId, taskId)Версия приложения в эту тройку не входит, как и ID инстанса, что логично, ведь мы храним историю, которая по продолжительности своей жизни должна пережить инстанс конкретного приложения и версию конкретного приложения.
Пока identity задачи не изменилась, очередной деплой сам по себе историю не разделит.
В записи выполнения при этом сохраняются и instanceId, и имя инстанса. Поэтому можно одновременно собрать все запуски задачи по репликам и показать, где выполнялся каждый из них. SQL-запрос довольно хорошо объясняет эту идею:
SELECT * FROM scheduled_task_execution_resultsWHERE group_id = :groupId AND artifact_id = :artifactId AND task_id = :taskIdORDER BY started_at DESC, id DESCВ WHERE нет фильтра по инстансу. Это и позволяет получить общую историю. Реализация находится в репозитории результатов выполнения.
Как определить identity конкретного выполнения
Теперь вторая половина задачи. taskId у двух реплик одинаковый, но результаты их запусков смешивать в одну запись нельзя. Более того, одна и та же реплика выполняет эту задачу много раз.
На мастере результат представлен доменной сущностью ScheduledTaskExecutionResult. Её ID вычисляется из трёх значений:
instanceId + taskId + startedAt.toEpochMilli()Далее из UTF-8 байтов получившейся строки создаётся name-based UUID. Вот фактический метод из ScheduledTaskExecutionResultConverter:
private static String id(String instanceId, String taskId, Instant startedAt) { String execution = instanceId + taskId + startedAt.toEpochMilli(); return UUID.nameUUIDFromBytes(execution.getBytes(StandardCharsets.UTF_8)) .toString();}Почему именно эти поля? instanceId различает реплики, taskId различает задачи внутри реплики, а время начала различает их запуски. И при этом все три значения остаются прежними, когда один и тот же результат повторно приезжает на мастер.
Здесь важно, что UUID вычисляется детерминированно, используя под капотом MD5 алгоритм хеширования.
Очевидно, что у такого решения есть и граница точности: два запуска одной задачи на одном инстансе, начавшиеся в одну миллисекунду, получат одинаковый ID, но мы посчитали, что это сценарий практически невероятный.
Разницу удобно представить так:
Что хотим узнать
Какие данные используем
Какая задача внутри приложения
Класс, метод, вид расписания и номер аннотации этого вида
Какие запуски относятся к общей истории
groupId, artifactId, taskId
Получали ли мы уже этот результат
ID из instanceId, taskId, времени начала в миллисекундах
У двух реплик будет одна identity задачи и разные ID выполнений. А повторная передача результата с той же реплики сохранит его ID.
Как работает дедупликация на мастере
Теперь пригодится ID результата, который мы разобрали выше. При повторной доставке тех же instanceId, taskId и времени начала мастер вычислит прежний ID выполнения.
Дальше алгоритм простой:
-
Собираем ID из пришедшего набора результатов.
-
Одним запросом находим те из них, которые уже есть в БД.
-
Отфильтровываем известные записи и передаём оставшиеся в
saveAll().
В сервисе истории это выглядит так:
Set alreadyStoredIds = executionResultRepository.findStoredIds(ids);executionResultRepository.saveAll(scheduledTaskExecutionResults.stream() .filter(execution -> !alreadyStoredIds.contains(execution.id())) .toList());Таким образом, повтор окна с запусками 3, 4, 5, 6, 7 после окна 1, 2, 3, 4, 5 добавит только 6 и 7. Повторная доставка не раздувает историю и не увеличивает число запусков в статистике, пока записи с такими ID есть в БД.
И это свойство получается именно из сочетания двух решений: клиент может повторять недавние результаты, а мастер может воспроизводимо узнать каждый из них. Одной ограниченной коллекции без стабильной identity выполнения для этого было бы недостаточно.
Но ведь переименование метода сломает историю?
Да, сломает.
Вся схема опирается на taskId, а он зависит от структуры кода. И это, пожалуй, главный компромисс выбранного решения. Вот у Вас была задача:
com.example.CatalogSync.sync#cron0А потом Вы переименовали метод:
com.example.CatalogSync.synchronize#cron0С точки зрения бизнес-логики, возможно, ничего не поменялось. Но с точки зрения нашего идентификатора это уже другая задача. То же самое произойдёт при переименовании класса или переносе его в другой пакет. А перестановка нескольких аннотаций одного вида может поменять соответствие между расписанием и его порядковым номером.
Прежние записи не удаляются из БД из-за переименования. Но автоматически связать их с новым taskId мы уже не можем. Поэтому в истории задачи с новым именем отсчёт начнётся заново.
Почему тогда не дать пользователю задать ID явно?
Мы как раз обсуждали такую альтернативу в issue #1721. Можно было бы добавить собственную составную аннотацию поверх @Scheduled, в которой пользователь задавал бы стабильный taskId. Тогда имя метода или пакет класса можно было бы менять независимо от identity задачи.
На первый взгляд всё хорошо. Но цена этого решения шире, чем ещё одна аннотация.
Всё это время мы придерживались подхода: Вы подключаете клиентскую библиотеку Axelix, но не используете её классы в коде приложения. Даже если какой-то класс технически public, это ещё не означает, что мы предлагаем Вам строить на нём свою интеграцию.
Собственная аннотация создала бы прецедент: бизнес-код начал бы явно зависеть от API нашего клиента. Пользователю пришлось бы размечать задачи, следить за уникальностью ID, а нам поддерживать этот публичный контракт при дальнейших изменениях. Подключить библиотеку и получить диагностику уже недостаточно, нужно ещё изменить приложение.
И вот тут стоит вспомнить, какую проблему мы вообще решаем. История scheduled tasks нужна нам прежде всего для дебага: понять, что задача делала недавно, где упала, возможно выполнить её вручную заново.
Если Вы переименовываете такой метод условно раз в несколько месяцев, то между этими переименованиями identity остаётся стабильной. Для разбора текущих проблем такой непрерывности нам кажется достаточно. Сохранять связь через любой рефакторинг было бы полезно, но ради этого вводить отдельный пользовательский API мы пока не стали.
В общем, мы выбрали такой сознательный trade-off: автоматическая идентификация без изменений пользовательского кода в обмен на зависимость истории от структуры этого кода.
Нам было бы очень интересно узнать, что вы об этом думаете, и как вы думаете, можно было бы решить эту проблему по‑другому.
Зачем стартеру скользящее окно
Теперь путь результата понятен: стартер фиксирует выполнение, периодически передаёт его мастеру, а мастер узнаёт повторные результаты и сохраняет новые. Осталось разобрать локальный буфер, из которого мы собираем эти пакеты.
Почему вообще хранить данные внутри сервиса? Между двумя обменами задача может выполниться несколько раз. Её результаты нужно где-то подержать, причём отправка уже сохранённых записей не должна мешать добавлению новых.
Можно было бы складывать всё в растущую коллекцию. Но если мастер недоступен, такая коллекция продолжит расти вместе с числом запусков. Не хотелось бы в итоге объяснять пользователю, что его приложение съело память, потому что мы слишком старательно его диагностировали.
Поэтому для каждой задачи используется своё скользящее окно на последние 10 завершённых выполнений. Часто запускающаяся задача не вытеснит историю соседней, более редкой задачи: окна у них разные. А история, которую мы хотим хранить дольше, уже находится в БД мастера.
Важное уточнение: окно ограничено именно количеством записей. Оно не означает «последние 10 минут». Для задачи, работающей раз в секунду, и для задачи, работающей раз в сутки, временной охват будет совершенно разным.
Что происходит, если мастер не успевает
Периодическая передача позволяет сохранять историю длиннее локального окна, но ёмкость буфера должна соответствовать частоте запусков и интервалу обмена. Например, если между двумя снимками окна задача завершилась 15 раз, к следующему чтению в буфере останутся только последние 10 из этих результатов. Первые пять уже вытеснены.
То же самое возможно при длительной недоступности мастера. Если приложение завершилось до отправки, несохранённая локальная история пропадёт вместе с процессом. А незавершённая задача вообще ещё не создала запись результата.
Очевидно, что в рамках такого дизайна есть гипотетическая вероятность что-то потерять, т.е. потрять в рамках скользящего окна выполнение той или иной Scheduled Task. Но тут мы находимся в рамках трейд оффа снова:
Чем больше скользящее окно, тем выше memory footprint, который наш клиент вносит вам. Мы стараемся не вносить никакого значимого оверхеда, ни с точки зрения перфа, ни с точки зрения потребления heap-а. Но чем короче окно,
Так вот нам показалось, что чаще всего, если исходить из 2 ключевых гипотиз:
-
Axelix Master если и недоступен, то какое-то ограниченное время (это не даунтайм на 5-6-10 часов)
-
Подавляющая часть
@Scheduledтасок работает с интервалом, который существенно превышает interval синхронизации данных между стартером и мастером.
И если из этих предположений исходить, то окно должно быть относительно небольшим, нам показалось, для начала 10 хватит. Вопрос вам: Стоит ли давать его размер конфигурировать?
Надеюсь, что логика понятная. Теперь про скользящее окно и его реализацию у нас.
Скользящее окно. Заглядываем под капот
С требованиями к буферу мы определились: ограничить размер, вытеснять старые записи и позволять читать историю одновременно с добавлением новых результатов. В основе реализации лежит кольцевой массив фиксированного размера. Следующая запись получает последовательный номер, а слот для неё вычисляется так:
long sequence = nextSequence.getAndIncrement();int slot = (int) (sequence % capacity);Когда дошли до конца массива, начинаем снова с нулевого слота. Никаких сдвигов элементов, никаких удалений из начала списка.
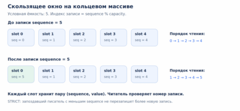 Запись в ring buffer и логический порядок чтения
Для наглядности на картинке ёмкость равна 5. Запись с номером 5 попадает в слот 0, где до этого лежала запись с номером 0. Физический порядок элементов в массиве уже отличается от порядка добавления. Поэтому в каждом слоте хранится пара (sequence, value), а читатель идёт по ожидаемым номерам записей и проверяет, что в слоте находится именно нужный номер.
Казалось бы, готово. Но у нас многопоточное приложение.
Проблема запоздавшего писателя
Представьте окно ёмкостью 10 и следующий порядок событий:
-
Поток A получил
sequence = 0и был вытеснен планировщиком до записи в массив. -
Другие потоки продолжили писать и дошли до
sequence = 10. Эта запись заняла слот 0. -
Поток A проснулся и решил записать свой старый результат в тот же слот.
Если просто вызвать set(), старый писатель затрёт более новую запись. И тут важный момент: атомарность присваивания сама по себе эту проблему не решает. Присваивание вполне себе атомарное, просто результат нам не нравится.
В SlidingWindow есть два режима записи. BEST_EFFORT допускает такое поведение. А STRICT, который используется для истории scheduled tasks, проверяет номер уже лежащей в слоте записи и обновляет слот через CAS:
while (true) { Entry current = buffer.get(slot); if (current != null && current.sequence > sequence) { return; } if (buffer.compareAndSet(slot, current, update)) { return; }}Если в слоте уже более новая запись, запоздавший поток её не трогает. Если слот изменился между чтением и CAS, пробуем снова.
Глобального synchronized здесь нет. В обычном случае запись делает атомарный инкремент, вычисляет индекс, создаёт небольшой Entry и обновляет один слот. При конкуренции CAS может потребовать повторов, а общий счётчик всё равно остаётся точкой contention. То есть «использовали atomics» не означает «конкуренция теперь бесплатная».
Что видит читатель
Чтение возвращает отдельный список размером не больше ёмкости окна. Проход ограничен последними capacity номерами, поэтому его стоимость линейна по размеру окна.
Но это weakly consistent чтение. Пока один поток собирает список, другой может записывать новые результаты. Часть слотов уже успеет измениться, часть записей ещё не будет опубликована. Поэтому конкретный снимок может содержать меньше элементов, чем ёмкость окна. Предположение в том, что рано или поздно консистентность будет восстановлена.
Для передачи диагностической истории это приемлемый компромисс: мы не останавливаем писателей ради общего снимка, а в следующий обмен снова включаем актуальное окно. Повторная передача помогает только пока запись остаётся в окне: вытеснённый результат из него уже не прочитать.
Полный класс небольшой, вот его исходники. Если Вам интересны concurrent структуры данных, рекомендую посмотреть.
А насколько это быстро?
Друзья, рассказывать про производительность, показывая только отсутствие synchronized, было бы довольно странно. Поэтому для окна у нас есть JMH-бенчмарки.
В них проверяется запись одним потоком и восемью потоками в общее окно. Есть параметры ёмкости 10, 200, 1000 и оба режима записи. Отдельные диагностические бенчмарки позволяют посмотреть стоимость конкуренции за AtomicLong и аллокации объекта, похожего на внутренний Entry.
Для этой статьи мы отдельно прогнали бенчмарки с параметрами окна истории: capacity=10, writeMode=STRICT, режим AverageTime. Условия: AMD Ryzen 7 8845HS, Amazon Corretto 21.0.8, JMH 1.37, heap 512 МБ, два fork-а, в каждом три прогревочные и пять измерительных итераций по одной секунде.
Сценарий
Среднее время, нс/операцию
Аллокации, байт/операцию
Один поток, put
6,29 ± 0,11
24
Восемь потоков, concurrentPut
292,31 ± 23,28
24
Погрешность указана так, как её выводит JMH для этого прогона: доверительный интервал 99,9%. Конкурентный результат показывает среднее время операции в потоках бенчмарка; для вычисления общей пропускной способности нужно учитывать все восемь потоков.
Что здесь видно? Во-первых, на этом стенде сама запись в окно довольно дешёвая. Во-вторых, конкуренция за общую структуру заметна. В-третьих, фиксированный массив не делает запись allocation-free: новый Entry создаётся при каждом добавлении. Профайлер GC как раз и позволяет это увидеть.
Но важно понимать, что именно мы измерили. Это SlidingWindow.put(). В этот результат не входят создание полной записи выполнения, получение времени, формирование JSON, HTTP и БД мастера. Не измеряет этот бенчмарк и стоимость чтения окна. Число «6 наносекунд» нельзя переносить на всю функциональность истории целиком.
Имейте в виду, что хоть contention на скользящем окно и возможен, на практике он почти точно не будет настолько большим как в примере. В редких случаях contention будет между двумя потоками, но чаще всего конкуренции вообще не будет, поэтому put на практике будет очень быстрый.
Воспроизвести такой прогон можно из корня репозитория:
./gradlew :sbs:starter-domain:jmh '-PjmhArgs=SlidingWindowBenchmark.(put|concurrentPut) -p capacity=10 -p writeMode=STRICT -bm avgt'В целом, причины небольших накладных расходов понятны из устройства: ограниченная локальная история, обновление одного слота при записи, отсутствие сетевого запроса на каждый запуск и передача результатов в уже существующем обмене с мастером. На мастере отдельно отфильтровываются уже известные записи, чтобы повторное окно не означало повторное сохранение всей истории.
Быстрое неправильное решение нам тоже не подходит
Performance-тест не ответит на вопрос, может ли запоздавший писатель затереть новую запись. Поэтому отдельно у нас есть обычные тесты и Lincheck-тесты конкурентного доступа (да, друзья, мы ещё и пишем concurrency тесты).
В Lincheck используются model checking и stress testing. Проверяются сценарии с вытеснением и без него, оба режима записи, конкурентное чтение. В частности, проверяются ограничение размера, отсутствие дубликатов и допустимый порядок элементов; после завершения писателей для строгого режима проверяются дополнительные инварианты сохранённого окна.
При этом тесты учитывают weakly consistent контракт чтения. Требовать от такой структуры атомарный снимок всех записей было бы уже требованием к другой структуре данных.
Заключительное слово
Для нас главный инженерный вопрос в этой фиче был в том, что считать одной и той же задачей и одним и тем же выполнением. От ответа зависит и общая история по репликам, и дедупликация при повторной доставке.
Мы выбрали вычисляемый taskId, который не требует размечать пользовательский код, и приняли разрыв истории при переименовании. Отдельный ID результата позволяет узнавать повторно полученный запуск, а ограниченное скользящее окно помогает передавать недавнюю историю с небольшими накладными расходами внутри сервиса.
Я думаю, эти вопросы полезно задавать себе в любой системе, где несколько процессов присылают историю событий. Что именно идентифицирует Ваш ключ? Между какими изменениями он остаётся стабильным? И какую цену Вы готовы заплатить за эту стабильность?
Исходники Axelix доступны на GitHub. Если Вам интересны детали или есть сценарий, который мы пока не покрываем, приходите с issue или PR. Такие кейсы помогают понять, куда развивать инструмент дальше.
Всем успехов!
Источник: habr.com