
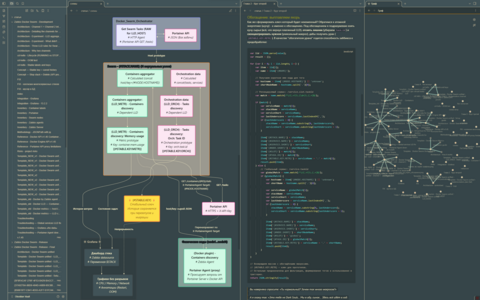
Пролог: на дне
Так уж вышло, что год назад я оказался в жизненном тупике. Ориентиры исчезли, я потерял контроль над собственной жизнью, дрейфовал по течению и не мог остановиться — даже когда понимал, что всё рушится. В какой-то момент я осознал: мне нужно что-то, что вернёт меня в реальность. Что-то сложное, что заставит мозг снова упорядочить хаос. Так я начал строить этот проект. И он стал моей терапией.
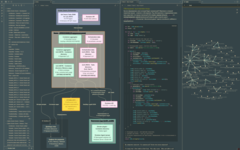 Мой мозг
 Grafana
Терапия оказалась суровой: чтобы что-то построить, пришлось сначала разобраться, почему всё сломано.
Стена плача: почему Swarm ломает мониторинг
Начнём с контекста. На работе приложения крутятся в Docker Swarm, управление — через Portainer, мониторинг — через Zabbix. Классическая связка, знакомая многим. Но именно она порождает главную боль: Zabbix не умеет мониторить Docker Swarm из коробки.
Типичная ситуация — разработчик деплоит новую версию приложения. Ночью контейнеры пересоздаются. Утром уставший админ открывает Zabbix, чтобы посмотреть график CPU за последнюю неделю — и видит пустоту. Данные есть только за последние часы. Всё, что накопилось до деплоя, потеряно.
Это и есть главная боль: Zabbix не умеет отличать «тот же самый контейнер, перезапущенный» от «другого контейнера». Для него это два разных объекта. Что это значит на практике:
-
Рваные графики. Вместо линии за неделю — пунктир. Каждый деплой обрывает историю.
-
Нет трендов. Нельзя увидеть, что сервис медленно утекал по памяти три недели, а потом упал.
-
Дубликаты метрик. Старые элементы висят в базе ещё 30 дней. В интерфейсе — каша из почти одинаковых имён.
-
Ложная картина. График чистый, а на деле контейнер пересоздался час назад. Данные начались заново.
-
Триггеры не работают как задумано. Условия вроде «5 минут подряд CPU выше 80%» не срабатывают — истории для сравнения нет.
-
Путаница с алертами. Контейнер упал и пересоздался. Старый алерт сработал, новый ещё молчит. Что происходит — непонятно.
-
Каскадный отказ. Плохо написанное приложение течёт по памяти и упирается в лимит Docker — OOM Killer убивает контейнер. Swarm перезапускает задачу: на той же ноде или на другой. Если лимиты не выставлены, контейнер может съесть всю память ноды, и тогда OOM Killer ядра начнёт убивать соседей — включая Docker и Portainer Agent. Нода деградирует, задача уезжает дальше, цикл повторяется. В итоге может лечь весь кластер. Я видел это своими глазами на боевом контуре. И самое страшное: когда кластер уже лежит, найти виноватый контейнер по рваным графикам почти невозможно. OOM Killer в
dmesgпишет имя процесса и PID, который после перезапуска уже другой. Контейнер пересоздан, история разорвана — концы в воду. Коллега с большим опытом подтвердил: проблема существует, решения из коробки нет. Это не моя паранойя — это системная дыра. Так я и начал копать.
Попутчики: что уже есть на этом пути
Проблема не нова, поэтому посмотрим какие основные решения уже есть в сети на эту тему, а так же приведём их недостатки:
Плагин toontoet/zabbix-agent2-plugin-docker-swarm — мониторит сервисы Swarm через плагин Zabbix Agent 2 на Go.
-
Требует компиляции и установки бинарника на каждую ноду.
-
Нужна правка
zabbix_agent2.confна каждой ноде. -
Не мониторит контейнеры как таковые. Нет метрик CPU, RAM, сети — только состояние сервиса. Ответ на вопрос «сколько ресурсов жрёт контейнер» плагин не даёт.
toontoet— хорошее решение для тех, кому нужен только оркестрационный мониторинг: реплики, рестарты, timestamp. Автор честно пишет в README, что мониторит сервисы, а не контейнеры (привязка кswarm.service.*) — и это правильный выбор для его цели. Но в этой статье мы пойдём глубже. Нам нужно видеть не только «где» контейнер, но и «как» он себя чувствует.
Мой подход тоже используетdocker.sock, но через штатный плагин Docker, уже встроенный в Zabbix Agent 2. На ноде нужно только добавить пользователяzabbixв группуdocker— это рекомендует сама документация Zabbix. Сторонние бинарники и правка конфигов не потребуются.
Шаблон kulpin74 — работает через Docker API с SSL-сертификатами.
-
Не сохраняет историю при перезапуске контейнера: ключ элемента данных привязан к имени с изменчивым
task.id, Zabbix создаёт новыйitemid, графики начинаются с нуля. -
Требует настройки SSL-сертификатов на каждой ноде.
Фикс из Medium — замена JSONPath на $.Labels["com.docker.swarm.service.name"].
-
Работает только для сервисов с одной репликой. Несколько реплик сливаются в один элемент.
-
Не решает проблему миграции
C-модуль monitoringartist
-
Требует компиляции под конкретную версию Zabbix.
-
Не специализирован под Swarm.
Вердикт был неутешительным. Одни решения сохраняли историю, но только на уровне оркестрации — слепые к метрикам CPU и RAM. Другие собирали метрики, но теряли их при каждом ребуте, рождая фантомные алерты. Третьи работали только для одной реплики.
Каждое из найденных решений тянуло за собой один из трёх вопросов, на которые ответа не было:
-
Как заставить историю метрик выживать, если контейнер пересоздается с нуля?
-
Как заставить Zabbix увидеть контейнер, если он мигрировал на другую ноду?
-
Как заставить Zabbix собрать этот хаос со всех нод в одну точку, не потеряв ни байта?
Впереди лежал путь через круги ада. Я ещё не знал, как именно это будет работать, не знал названий и не видел финальной схемы. Я знал только одно: чтобы выжить, мне понадобится нечто большее, чем просто плагины.
Придётся спускаться и искать попутчиков — механизмы, которые закроют эти три вопроса.
Мне понадобится Святая троица.
Карта и проводник: как не сойти с ума
С этим стеком технологий я знаком недолго — полтора года. Готовой методологии под такую задачу не было, поэтому действовал методом тыка и последовательного приближения: применял то, что работает здесь и сейчас. Когда накопилась критическая масса знаний, стало ясно — надо документировать, иначе забуду.
Так я узнал про Obsidian. Начал записывать заметки и параллельно наблюдал, как растёт граф — это даёт ощущение движения вперёд.
Параллельно создал основной контекст в DeepSeek — чат в режиме эксперта, где обозначил цель. Цель по ходу пьесы несколько раз менялась. Для локальных задач заводил отдельные чаты, а решения из них сливал в основной контекст, делая его «умнее».
Конечно, DeepSeek периодически уводил в сторону и предлагал глупости — то docker.sock на виртуальном узле, то какой-то странный UserParameter, то предобработку испортит (проверяйте в WinMerge) и потом извиняется. Но при должной сноровке из него получался помощник, который ускорял процесс в разы: напоминал, на чём мы остановились, что уже пробовали.
Проще говоря, Obsidian и DeepSeek стали моей внешней памятью.
Поиск: сто ребутов в пустоту
Первое и самое очевидное, что приходило в голову — начать искать стабильность в нестабильном окружении Docker. Найти сущность, которая не меняется при перезапуске контейнера.
Чтобы это выяснить, я взял подопытный сервис cd-my-web и прибил его к условной ноде номер 5 через placement constraint — чтобы при ребутах он не уезжал на другие ноды и эксперимент был чистым. Дальше дёргал API-ручки, фиксировал состояние, ребутал и снова фиксировал. И так десятки раз.
Смотрел на всё, что могло быть идентификатором:
-
Container ID — меняется при каждом ребуте. Не подходит.
-
Имя контейнера —
/cd-my-web_app.1.abc123def456ghi789jkl012mno. Меняется, потому что в нём зашитtask.id. Не подходит. -
Service ID — подходит для сервиса в целом, но если у сервиса три реплики — все три будут с одним Service ID. Для мониторинга каждой реплики не годится
-
Лейблы контейнера (
Labels) — интереснее всего. Именно там лежатcom.docker.swarm.service.nameиcom.docker.swarm.task.id. Первый не меняется, второй — наоборот. -
Task ID — а вот это интересно. Меняется при каждом ребуте. Есть всегда и однозначно определяет, к какой задаче относится контейнер. После десятков перезапусков картина стала ясной.
task.idведёт себя предсказуемо — не потому, что он не меняется (как раз наоборот), а потому, что он всегда есть. По нему всегда можно понять, какая задача сейчас живёт.
Это подтвердилось, когда я открыл официальную спецификацию Docker Engine API v1.45. Там чётко написано: задача (task) — это атомарная единица планирования в Swarm. У каждой задачи есть уникальный ID, который присваивается при её создании. Когда контейнер пересоздаётся, создаётся новая задача — с новым ID.
Ловушка Portainer: stop — это delete
Дальше я наткнулся на поведение Portainer, которое сначала казалось странным, а потом объяснило многое.
Я предположил, что после нажатия «Stop this stack» в Portainer, Docker Swarm где-то хранит информацию об остановленном стеке — это помогло бы в мониторинге. Проверил на практике: дёрнул /tasks, /services, /containers — нигде нет следов. Сервис исчез, задачи пропали, контейнеры уплыли…
Тогда я снова открыл спецификацию Docker Engine API v1.45 и нашёл объяснение: остановка стека — это не остановка, а полное удаление. Когда в Portainer ты нажимаешь «Stop this stack», под капотом вызывается DELETE /services/{id}. Сервис не останавливается — он исчезает вместе со всеми задачами, контейнерами, сетями и секретами.
Потом задеплоил заново — появился новый сервис с тем же именем, но с нуля. Это знание потом пригодилось, когда я строил архитектуру: если сервис при «Stop this stack» удаляется полностью, значит, и мониторинг должен уметь пережить это полное исчезновение.
А пока стало понятно главное: стабильного ID контейнера не существует. Ни Container ID, ни имя контейнера, ни Task ID не годятся. Все они либо меняются, либо исчезают..
Итог первого круга: якоря нет, но есть идея
Я сидел и смотрел на пустые графики. Якоря нет. За что держаться — непонятно. Может, всё это зря? Может, Zabbix действительно не создан для Docker Swarm, и надо смириться?
Но где-то на периферии сознания уже зрела мысль. Пока ещё сырая, неоформленная. Она пахла обогащением урана — и это было странно. При чём тут уран? При том, что обогащение — это отделение нужного от лишнего. А у меня было много лишнего (task.id, хеши, случайные строки) и очень мало нужного (имя сервиса, слот).
Может, если отсеять лишнее — останется что-то стабильное? Может, ключ не надо искать — может его надо выплавить самому?
Пора спускаться глубже…
Источник: habr.com