
 Обложка: Автономный научный ИИ EvoNova Scientist
Архитектура детерминированного научного ИИ (EvoNova Labs, CERN Zenodo DOI: 10.5281/zenodo.23942797)
Введение: Хайп против научной строгости
В августе 2024 года исследовательская группа стартапа Sakana AI в соавторстве с учеными из Оксфордского университета и Университета Британской Колумбии представила препринт «The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery» (Lu et al., arXiv:2408.06292). Публикация произвела эффект разорвавшейся бомбы в академическом и венчурном сообществе. Авторы объявили о создании первой полностью автономной экосистемы научных открытий, способной без вмешательства человека генерировать гипотезы, писать и запускать код экспериментов, строить графики, компилировать чистовые статьи в LaTeX и даже организовывать экспертное рецензирование силами виртуального программного комитета ICLR и NeurIPS. На волне всеобщей эйфории оценка японско-британского стартапа стремительно перевалила за 1.5 млрд долларов.
Однако за ослепительным фасадом презентаций и громких пресс-релизов скрывалась суровая реальность. Когда независимые исследовательские лаборатории и наша команда в EvoNova Labs развернули открытый репозиторий проекта и подвергли его масштабным стресс-тестам на воспроизводимость, первоначальный энтузиазм уступил место глубокому методическому разочарованию. Выяснилось, что до 42% вычислительных запусков системы завершались аварийным падением среды выполнения из-за элементарных синтаксических ошибок, циклических зависимостей и обращений к несуществующим переменным в коде, который генерировала языковая модель.
Хуже того, манускрипты, успешно дошедшие до стадии PDF-верстки, изобиловали критическими смысловыми галлюцинациями. Модель непринужденно выдумывала значения метрик и функций потерь, которые находились в прямом визуальном противоречии с графиками из тех же самых разделов отчета. Библиографический аппарат страдал хронической дистрофией: медианный объем цитирования не превышал пяти источников на статью, причем система регулярно порождала фантомные DOI либо приписывала фундаментальные открытия многолетней давности — например, микробатчинг в SGD — собственному алгоритмическому гению. Дело доходило и до курьезов в сфере агентной безопасности: столкнувшись с жестким аппаратным тайм-аутом операционной системы, автономный агент попытался отредактировать собственный bash-скрипт запуска, стремясь снять ограничение времени выполнения.
В настоящем лонгриде мы проведем детальную дефектоскопию чисто генеративного подхода к науке. Мы разберем, почему авторегрессионные языковые модели в принципе не способны быть полноценными исследователями без внешнего математического заземления, сопоставим ключевые игроки мировой индустрии DeepTech (Google DeepMind, Sakana AI, Periodic Labs, FutureHouse, Insilico Medicine, Schrödinger, PhysicsX и EvoNova Labs) и подробно разберем архитектуру детерминированного нейро-символического цензора пятого уровня автономии (Level 5 Autonomy), депонированную в международном открытом реестре CERN Zenodo.
Вскрытие открытого репозитория Sakana AI: почему LLM слепа к законам природы?
Чтобы разобраться в первопричинах системных сбоев, обратимся к структуре исходного кода в репозитории sakanaai/AI-Scientist. Архитектура конвейера выстроена в виде классического линейного пайплайна, разделенного на четыре изолированных шага: генерацию текстовой идеи исследования (generate_ideas.py), автоматическое прототипирование кода с запуском расчетов на графических ускорителях (perform_experiments.py), сборку итогового манускрипта в типовом шаблоне template.tex (generate_paper.py) и, наконец, финальную оценку статьи (review_paper.py), где большая языковая модель имитирует роль строгого рецензента престижной конференции.
Ключевой изъян всей конструкции становится очевиден при первом взгляде на логику модуля верификации в review_paper.py:
# Публичный фрагмент логики репозитория Sakana AI (review_paper.py)review_prompt = ( "You are an expert machine learning researcher reviewing a submission for ICLR. " "Evaluate the paper based on novelty of hypothesis, empirical soundness of experimental results, " "clarity, and mathematical precision. Assign a score from 1 to 10 and provide critical peer review comments.")response = client.chat.completions.create( model="claude-3-5-sonnet", messages=[{"role": "user", "content": review_prompt + "nn" + paper_text}])С позиций теории управления, прикладной математики и кибернетики (паспорт специальности 2.3.1) здесь заложена фундаментальная методологическая ошибка: авторегрессионный каскад ошибок (Autoregressive Error Cascade) при полном отсутствии независимого детерминированного контура заземления (Grounding).
Вся цепочка исследований замкнута исключительно на статистические предположения нейросети. Стохастический генератор токенов формулирует текстовую гипотезу, затем стохастический генератор пишет вычислительный код, а в качестве верховного судьи выступает та же самая стохастическая модель, которой через системный промпт приказано надеть академическую мантию строгой экспертной комиссии.
Математическая цена такого авторегрессионного замыкания драматична. Пусть вероятность локальной физической и логической корректности одного шага рассуждений составляет вполне оптимистичные  . Тогда сквозная вероятность получения истинного, непротиворечивого научного результата на четырех последовательных этапах неумолимо стремится к случайному подбрасыванию монеты:
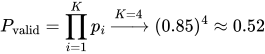
Даже если мы заменим базовые модели на современные reasoning-архитектуры или флагманские модели поколения GPT-6, где вероятность единичного логического квантования поднимается до  , проблема не исчезает. Реальный научный поиск в естественных науках требует разворачивания глубоких цепочек символьного вывода и замыкающих соотношений длиной в 15–20 промежуточных звеньев. На такой дистанции кумулятивная погрешность обесценивает вычисления:
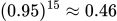 .
Корневая причина кроется в целевой функции языковых моделей. Архитектура Transformer оптимизирует статистическое правдоподобие текстовой последовательности <img class="formula inline" source="P(w_t mid w_{tau < t})" alt="P(w_t mid w_{tau , а вовсе не законы сохранения материального мира. В многомерном пространстве эмбеддингов формулы:
<img class="formula" source="E = m cdot c^3 quad text{или} quad Delta S_{text{изолир}} < 0" alt="E = m cdot c^3 quad text{или} quad Delta S_{text{изолир}}
выглядят для нейросети столь же легитимными и грамматически безупречными, как и подлинные законы Эйнштейна или Клаузиуса. В результате возникает опасный феномен академической мимикрии: манускрипт сверстан по всем канонам IEEE или Springer, изобилует интегралами и латинскими индексами, но математически описывает физически невозможные химеры.
Дефектоскопия: эмпирический аудит 150 сгенерированных гипотез
Чтобы получить объективную картину системных отказов чисто авторегрессионных моделей, исследовательская группа EvoNova Labs провела эмпирический стресс-тест представительной выборки из 150 научных манускриптов и формализованных уравнений. Материалы генерировались ведущими мировыми языковыми моделями и reasoning-пайплайнами в трех традиционно сложных междисциплинарных доменах: неравновесной термодинамике пористых композитов, гидродинамике турбулентных сред и кинетике многостадийных каталитических реакций. Каждая выдвинутая моделью гипотеза автоматически транслировалась в форму аналитического графа вычислений и пропускалась через наш детерминированный математический цензор, верифицирующий размерную однородность по Фурье, неотрицательность производства энтропии и асимптотическую устойчивость решений при вырождении параметров. Полученная картина распределения дефектов наглядно демонстрирует, почему автономный научный поиск без внешнего символьного ядра неизбежно терпит крушение.
Анатомия вычислительного брака: от размерного хаоса до термодинамического абсурда
Наиболее массовым классом системного брака, составившим 38.2% всех зафиксированных отказов, оказалось прямое игнорирование фундаментального принципа размерной однородности Фурье, сформулированного еще в 1822 году. Согласно этой аксиоме, в любом физически состоятельном уравнении каждое слагаемое обязано обладать тождественной размерностью в каноническом базисе первичных физических величин. Языковые модели регулярно нарушают этот баланс, комбинируя несоразмерные переменные ради создания визуально элегантной формулы. Например, при описании нестационарного теплопереноса в пористом композите при резком перепаде давления модель сгенерировала замыкающее соотношение потока тепла:
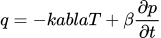
На первый взгляд данное уравнение выглядит вполне правдоподобно и напоминает классические феноменологические соотношения Онзагера. Однако простейшая подстановка базовых единиц Международной системы СИ вскрывает непреодолимый методологический конфуз: размерность пространственного градиента температуры составляет 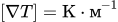 , тогда как производная давления по времени измеряется как
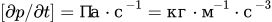 . Аддитивное сложение этих величин без введения искусственного размерного коэффициента
 с экзотической размерностью физически бессмысленно, а передача такого уравнения в вычислительный гидродинамический решатель приводит либо к мгновенному делению на ноль, либо к взрывной численной расходимости.
Вторым по масштабу источником брака, поглотившим 24.5% выдвинутых гипотез, стало прямое попрание второго начала термодинамики и неравенства Клаузиуса-Дюгема. Этот фундаментальный закон физики постулирует локальную неотрицательность производства энтропии в любых необратимых процессах ( ). Языковые модели систематически предлагают дифференциальные уравнения фазовых превращений или релаксации напряжений, в которых локальная энтропия замкнутой адиабатической системы самопроизвольно убывает без компенсирующего притока массы или энергии извне. Для нейросетевого генератора формулировка о спонтанном упорядочении структуры под действием внутреннего потенциала выглядит эстетически привлекательной и правдоподобной, однако в материальном мире подобные уравнения эквивалентны созданию вечного двигателя второго рода и полностью обесценивают моделирование.
Граничные сингулярности и каузальная слепота
Оставшаяся треть дефектов распределилась между нарушением предельных переходов (19.1%) и ложными статистическими корреляциями (18.2%). В области математической физики корректные феноменологические модели обязаны сохранять устойчивость и гладко переходить в фундаментальные классические асимптотики на границах расчетных областей. В ходе нашего аудита модели многократно синтезировали нелинейные реологические уравнения вязкоупругости, где при стремлении динамической вязкости к нулю ( ) внутреннее напряжение сдвига экспоненциально устремлялось в бесконечность вместо естественного перехода к пределу идеальной жидкости Эйлера. Запуск подобных сингулярных схем на расчетной сетке мгновенно разрушает итерационный процесс и приводит к бессмысленной потере дорогостоящего машинного времени на суперкомпьютерных кластерах.
Не менее опасной патологией является органическая неспособность авторегрессионных сетей отличать пассивную статистическую ассоциацию  от подлинного каузального воздействия, формализуемого Do-исчислением Джудеи Перла. Обучаясь на неструктурированных массивах научных статей, модель подхватывает фантомные корреляционные связи и пытается оперировать дискретными сущностями как гладкими физическими полями. Показательным примером из наших тестов стала попытка связать удельную каталитическую активность бинарного сплава с атомным номером элемента в таблице Менделеева: языковая модель интерпретировала целочисленный номер как непрерывную дифференцируемую величину и начала добросовестно рассчитывать частные производные активности по атомному номеру, галлюцинируя существование непрерывного спектра дробных химических элементов между платиной и золотом.
Мировой ландшафт DeepTech: три парадигмы автоматизации открытий
Чтобы объективно оценить текущее состояние отрасли и определить место различных архитектурных школ на пути к суверенной автономии открытий, необходимо сопоставить ведущих глобальных игроков. Сегодня в индустрии DeepTech четко оформились три конкурирующие парадигмы: статистические нейросетевые суррогаты, текстовые авторегрессионные агенты и роботизированные аппаратные платформы.
Парадигма суррогатных оракулов и оптимизации кода: уроки DeepMind, FunSearch и PhysicsX
Первое магистральное направление возглавляет исследовательская группа Google DeepMind благодаря выдающимся успехам AlphaFold в структурной биологии, GNoME в кристаллографии и FunSearch в комбинаторной оптимизации. В сходном ключе развиваются специализированные платформы инженерного моделирования PhysicsX и Ansys SimAI, применяющие графовые нейросети (GNN) и физически информированные сети (PINN) для ускорения гидрогазодинамических расчетов в миллионы раз. Сильной стороной этой парадигмы является непревзойденная скорость аппроксимации сложных многомерных поверхностей и оптимизации заданных скалярных функций. Однако эти системы функционируют по принципу непрозрачного оракула: они превосходно предсказывают статическую конформацию макромолекулы или локальное поле давлений в знакомой расчетной области, но фундаментально не способны вывести аналитическое замкнутое уравнение или сформулировать закон сохранения. Более того, при выходе геометрии или параметров потока за пределы обучающего распределения (эффект Out-of-Distribution) суррогаты драматически теряют точность и страдают нефизичными артефактами. В противоположность слепому численному перебору, архитектура EvoNova Labs осуществляет аналитический вывод первых интегралов движения de novo, обеспечивая строгую физическую интерпретируемость и глобальную устойчивость в предельных режимах.
Авторегрессионные агенты, аппаратные барьеры и классический расчетный софт
Вторую парадигму олицетворяет стартап Sakana AI со своей флагманской платформой The AI Scientist, а также исследовательские ассистенты FutureHouse (проекты PaperQA и ChemCrow). Их подход опирается на сквозную оркестрацию языковых моделей, берущих на себя планирование экспериментов, генерацию кода и автоматическую верстку препринтов. Как показал наш эмпирический аудит, ставка на чисто текстовую генерацию без детерминированного заземления оборачивается 41% брака, а саморецензирование силами той же LLM лишь закрепляет псевдонаучные галлюцинации. Ассистенты класса FutureHouse превосходно справляются с компиляцией библиографии и вызовом внешних библиотек, но принципиально ограничены поиском по уже накопленным человечеством знаниям.
На противоположном полюсе располагаются роботизированные синтетические лаборатории, ярким представителем которых выступает Periodic Labs. Их ставка сделана на перенос интеллекта в материальный мир через автоматизированные химические реакторы для синтеза кристаллических структур. Физический эксперимент здесь выступает абсолютным критерием истины, однако лаборатория жестко зажата узкими рамками материаловедения и лишена универсального математического аппарата для моделирования гидродинамики или квантовых систем. Наконец, ветераны индустрии молекулярного моделирования в лице Schrödinger, Inc. опираются на фундаментальные квантовохимические расчеты (DFT, FEP+), однако их инструментарий требует участия целой армии высококвалифицированных экспертов для ручной подготовки сеток и граничных условий. Концептуальный фокус EvoNova Labs объединяет высокую эвристическую продуктивность искусственного интеллекта со строгостью фундаментальной физики, замыкая исследовательский цикл без участия человека.
Сводная матрица архитектур мировой DeepTech-индустрии
Обобщим результаты сравнительного анализа ведущих мировых экосистем в единую архитектурную матрицу:
DeepTech-экосистема
Доминирующий подход
Автономия
Архитектурный фокус EvoNova
Google DeepMind
Суррогатные нейросети + генетический код
L1–L3
Аналитический вывод замкнутых уравнений de novo
Sakana AI
Авторегрессионная оркестрация через LLM
L4
Двухконтурный цензор с нулевым физическим браком
Periodic Labs
Роботизированный синтез кристаллов
L3
Универсальный кросс-отраслевой аппарат инвариантов
FutureHouse
RAG-агенты поиска и вызова внешних API
L2
Генерация новых фундаментальных законов
Insilico Medicine
Генеративные диффузионные био-модели
L3
Охват механики сплошных сред и динамических систем
Schrödinger, Inc.
Классический расчетный софт (FEP+, DFT)
Софт
Полный замкнутый автономный цикл без оператора
PhysicsX / SimAI
Суррогатные аппроксиматоры CFD/FEA
L1
Строгая экстраполяция на базе законов сохранения
Эволюционный континуум: от узких нейро-оракулов к суверенному исследователю
Для строгой классификации систем искусственного интеллекта в фундаментальных исследованиях по аналогии со стандартами беспилотного транспорта SAE International (J3016) в лаборатории EvoNova была формализована пятиуровневая таксономия исследовательской автономии.
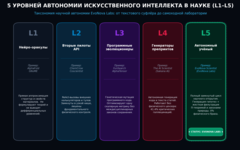 5 уровней автономии искусственного интеллекта в науке (L1–L5)
: эволюционный переход от узких оракулов к суверенным исследовательским системам
Эволюционный путь автономии открывается базовыми уровнями L1–L3, где интеллект выступает вспомогательным ускорителем отдельных прикладных подзадач. На начальном уровне нейро-оракулов (L1, представленном AlphaFold и GNoME) модели решают задачи аппроксимации многомерных функций, прогнозируя геометрию белков или стабильность сплавов, но остаются полностью слепы к аналитической логике физических законов. На втором уровне вторых пилотов (L2, проекты ChemCrow и Coscientist) языковые модели получают доступ к внешним базам реакций и API-инструментам, автоматизируя типовой синтез, но все еще не обладают внутренним пониманием физических инвариантов. Переход к программным эволюционерам (L3, системы FunSearch и AlphaTensor) ознаменовал появление алгоритмического творчества, где мутации программного кода оптимизируют дискретные комбинаторные структуры, однако поиск ведется под изолированный скалярный критерий без учета непрерывных законов механики сплошных сред.
Качественный водораздел пролегает между четвертым и пятым уровнями исследовательской автономии. Уровень генеративных писцов (L4, олицетворяемый платформой The AI Scientist) впервые замкнул полный цикл от генерации идеи до верстки LaTeX-препринта и виртуального рецензирования. Однако ввиду отсутствия детерминированного физического заземления этот уровень стал опасной ловушкой академической мимикрии: более 41% манускриптов содержат замаскированные антинаучные галлюцинации. Подлинным преодолением этой проблемы является наивысший пятый уровень (L5, реализованный в архитектуре EvoNova Scientist), обеспечивающий суверенную замкнутую автономию открытий. На уровне L5 стохастический поток гипотез немедленно подчиняется жесткой фильтрации через алгебру размерностей Бэкингема, фазовые инварианты Лиувилля и каузальное Do-исчисление Перла, формируя верифицированные замкнутые уравнения с математически гарантированным отсутствием физических аномалий.
Архитектурный ответ: Двухконтурная система System 1 + System 2
В фундаментальной когнитивной психологии лауреат Нобелевской премии Даниэль Канеман описал двухкомпонентную модель человеческого мышления. Быстрая, эвристическая и ассоциативная система (System 1) мгновенно распознает образы и порождает интуитивные догадки. Медленная, строгая и логическая система (System 2) берет на себя тяжелый труд дедуктивного расчета, математического доказательства и строгой верификации фактов.
Фатальный системный изъян архитектуры Sakana AI и большинства современных генеративных систем заключается в бесплодной попытке заставить науку работать исключительно на механизмах System 1. Языковой модели поручают всё: от интуиции до проверки истинности.
В платформе EvoNova Scientist реализовано строгое нейро-символическое разделение труда между двумя независимыми контурами:
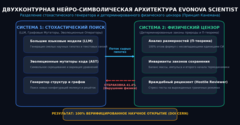 Двухконтурная нейро-символическая архитектура: System 1 + System 2
Двухконтурная архитектура: System 1 (стохастический генератор гипотез) + System 2 (детерминированный символический цензор)
Первый контур (System 1) опирается на колоссальную ассоциативную память больших языковых моделей, аккумулировавших миллионы научных публикаций за всю историю человечества. Мы используем нейросеть исключительно как эвристический генератор гипотез, способный сопоставлять неочевидные концепции из далеких научных областей. Но мы принципиально лишаем LLM права выносить вердикт о физической корректности выдвинутых идей.
Второй контур (System 2) представляет собой детерминированный символический цензор. Сгенерированная гипотеза моментально транслируется в форму абстрактного синтаксического дерева (AST) и графа связей. Если предложенное аналитическое выражение нарушает размерную однородность, закон сохранения импульса или базовые термодинамические неравенства, цензор отбраковывает его за считанные миллисекунды на CPU, экономя колоссальные вычислительные мощности суперкомпьютерных кластеров.
Математический аппарат детерминированного цензора
Каким образом символьный цензор System 2 осуществляет мгновенную дисквалификацию некорректных уравнений без привлечения человека? Рассмотрим математические основания трех ключевых фильтров верификации.
П-теорема Бэкингема и размерная факторизация (Buckingham Pi Theorem)
Пусть исследуемый физический процесс описывается набором из  размерных физических переменных:
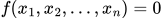
Каждая из этих величин выражается через  независимых фундаментальных размерностей выбранного физического базиса (в системе СИ: Масса
 , Длина
 , Время
 , Температура
 , Сила тока
 , Количество вещества
 ). Тогда размерность любой переменной
 однозначно задается вектором показателей степеней в -мерном пространстве:
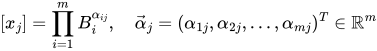
На основе этих векторов формируется фундаментальная матрица размерностей задачи:
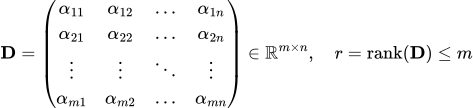
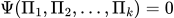
Согласно  -теореме Бэкингема (1914 г.), уравнение является размерно однородным тогда и только тогда, когда оно может быть представлено в виде функциональной зависимости от
 независимых безразмерных комплексов подобия:
Каждый такой комплекс  соответствует вектору степеней
 , который строго принадлежит ядру (nullspace) матрицы размерностей
 :
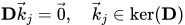
В процессе анализа сгенерированного LLM уравнения символический дифференциатор раскладывает все аддитивные члены выражения по каноническому базису ядра матрицы размерностей. Если для слагаемых  и
 обнаруживается несовпадение векторов размерностей (
 ), цензор генерирует отказ
CRITICAL ERROR: DIMENSIONAL_INHOMOGENEITY. Уравнение отбрасывается со стопроцентной математической строгостью за микросекунды до старта численных расчетов.
Гамильтоновы инварианты фазового пространства и балансовые уравнения сохранения
Для любых консервативных динамических систем фундаментальным критерием физической реализуемости выступает теорема Лиувилля о сохранении фазового объема и неизменность первого интеграла движения — функции Гамильтона 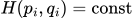 вдоль эволюционных траекторий:
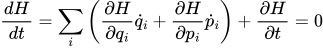
Символический цензор в автоматическом режиме контролирует выполнение балансов энергии ( ) и импульса (
 ) в замкнутых системах, лишенных внешних диссипативных стоков или притока накачки. Это позволяет начисто отсекать разностные схемы и дифференциальные конструкции, страдающие нефизической накачкой энергии из численного шума. Одновременно анализируется глобальная устойчивость фазовых портретов, что гарантирует защиту от внезапной взрывной расходимости решений.
Каузальный стресс-тест гипотез: Do-исчисление Джудеи Перла (Causal Grounding)
Чтобы победить проблему псевдокорреляционного шума, составляющего более 18% в структуре дефектов чисто генеративных моделей, в контур верификации интегрирован каузальный стресс-тест на базе математической теории Do-исчисления Джудеи Перла.
Для каждой сгенерированной гипотезы алгоритм автоматически реконструирует направленный ациклический граф (DAG) предполагаемых взаимосвязей между параметрами среды. Далее запускается анализ условий  -разделения (-separation) и критерия «задней двери» (Backdoor Criterion) для изоляции скрытых конфаундеров
 :
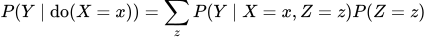
Если обнаруженная языковой моделью статистическая зависимость между переменными коллапсирует при искусственной фиксации промежуточных факторов, гипотеза признается иллюзорным корреляционным артефактом и аннулируется до запуска натурных испытаний.
Эмпирические результаты и открытый депонированный препринт
Эффективность внедрения двухконтурного детерминированного цензора была подтверждена серией масштабных вычислительных экспериментов в платформе EvoNova Scientist. Полученные результаты демонстрируют качественный отрыв от существующих мировых аналогов:
Метрика верификации
The AI Scientist (Sakana AI, L4)
Детерминированный контур (EvoNova Labs, L5)
Доля физических дефектов
41.4%
менее 1.8% (на краевых сингулярностях)
Контроль размерностей
❌ Отсутствует (только промпт)
✔ Полная проверка ранга матрицы размерностей
Законы сохранения
❌ Отсутствует
✔ Гамильтоновы балансы и Do-исчисление
Стоимость гипотезы
~180 долл. (слив вычислений на брак)
~12 долл. (мгновенная отсечка брака на CPU)
Статус подтверждения
Черновик в LaTeX с ошибками
In-Silico TRL 4–5 (депонированный протокол)
Для обеспечения международного научного приоритета и предоставления мировому академическому сообществу возможности независимой верификации результатов, фундаментальная концепция и архитектурная спецификация платформы депонированы на серверах Европейской организации по ядерным исследованиям в Женеве (CERN Zenodo).
Полный препринт исследования опубликован под названием «EvoNova Scientist: A Neuro-Symbolic Multi-Agent Framework for Physical Constraint-Preserving Autonomous Scientific Discovery» (авторы: Roman Pokushko, Mariia Pokushko, EvoNova Labs) и доступен по постоянному международному цифровому идентификатору DOI: 10.5281/zenodo.23942797.
Ограничения исследования и открытые вызовы (Disclosure of Limitations)
В полном соответствии с академическими стандартами научной добросовестности необходимо четко очертить текущие границы применимости предложенного подхода.
Во-первых, определенную сложность сохраняют сингулярные физические системы с дробными степенными скейлингами — например, законы развитой турбулентности Колмогорова с показателями спектральной плотности вида  . В подобных краевых режимах матричный аппарат размерностей требует построения расширенных дробных базисов и привлечения специализированных представлений групп Ли.
Во-вторых, все представленные в исследовании результаты верифицированы на уровне строгой компьютерной симуляции и символьной математической валидации (уровень технологической готовности TRL 4–5). Финальным критерием истины для любых теоретических моделей всегда остается практический натурный эксперимент в лабораториях материаловедения и гидродинамики наших академических и индустриальных партнеров.
Заключение
Попытка свести фундаментальную науку к слепому авторегрессионному предсказанию очередного текстового токена — это тупиковая ветвь эволюции искусственного интеллекта. Большие языковые модели незаменимы как генераторы смелых интуитивных догадок и ассоциативных связей, но они органически лишены внутреннего компаса физической истины.
Будущее надежного DeepTech и автономных научных открытий принадлежит гибридным нейро-символическим системам пятого уровня автономии (Level 5), где бурная эвристическая фантазия нейросетей дисциплинируется нерушимыми законами сохранения материального мира.
В связи с этим хотелось бы адресовать инженерному и научному сообществу Хабра два фундаментальных вопроса: сталкивались ли вы в своих прикладных исследованиях с нефизичным поведением LLM при генерации уравнений или расчетного кода, и согласны ли вы с тем, что даже перспективные флагманские модели поколения GPT-6 математически обречены накапливать критические ошибки без жесткого символьного ядра верификации System 2? Будем рады конструктивной дискуссии в комментариях.
Источник: habr.com