
1. Введение
Инфраструктура вывода больших языковых моделей традиционно оптимизируется по пропускной способности и задержке: KV-кэш, CUDA-графы, батчинг, квантизация, параллелизм. Эти компоненты формируют «скелет» системы и задают её предельные характеристики. Однако за пределами этого фокуса нередко остаётся слой, определяющий не скорость, а качество. Это параметры семплирования — правила выбора следующего токена из распределения логитов на каждом шаге декодирования.
Смещение приоритетов объяснимо: эти параметры не влияют на ядро инференса, память или число обслуживаемых запросов. Но их недооценка обходится дорого: система, безупречная по throughput и latency, с неоткалиброванным декодированием уходит в повторы, обрывает рассуждение, теряет формат ответа или в RAG-сценариях порождает правдоподобные, но не подкреплённые источниками утверждения. Формально она «работает», но не находится в боевом состоянии.
Статья разбирает параметры семплирования на понятном и простом языке — их математическую природу, взаимодействие и роль в разных режимах (чат, reasoning, RAG) — на примере OpenWebUI + vLLM, где параметры управляются динамически в зависимости от включённого поиска или режима рассуждения.
2. Базовые понятия: логиты, распределение и акт выбора
2.1. Логиты
Языковая модель не выдаёт готовое слово. На каждом шаге она получает уже написанный текст x1:t («Я люблю пить по утрам горячий…») и возвращает вектор логитов — по одному числу на каждый токен из словаря . Словарь (V - vocabulary) современных моделей — это обычно от десятков тысяч до двухсот тысяч токенов, так что логитов на каждом шаге тоже столько же. Логит zi — это просто число, которое показывает, насколько модель «склоняется» к токену i (например, слово «чай» — 10 баллов, «кофе» — 9 баллов и тд). Это ещё не вероятность: логиты могут быть отрицательными, большими, маленькими, и их сумма ни к чему не привязана. Их абсолютные значения зависят от внутренней нормировки модели, поэтому сравнивать логиты между разными запросами напрямую нельзя.
2.2. Вероятность
Чтобы получить распределение вероятностей над словарём, к логитам применяется операция softmax:
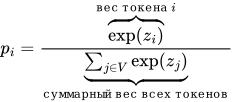 Про распределение вероятностей
Почему вес токена i это exp(zi). Потому что логиты бывают отрицательные, а веса нет (доля не может быть отрицательной). Сохраняет порядок и подчёркивает разницу. Если z1 > z2, то и exp(z1) > exp(z2). При этом разница в логитах превращается в разницу в разы: логит, который больше на 1, даёт вес в e раз больше . Модель как бы «усиливает» своего лидера.
Соответсвенно суммарный вес всех токенов это сумма exp(zi).
Теперь каждое pi — это вероятность того, что следующим токеном будет токен i, и все pi вместе дают единицу. Важно помнить: это оценка модели, а не «истина». Если модель уверена (например, после «Столица Франции — »), распределение имеет ярко выраженный пик на слове «Париж». Если контекст допускает много равноправных продолжений, распределение становится плоским, и вероятности распределяются между десятками кандидатов.
2.3. Декодирование
Генерация — это цикл (упрощенно):
-
модель выдаёт распределение вероятностей над словарём →
-
из него выбирается один следующий токен →
-
токен добавляется к контексту →
-
модель прогоняется снова →
-
выбирается следующий токен →
-
и так до стоп-условия (специальный токен конца, лимит длины, стоп-строка).
Ключевая операция на каждом шаге — выбор одного токена( x̂ ) из распределения. Существует два принципиально разных способа этот выбор сделать:
-
Детерминированный (greedy / argmax): всегда берётся токен с максимальной вероятностью. Один и тот же контекст всегда даёт один и тот же ответ.
-
Стохастический (сэмплирование): токен берётся случайно в соответствии с распределением, x̂ ∼ p (выбран случайно в соответствии с распределением p). Именно этот режим и настраивают параметры семплирования.
2.4. Параметры семплирования
Параметры семплирования — это набор правил, которые преобразуют исходное распределение p перед выбором токена. Каждое правило отвечает на свой вопрос:
-
Temperature — насколько «острым» или «плоским» сделать распределение в целом.
-
Top-k — сколько наиболее вероятных токенов вообще допустить к выбору.
-
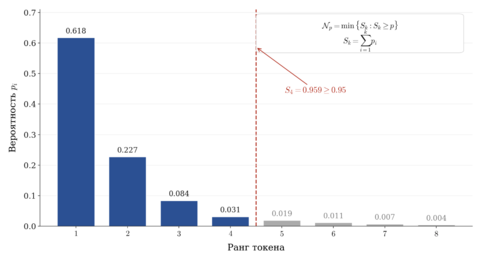
Top-p (nucleus) — какую долю суммарной вероятностной массы сохранить, отбросив хвост.
-
Min-p — насколько вероятным должен быть токен относительно лидера, чтобы остаться в рассмотрении.
-
Typical sampling — насколько «типичной» по информативности должна быть вероятность токена.
-
Штрафы за повторения (repetition / frequency / presence penalty) и DRY — как скорректировать логиты уже встречавшихся токенов или фрагментов.
-
Mirostat — как поддерживать целевую «сюрпризность» генерации на длинной дистанции.
Факт, которое часто упускается: эти правила независимы как понятия, но не независимы как операции. Раскроем его ниже.
Здесь есть тонкость, которую часто упускают. Каждый параметр можно определить сам по себе: чтобы объяснить temperature, не нужно знать, что такое top-p, и наоборот. В этом смысле они независимы как понятия — каждый представляет собой отдельный, замкнутый рецепт преобразования распределения.
Но в реальном пайплайне они применяются последовательно, и результат каждого шага становится входом для следующего. Это и означает «не независимы как операции»: top-p работает не с исходным распределением модели, а с тем, которое уже получилось после temperature. Поэтому смысл top-p меняется в зависимости от Temperature хотя само определение top-p никак не упоминает температуру.
В vLLM (V1 sampler) порядок применения зафиксирован и описан в официальной документации модуля
vllm.v1.sample.sampler: сначала применяются штрафы (penalties), затем внутри методаsample—temperature, затемmin-p, затемtop-kи/илиtop-p, и в конце — собственно сэмплирование.Источник: habr.com