
На днях мне попался ставший вирусным твит, в котором говорилось, что люди, жалующиеся на то, что большие языковые модели (LLM) порождают медленный и раздутый код, ещё будут кусать локти, когда всё перепишут на сверхоптимизированном ассемблере. Мы пока не настолько продвинулись, чтобы захотеть писать всё на ассемблере, но нечто похожее на то, что Нолан Лоусон сказал о тестировании (теперь вы сами можете выбирать, сколько ошибок вам нужно), а я сформулировал менее изящно, становится всё более справедливым и в отношении производительности.
В ответ на комментарий к моей предыдущей статье о том, что стоимость работ по оптимизации производительности, которые раньше требовали узкоспециализированных навыков, снизилась на многие порядки, а задачи, для которых прежде требовался специалист или целая команда с редким набором компетенций, теперь может выполнять любой, кто способен набрать несколько предложений1, и значит, теперь можно применять самые разные оптимизации, которые раньше были слишком дороги и не окупались нигде, кроме крупнейших или наиболее прибыльных проектов, Марк Брукер ответил следующим образом:
Полностью согласен с вашим заключительным тезисом. Вполне вероятно, что в итоге мы придём к динамически создаваемому специализированному ПО, подогнанному под конкретную рабочую нагрузку, а не под целый класс нагрузок. (А это, в свою очередь, открывает массу интересных возможностей и несёт самые разные риски.) Это чем-то напоминает мне FFTW. А ещё — множество необычных старых трюков демосцены, суть которых заключалась в том, чтобы добиться максимальной скорости и компактности при решении какой-то одной очень специфической задачи (зачастую ещё и на конкретном оборудовании). Например, помню одно демо, в котором код использовался ещё и в качестве текстур, чтобы добиться высокой локальности данных в кэше.
1 Впрочем, как мы обсуждали в том посте, а также ранее, навыков моделей SOTA в проведении бенчмаркинга и разработке экспериментальных методик пока недостаточно, чтобы справляться с такими задачами в общем случае без участия человека (или скилла), который подготовит для агента среду для проведения бенчмарков.
А Майкл Мэлис отметил следующее:
Распространился мем о том, что ИИ бесполезен, потому что «написание кода никогда не было самой сложной частью». Думаю, в одних областях это действительно так, но в других написание кода и в самом деле было самой трудной задачей. Отличный пример — это JIT-компиляторы. Для многих программ JIT-компилятор мог бы существенно ускорить выполнение кода. То, что JIT-компиляторы встречаются так редко, наводит меня на мысль, что раньше их реализация была настолько сложной, что затраты просто не окупались. LLM снизили порог входа и значительно упростили разработку JIT-компиляторов. Именно благодаря этому возник проект pgrust. Исторически самым сложным в разработке видом ПО были базы данных, и именно это ограничивало их развитие. Теперь, с появлением ИИ, мы можем позволить себе более амбициозные проекты и создавать программное обеспечение, которое раньше реализовать было не под силу.
Оптимизация под класс нагрузок
Давайте проверим эту идею на примере движка регулярных выражений FRE, о котором я говорил в своей предыдущей статье. Напомню, что он появился в результате месячной работы агента, которому поручили повысить производительность движка регулярных выражений и предоставили доступ к набору бенчмарков rebar для сравнения быстродействия. В итоге FRE оказался настолько переобучен под rebar, что фактически подгонялся под результаты этого набора бенчмарков. Мы предупредили агента, что у нас есть контрольный бенчмарк, результаты которого ему неизвестны. После этого агент обобщил оптимизации в достаточной степени, чтобы производительность на контрольном бенчмарке стала приемлемой. Нет особого смысла использовать движок регулярных выражений, созданный на такой «фабрике ПО», если на контрольных бенчмарках он не превосходит хорошо протестированный движок. Однако у FRE была одна примечательная особенность: нативная AOT-скомпилированная версия показывала очень хорошие результаты при поиске по длинным строкам. Мы обратили на это внимание и решили, что можно запустить компилятор нативного кода в отдельном потоке, пока ripgrep продолжает работать со своим обычным механизмом поиска, а после завершения компиляции переключиться на нативный код. В целом это должно повысить производительность. Разумеется, на коротких запросах производительность, скорее всего, снизится: один из потоков будет занят компиляцией. Но для меня гораздо важнее, сколько времени ripgrep тратит на поиск, который длится многие секунды или минуты, чем на поиск, занимающий всего несколько секунд. Поэтому такой компромисс меня устраивает.
Точно так же, как мы смогли создать движок регулярных выражений всего за несколько минут человеческого времени, мы можем потратить ещё несколько минут на подобный эксперимент. Я набросал несколько предложений, и агент взялся за работу: внёс необходимые изменения в код (у человека это потребовало бы довольно серьёзной переработки) и запустил бенчмарки на реальных поисковых запросах ripgrep, взятых из истории моих сеансов работы с Codex. На нескольких очень простых длинных запросах мы видим рост производительности в 2–4 раза. Однако большинство запросов сложнее, и при тестировании на репрезентативных контрольных запросах для тех из них, где следует включать AOT-компиляцию2, мы получаем ускорение примерно на 7%.
2 Как показывают результаты наших прежних бенчмарков, даже с учётом времени, затрачиваемого на компиляцию, во многих случаях версия, скомпилированная в нативный код, работает медленнее, чем крейт регулярных выражений Rust. Если разобраться в причинах, выяснится, что обычно речь идёт о более сложных запросах, для которых крейт регулярных выражений Rust использует алгоритмические оптимизации, тогда как компилятор нативного кода FRE прибегает к наивным решениям. (Агент, создавший FRE, потратил на компилятор нативного кода гораздо меньше времени, чем на «обычный» движок регулярных выражений.)
Результат, конечно, не потрясающий, но и не плохой, если учесть, что на всё ушло всего несколько минут, пока я набирал запросы для Codex. К тому же агент продолжает оптимизировать код, так что, вероятно, производительность ещё вырастет.
Создать индекс?
Можно сказать, что это довольно бессмысленное занятие: если мы постоянно ищем текст на компьютере, то очевидный способ ускорить поиск — не писать компилятор нативного кода для сопоставления с регулярными выражениями, а создать индекс. Но здесь важно другое: подобную техническую работу, которая раньше требовала немало времени и специальных знаний, теперь можно выполнять практически без усилий. А если бы мы захотели создать текстовый индекс, то нам бы повезло в том, что я работал над BitFunnel — поисковым индексом Bing, оптимизированным для постоянного и быстрого добавления текста, за который на конференции SIGIR присудили награду за лучшую статью (Best Paper Award). Поэтому я могу предложить несколько экспериментов, которые стоило бы провести, если мы решим создать быстрый локальный индекс всего содержимого компьютера. Известные мне проекты такого рода предназначены для индексации каталогов с исходным кодом, но больше всего производительность моего компьютера страдает, когда Codex решает запустить ripgrep для поиска по огромным временным каталогам, содержащим множество сгенерированных файлов, а затем, ничего не найдя, расширяет область поиска до всего компьютера. Поэтому мне нужен индекс всего диска, а не только исходного кода отдельных проектов.
Если бы я работал ИИ-лаборатории и имел доступ моделям SOTA, работающим на чипах Cerebras или других ускорителях, которые значительно повышают скорость генерации токенов в секунду, а следовательно, и соотношение загрузки/спроса для поисковых запросов, я, возможно, действительно изучил бы существующие индексаторы, чтобы выяснить, достаточно ли они быстры или стоит разработать собственное специализированное решение. В открытой версии BitFunnel есть «всего лишь» интерпретатор байткода и один JIT, а в версии, используемой Bing, их несколько. Раньше проект с таким уровнем оптимизации потребовал бы огромных усилий, но теперь фраза «справлюсь с этим за выходные» действительно применима к некоторым проектам такого рода. С моим скромным тарифом за 200 долларов в месяц мне вполне хватит немного ускоренного ripgrep и какого-нибудь готового индексатора. Так что разработку быстрого индекса всего содержимого компьютера с высокой скоростью добавления данных, возможно, стоит оставить в качестве «упражнения для читателя (который работает в ИИ-лаборатории)».
Оптимизации — это дёшево
Резкое снижение стоимости оптимизации стало реальностью ещё в ноябре 2025 года, а возможно, с общедоступными моделями это произошло даже несколько раньше (и уж наверняка раньше для тех, кто работал с инструментами, доступными сотрудникам ИИ-лабораторий). Пример из эпохи GPT-5.1 или 5.2: ничего не зная об игровых ИИ, я попробовал создать ИИ для настольной игры Azul. В итоге он оказался сильнейшим в мире с довольно большим отрывом.
Изучив диссертацию, в которой описан второй по силе ИИ, я пришёл к выводу, что мой ИИ, вероятно, немного лучше именно в том, что касается собственно искусственного интеллекта. Но главное его преимущество — оптимизация. При этом у меня на разработку, судя по всему, ушло примерно на два порядка меньше времени (я оцениваю это по диссертации, описанному в ней процессу и сравнению с тем, как работал я). Кроме того, большую часть времени я работал на ноутбуке, тогда как у авторов второго ИИ был целый кластер машин. Это означает, что у меня было гораздо меньше вычислительных ресурсов для проведения экспериментов, настройки параметров и прочего.
Например, тот ИИ использует один поток, а мой — несколько. У меня есть версия с нативным кодом, а также ужасная реализация на JavaScript с общей памятью WebAssembly. Кроме того, для двух разных версий я использую две разные архитектуры поиска, каждая из которых требует своего подхода к многопоточности (минимакс для очень маленькой и быстрой нейросети и MCTS для более крупной); при работе вручную для реализации этого потребовалось бы довольно много усилий.
И поскольку пару раз я позволил LLM выбрать алгоритм многопоточности, основываясь на его собственных (ошибочных) рассуждениях, прежде чем потратил полчаса на самостоятельное изучение алгоритмов многопоточности для игровых ИИ, мне в итоге пришлось несколько раз переписывать алгоритм многопоточности (точнее, поручать Codex переписывать его заново).
Для отладки и проверки многопоточного алгоритма в такой задаче есть целый набор стандартных приёмов; например, можно реализовать воспроизведение выполнения по логам отладки, чтобы удавалось повторно воспроизводить ошибки, несмотря на недетерминированность алгоритма.
Если бы я делал это вручную, только на одну такую задачу, вероятно, у меня ушло бы от нескольких дней до недели. Но это как раз тот тип работы, который агент может без труда выполнять в цикле: он пытается воспроизвести выполнение по логам и каждый раз, когда точное воспроизведение не удаётся, добавляет логирование, позволяющее выявить источники недетерминированности. Теперь мы избавились от большой доли утомительной работы, которую раньше приходилось выполнять для реализации такой сложной оптимизации.
Это касается и многих других сложных оптимизаций. Я писал микрокод для процессоров, занимался верификацией процессоров, работал над оптимизацией поискового индекса и выполнял множество других задач, поэтому довольно часто я видел оптимизацию и думал: «Хм, это повысит производительность на 2%, но на проверку работоспособности такой хитрой оптимизации уйдёт N человеко-дней». И уже исходя из того, оправдывает ли результат затраченные усилия, принимал решение, стоит ли за неё браться. Теперь, когда это N сократилось в огромное количество раз (величина сокращения зависит от задачи, но если считать затраченное человеком время, то нередко речь идёт об уменьшении в 1000, 10000 или даже 1000000 раз), количество оптимизаций такого рода, за которые имеет смысл браться, резко возрастает. Если же сравнивать стоимость токенов по тарифам с оплатой за фактическое потребление и затраты инженера Bing, написавшего JIT-компиляторы для поискового индекса, то сокращение в денежном выражении, вероятно, будет ближе к тысячекратному. То же самое относится к оптимизациям, в успехе которых нет уверенности. Раньше я иногда смотрел на очередную идею, не зная, даст ли она прирост производительности, и думал: «На реализацию уйдёт M часов, прежде чем мы получим достаточно надёжные результаты измерений, чтобы хотя бы оценить её влияние на быстродействие». Теперь имеет смысл пробовать гораздо больше таких оптимизаций.
Вернёмся к случаю с игровым ИИ: по крайней мере, в случае с ИИ, который я разрабатывал, каждое удвоение скорости даёт примерно 100 пунктов Эло (больше, чем в шахматах; вероятно, потому что в Azul ничьи случаются крайне редко). Одного лишь добавления многопоточности достаточно, чтобы разгромить на мощной машине другой ИИ с сопоставимыми характеристиками, но без многопоточности. Если же добавить ещё 10–20 оптимизаций, которые большинству разработчиков покажутся слишком трудозатратными для ручной реализации, разница в силе игры станет колоссальной; поэтому рукописному ИИ будет бессмысленно стараться догнать3.
3 Не сомневаюсь, что ИИ, написанный вручную человеком, действительно разбирающимся в искусственном интеллекте, например, автором одного из лучших в мире движков для игры в го или шахматы, мог бы превзойти мой ИИ за счёт более высокого качества самой ИИ-составляющей. Ведь я, ничего не знающий об искусственном интеллекте, не смог бы создать ИИ того же уровня. Но если уровни компетенции разработчиков хотя бы примерно сопоставимы, то при одинаковых затратах времени версия, написанная с помощью LLM, будет безоговорочно превосходить версию, созданную вручную.
С игровыми ИИ всё немного проще, чем с большинством другого ПО; в нём многие оптимизации, которые мы хотим внедрить, действительно меняют результат работы алгоритма. При этом нет простого и дешёвого способа определить, приводит ли сочетание прироста скорости и изменения результата к улучшению или ухудшению результатов на практике. И, как мы отмечали ранее, современные публичные модели SOTA довольно плохо справляются с планированием экспериментов, поэтому мне пришлось самостоятельно настроить инфраструктуру, которую разработчики использовали для оценки эффективности оптимизаций. Но как только она была готова, задача стала ничем не отличаться от любой другой задачи оптимизации. Думаю, тем, кто занимается оптимизацией LLM, тоже приходится сталкиваться с подобными проблемами, но большинство задач оптимизации устроены гораздо проще.
Ещё один пример: в рамках подготовки к собеседованиям по оптимизации производительности Джейми Брэндон попробовал решить опубликованное тестовое задание Anthropic. Выполнив часть работы самостоятельно, он поручил Claude продолжить с того места, на котором остановился, и тот добился гораздо лучшего результата. Когда Джейми посмотрел, что именно сделал Claude такого, до чего он сам не додумался, выяснилось, что многие оптимизации приходили ему в голову, но он просто не успел до них добраться. «Остальное же было просто безумными штуками, которые я бы никогда не стал пробовать, если бы не занимался этой задачей несколько недель»4. Джейми — вполне компетентный инженер по оптимизации производительности, которому удалось получить предложение о работе на желаемую должность, но в чётко сформулированной задаче оптимизации у него практически нет шансов против достаточно хорошей модели. (Я сам не пробовал решать эту задачу, но подозреваю, что при сколько-нибудь сопоставимых временных ограничениях у меня тоже не было бы шансов.)
4 Можно возразить, что сравнивать результаты агента, продолжившего работу с того места, где остановился Джейми, не совсем честно: его наработки служат отправной точкой и могут позволить агенту добиться гораздо лучших результатов, чем он получил бы самостоятельно. Поэтому я поручил агенту выполнить ту же задачу с нуля. Он показал результат, очень близкий к тому, которого добился первый агент, использовавший наработки Джейми. (Краткая проверка, проведённая другим агентом, не выявила признаков жульничества.)
Оптимизация под конкретную рабочую нагрузку
Вернёмся к этой части комментария Марка Брукера:
Вполне вероятно, что в итоге мы придём к динамически создаваемому специализированному ПО, подогнанному под конкретную рабочую нагрузку, а не под целый класс нагрузок.
Кажется, это практически неизбежно. В своём ответе на мой пост Майкл Мэлис (разработчик pgrust) тоже заявил нечто подобное:
[дискуссия оптимизаций pgrust] … Думаю, такие оптимизации достаточно легко реализовывать, поэтому мы могли бы анализировать рабочие нагрузки пользователей и добавлять нужные оптимизации по мере необходимости.
Непосредственно перед написанием этой статьи, не имея никакой готовой инфраструктуры или предварительной настройки, я поручил агенту оптимизировать ripgrep под конкретную рабочую нагрузку моих поисковых запросов (не переключение на компилятор нативного кода, а оптимизацию самого движка FRE на основании набора бенчмарков). На запуск этого процесса у меня ушло около двух минут.
Оптимизации выполняются на одном наборе запросов, а затем проверяется на другом, отложенном наборе контрольных запросов. Процесс ещё не завершился, но первые результаты выглядят многообещающе. Уже после одного прохода оптимизированная под мою рабочую нагрузку версия оказалась на 2% быстрее стандартного ripgrep на контрольном наборе, и производительность продолжает расти. Для моего локального использования ripgrep выигрыш в 2% не так уж существенен. Но, учитывая, что на всё это ушло всего несколько минут, а оптимизация началась буквально в тот момент, когда я принялся набирать этот абзац, и до сих пор продолжается, я бы вполне согласился на такой прирост. (Заметьте, что здесь не используется компилятор нативного кода: при правильном сочетании этих подходов общий выигрыш был бы ещё больше.)
Напомню, что мы используем движок регулярных выражений FRE5, который на контрольных бенчмарках работал значительно медленнее движка регулярных выражений Rust. Кроме того, его производительность на контрольных наборах улучшалась очень медленно. Причина заключалась в том, что я ничего не знал о типичных рабочих нагрузках при использовании регулярных выражений, а SOTA LLM недостаточно хорошо справляются с планированием экспериментов, чтобы самостоятельно и без дополнительных указаний организовать циклы непрерывного улучшения. Поэтому у нас не было надёжного способа повышать производительность на контрольных наборах. Но если меня интересует производительность именно на моих собственных рабочих нагрузках, у меня есть масса данных, и я постоянно собираю новые. Как отметил выше Марк Брукер, нужно учитывать риск переобучения, особенно если происходят изменения условий работы, не отражённые в старых данных, и так далее. Но даже с учётом этого наше положение всё равно лучше, чем раньше.
5 Вероятно, производительность была бы выше, если бы я поручил агенту напрямую модифицировать форк ripgrep. Но мне было интересно, сможет ли такой подход заодно решить проблему переобучения FRE под мои поисковые запросы.
В более общем случае, если ваши задачи схожи с работой Марка Брукера из Amazon или Майкла Мэлиса, который занимается проектом pgrust, имеет смысл не ограничиваться разовым экспериментом, а совместно с заказчиками запускать пилотную программу, использовать их данные для оптимизации систем, а затем думать о том, как масштабировать этот подход и распространить его на всех заказчиков. В моей компании это не самая оптимальная трата времени6, но поразительно, что уже сейчас можно увидеть, как подобный подход становится реальностью для крупных компаний; а поскольку проведение таких экспериментов в рамках моих личных рабочих процессов занимает у меня всего несколько минут, вполне разумно поэкспериментировать с подобными вещами и в собственных проектах.
6 Некоторое время назад я уменьшил размер страницы процесса регистрации с 50 МБ до 5 МБ, и, судя по результатам A/B-теста по выручке, это, похоже, увеличило доход компании примерно на 0,5%. В целом я большой сторонник того, чтобы в первую очередь заниматься простыми и очевидными улучшениями. Вероятно, здесь есть немало способов добиться гораздо большей отдачи от вложенных усилий, чем при разработке собственных компиляторов или выполнении другой узкоспециализированной технической работы.
Спасибо Джейми Брэндону, Майклу Малису, Андреа (@s__video), Артёму Бологову и Максу Битткеру за комментарии, исправления и обсуждения.
P.S. Как я говорил в паре предыдущих постов, с появлением ИИ-агентов для кодинга время, необходимое для проведения эксперимента и получения результата, достаточного для удовлетворения моего любопытства, значительно сократилось. При этом время, требуемое для получения действительно достоверного результата, не изменилось или даже увеличилось. Поэтому, если бы я продолжал описывать результаты так же подробно, как раньше, мне пришлось бы проводить гораздо меньше экспериментов, чем позволяют мои ресурсы. Поэтому я просто проводил эксперименты и делился результатами с друзьями. Теперь в качестве эксперимента я пробую описывать их кратко и без претензии на строгость, вместо того чтобы рассказывать о них лишь нескольким друзьям. Как и в прошлом посте, я поставил себе цель написать эту статью и выполнить всю необходимую доработку за полчаса. Я не засекал время, но почти уверен, что лишь немного превысил этот лимит.
Даже при таком подходе подготовка публикаций отнимает достаточно времени, из-за чего я публикую свежие результаты с задержкой, но переходить на написание постов при помощи LLM я (пока?) не собираюсь. И я не думаю, что в обозримом будущем смогу найти достаточно времени, чтобы очистить данные, привести их в порядок и подготовить статью такого рода менее чем за полчаса. Судя хотя бы по объёму этой публикации, на её написание должно уйти примерно 20–30 минут, включая паузы на обдумывание текста. А когда я изучаю данные, иногда обнаруживается что-то настолько подозрительное, что приходится разбираться подробнее и выяснять, нет ли там ошибки, которую нужно исправить. В этой статье такое случалось несколько раз. К тому же я думаю, что из-за того, что я потратил на работу не намного больше времени, в данных остались и другие проблемы, о которых я пока не знаю.
Дополнение: теперь ничто не мешает программам быть быстрыми
Я уже давно открыто выступаю против распространённого мнения, что разработчики X — плохие специалисты и должны этого стыдиться. Я решительно не согласен с такой точкой зрения, потому что написание медленного кода объясняется тем, что существует множество разных видов программистской экспертизы. Дело не только в том, что большинство программистов не обладают знаниями в области производительности: вероятно, им даже не имеет смысла специально их приобретать (если учитывать интересы бизнеса, ситуацию на рынке труда и прочие обстоятельства). Поэтому неудивительно, что производительность большинства проектов очень далека от той, которой может добиться специалист по оптимизации. Я понимаю, почему специалист по производительности, глядя на растущий разрыв между тем, насколько быстрой может быть программа, и тем, насколько быстры программы в действительности, считает ситуацию абсурдной. Я не спорю, что в этом есть что-то абсурдное. Но если подумать о разрыве между тем, насколько хорошим может быть пользовательский интерфейс, и тем, насколько хороший интерфейс я сам способен создать вручную, ситуация выглядит не менее абсурдной. При этом я не считаю, что мне действительно имеет смысл тратить время на изучение способов создания отличных или хотя бы приличных интерфейсов, по тем же самым причинам, по которым большинству разработчиков не имеет смысла тратить время на освоение качественной оптимизации производительности.
В приведённом выше примере Джейми Брэндон получил предложение о работе от Anthropic, но, вероятно, вы не сможете позволить себе нанять его, если вы не OpenAI. Однако вы можете позволить себе кодинг-агента, способного победить его в ограниченной задаче оптимизации. Агент не обладает теми суждениями, которые есть у Джейми, и с открытой задачей справится хуже него (вспомним, что когда мы попросили его создать оптимизированный движок регулярных выражений и просто велели не переобучить его под бенчмарки, результат оказался более чем на порядок хуже лучших движков регулярных выражений на наших контрольных бенчмарках; но вспомним и другое: когда мы сообщили агенту, что на контрольном наборе бенчмарков он показывает плохие результаты, производительность движка регулярных выражений удалось повысить настолько, что в целом она сравнялась с показателями движков второго эшелона, и это всё равно исключительно хороший результат по сравнению с общим уровнем оптимизации производительности в большинстве современных программ), но агент всё равно достаточно хорош для достижения приемлемой производительности во всех видах задач. В этом посте речь в основном шла о проблемах производительности бэкенда, но, похоже, агенты ничуть не хуже справляются и с оптимизацией фронтенда, если поставить перед ними задачу улучшить определённый набор показателей, например, LCP и CLS. Например, после того, как я добавил в свои публикации интерактивные графики, которыми пользуюсь в последнее время, показатели производительности на стороне клиента ухудшились, поэтому я поручил LLM оптимизировать их, потратив на это всего 1% недельного лимита запросов, и показатели снова пришли в норму. У меня очень простой сайт, но подобную оптимизацию проводят и на довольно сложных приложениях, которыми пользуются миллионы людей. Там это тоже работает, хотя и требует несколько больше токенов.
Я по-прежнему не считаю, что человек, чья программа работает медленно, — плохой специалист и должен этого стыдиться, однако думаю, что человек, который ничего не знает об оптимизации производительности, но умеет разумно пользоваться LLM (в целом, а не только для задач оптимизации), теперь обычно способен создавать программы с вполне приличной производительностью. Если просто попросить LLM оптимизировать код, она нередко начинает делать самые разные неправильные и крайне вредные вещи, которые вам придётся обнаруживать и исправлять. Но в целом то же самое справедливо и для эффективного использования LLM в принципе. Поэтому обеспечение приемлемой производительности перестало быть специализированным навыком.
Дополнение: как Codex запускает ripgrep?
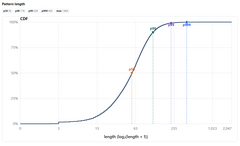
Вот некоторые данные о распределении поисковых запросов к ripgrep на моём компьютере. Я не утверждаю, что они хоть сколько-нибудь репрезентативны в общем случае. Распределение длины искомых шаблонов содержит гораздо больше длинных шаблонов, чем я ожидал. 50-й перцентиль составляет 55 кодовых точек Unicode (для простоты я буду называть их символами). Это уже больше, чем длина шаблонов, которые я обычно использую при поиске вручную, а 90-й перцентиль — целых 119 символов!
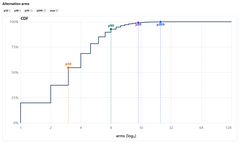
Можно также посмотреть на количество alternation arms в регулярных выражениях. И здесь они оказываются гораздо сложнее тех, которые я составляю вручную.
Ещё один способ взглянуть на эти данные — посмотреть на корреляцию между параметрами. Увеличивается ли количество alternation arms в регулярных выражениях по мере роста их длины? Да.
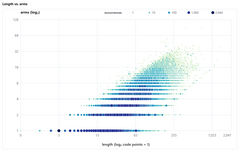
Что это за очень длинные регулярные выражения? Если взглянуть на них, окажется, что большинство самых длинных — это длинные последовательности альтернатив, перечисляющие имена функций или тестов. Например, следующее регулярное выражение, по-видимому, связано с разработкой FRE.
fn (hot_byte_compiler_is_generic_only_and_anonymous_count_uses_auto_count| one_pattern_count_spans_uses_the_retained_complete_span_session| formal_compact_state_byte_visitors_coexist_with_native_count| fixed_boundary_record_visit_matches_line_relative_reference_and_is_atomic| unbounded_languages_refuse_finite_extraction_before_allocation| formal_single_raw_span_sweep_preflight| assert_exact_fixture_uses_formal_large_continuation_sweep| url_only_compile_identity_binds_language_and_owner_mode| url_only_compile_exact_limits_and_runtime_refusals_close| url_only_compile_post_plan_allocation_faults_close| url_only_owner_discriminator_is_stable_and_precharged| url_only_compile_owner_is_strategy_and_operation_scoped| formal_rebar_url_owner_is_compile_only_and_matches_oracle| formal_rebar_url_exact_fixture_uses_certified_execution| formal_fixed_schema_materialization_matches_both_record_oracles_and_controls| formal_single_count_selects_compact_state_byte_complete_bound_visitors| authenticated_bound_line_total_lf_free_domain_opportunity_exceeds_five_percent| prepared_absolute_onepass_fuses_slots_and_preserves_pre_source_fallback| authenticated_word_boundary_russian_compact_lowering_public_canary| ordered_nfa_x86_epsilon_edges_bypass_the_assertion_call| ordered_nfa_aarch64_epsilon_edges_bypass_the_assertion_call| ordered_edge_dispatch_v2_is_target_neutral_deterministic_and_relocation_free| ordered_edge_dispatch_v2_copies_canonical_tables_and_cap_falls_back_to_v1| ordered_nfa_v3_composes_terminal_range_and_dispatch_without_data_relocations| ordered_nfa_x86_terminal_range_emits_authenticated_reverse_scan| ordered_nfa_aarch64_terminal_range_emits_authenticated_reverse_scan| ordered_nfa_x86_boundary_assertion_cache_is_lazy_and_boundary_scoped| ordered_nfa_aarch64_caches_repeated_assertions_once_per_boundary| boundary_assertion_cache_requires_dense_exact_kind_reuse| boundary_assertion_cache_selection_is_compiler_only_and_deterministic)Но есть и забавные числовые конструкции, например:
:(13[0-9]|14[0-9]|15[0-9]|16[0-9]|17[0-9]|18[0-9]|19[0-9]|20[0-9]|21[0-9]|22[0-9]|23[0-9]|24[0-9]|25[0-9]|26[0-9]|27[0-9]|28[0-9]|29[0-9]|30[0-9]|31[0-9]|32[0-9]|33[0-9]|34[0-9]|35[0-9]|36[0-9]|37[0-9]|38[0-9]|39[0-9]|40[0-9]|41[0-9]|42[0-9]|43[0-9]|44[0-9]|45[0-9]|46[0-9]|47[0-9]|48[0-9]|49[0-9]|50[0-9]|51[0-9]|52[0-9]|53[0-9]|54[0-9]|55[0-9]|56[0-9]|57[0-9]|58[0-9]|59[0-9]|60[0-9]|61[0-9]|62[0-9]|63[0-9]|64[0-9]|65[0-9]|66[0-9]|67[0-9]|68[0-9]|69[0-9]|70[0-9]|71[0-9]|72[0-9]|73[0-9]|74[0-9]|75[0-9]|76[0-9]|77[0-9]|78[0-9]|79[0-9]|80[0-9]|81[0-9]|82[0-9]|83[0-9]|84[0-9]|85[0-9]|86[0-9]|87[0-9]|88[0-9]|89[0-9]|90[0-9]|91[0-9]|92[0-9]|93[0-9]|94[0-9]|95[0-9]|96[0-9]|97[0-9]|98[0-9]|99[0-9])[0-9]:Это эквивалентно выражению :(?:1[3-9]|[2-9][0-9])[0-9]{2}: (если выполнить его поиск с помощью ripgrep по исходным входным данным, производительность будет примерно такой же; более короткое регулярное выражение, строго говоря, работает немного быстрее на реальных поисковых запросах, но разница совсем незначительна). Весь конвейер обработки выглядел так:
cargo clippy … | rg 'crates/fre-aot-regex/src/module.rs:' | rg NUMBER_REGEX | head -250От человека такое вряд ли ожидаешь, но агенты, похоже, постоянно делают что-то подобное.
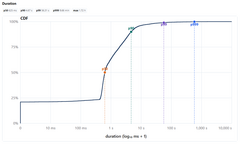
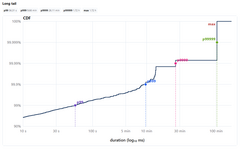
Если же посмотреть на время выполнения запросов ripgrep, обнаружится немало медленных запросов; например, p99 составляет почти минуту! А p999 — почти 10 минут! Самый долгий запрос за рассматриваемый период (примерно месяц работы на одном ноутбуке; вполне вероятно, что на хостах AWS, где я запускаю агентов, запросы и их распределение отличаются, но я этого не проверял) выполнялся почти два часа!
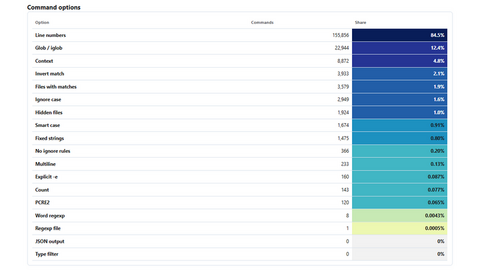
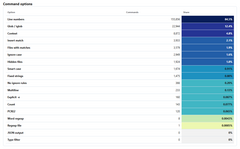
Если посмотреть на параметры командной строки, мы увидим следующее. Возможно, это неудивительно, но Codex часто запрашивает номера строк и, по какой-то причине, очень изредка использует регулярные выражения PCRE2.
Я не буду добавлять для этих данных графики или таблицы, но стоит отметить ещё одну особенность: локальность поисковых шаблонов довольно низкая (примерно 94% шаблонов встречались только один раз). Это вполне объяснимо, учитывая, насколько длинными были многие запросы. Однако локальность файлов, по которым выполняется поиск, довольно высокая: если файл уже искали, велика вероятность, что вскоре поиск по нему повторится. Это означает, что достаточно небольшие файлы, скорее всего, будут искаться непосредственно в памяти.
Кроме того, 99% запросов представляли собой поиск по регулярным выражениям (1% — поиск строк без использования регулярных выражений), а 99,9% поисковых запросов содержали только ASCII-символы. Однако среди файлов, по которым выполнялся поиск, примерно 45% содержали только ASCII-символы, а 55% — символы Unicode. Доля файлов с символами Unicode оказалась выше, чем я предполагал.
В черновике предыдущей статьи Питер Гегеган отметил:
Реализация регулярных выражений также может работать быстрее за счёт поддержки меньшего количества возможностей. Некоторые реализации, например, не поддерживают обратные ссылки и так далее.
В данном случае это тоже справедливо. Оптимизации, ориентированные на конкретную рабочую нагрузку, были довольно поверхностными: я просто дал Codex несколько коротких инструкций и позволил ему действовать по собственному усмотрению (что, вообще говоря, не самый эффективный способ использования Codex). Однако, если составить более подробный план, можно ожидать гораздо большего прироста производительности за счёт более целенаправленных оптимизаций, ориентированных на наиболее распространённые сценарии использования в моих поисковых запросах.
Источник: habr.com