
 Источник.
16 ноября, спустя всего пять дней после показа превью-версии, Alibaba выпустила полноценную флагманскую модель Qwen4-Max. Это мультимодальный MoE-гигант на 2,4 трлн параметров (71 млрд активных) с контекстным окном в 1 млн токенов, заточенный под сложный кодинг, работу в агентском режиме и прототипирование проектов — от фронтенда до 3D-игр. Модель ориентирована на программирование, решение сложных многоуровневых задач, создание проектов, в том числе игровых.
Веса модели на данный момент закрыты и развернуть ее на собственном компьютере не получится. Доступ возможен только через облако и API (при этом разработчики обещают позже выложить в opensource более компактные версии линейки Qwen4). Под катом разбираем архитектуру релиза и смотрим на бенчмарки.
После полноценного релиза модель получила оплату по фактическому расходу токенов через Alibaba Cloud. Стоимость составляет 1,5 $ за миллион входных токенов и 4,5 $ за миллион выходных, что дешевле на 25%, если сравнивать с Qwen3.8-Max.
Token Plan никуда не делся — тариф Lite стоит 6 $ и включает 20 000 кредитов, а для новых пользователей подписка доступна за 3 $.
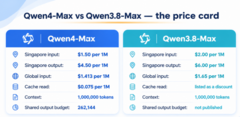 Сравнение стоимости использования Qwen4-Max и Qwen3.8-Max. Источник.
Бенчмарки
С выпуском полноценной модели Max вышли и бенчмарки.
В бенчмарке, проверяющем скиллы программирования в агентной среде, DeepSWE v1.1, модель лидирует с показателем в 75,7 балла против 74,2 баллов у Claude Opus 5.5. В Terminal-Bench 4.0 — бенчмарке, оценивающем работу с командной строкой, флагманская модель от Alibaba набрала 48,5 балла против 67,2 у Kimi K 3.1.
Для примера, расскажу еще про бенчмарк со сложными научно-техническими задачами под названием HLE (Humanity’s Last Exam). Модель показала в нем достойные 51,7 балла, а в Agent’s Last Exam набрала 46,7 баллов.
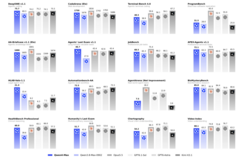 Бенчмарки Qwen4-Max. Источник.
Стоит отметить оптимизацию расхода токенов — во внутреннем бенчмарке, проверяющем способности модели справляться со сложными многоуровневыми задачами, Work360, Qwen4-Max расходует примерно 125 000 токенов в режиме Xhigh и набирает 52,7 балла против 165 000 токенов и 47,7 баллов у Qwen3.8-Max.
В Terminal-Bench 4.0 Qwen4-Max затрачивает почти вдвое меньше токенов, чем версия 3,8 с ее 37,8 баллами.
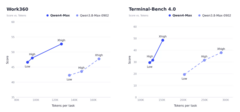 График расходования токенов на задачи у Qwen4-Max и Qwen3.8-Max. Источник.
Выводы
Alibaba выпустили долгожданные бенчмарки, сравнив Qwen4-Max с топовыми конкурентами и предыдущей Qwen3.8-Max. Главный минус отчета — нам не предоставили сравнение самой Qwen4-Max-Preview и вышедшей сегодня Max. Так что оценить реальный рост способностей и качества модели с момента превью нельзя.
Пока модель нельзя раскатить на собственный компьютер и пользоваться всей мощью этой модели. Хоть и оптимизировали расход токенов, это скорее тенденция всех разработчиков моделей, а не желание лабораторий меньше на нас заработать.
Вообще, релиз полноценной Max-версии всего через пять дней после Preview — это уже классика ИИ-маркетинга. Понятно, что за такой срок модель на 2,4 трлн параметров не переобучишь, максимум — пофиксили баги инференса и докрутили системные промпты.
А вы как думаете, зачем Alibaba эта гонка с интервалом в неделю и заметили ли вы вообще разницу между Preview и сегодняшним релизом? Делитесь мнением и первыми тестами в комментариях.
ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Запустить ИИ‑роутер →
Источник: habr.com