
Привет, Хабр!
Представь обычное домашнее задание в вузе. Преподаватель просит нейросеть составить задание, студент отдаёт её своей нейросети и сдаёт готовый ответ, а проверяет работу снова нейросеть. От подготовки задания до проверки получается переписка ИИ студента с ИИ преподавателя — ирония в том, что это может быть одна и та же модель. А люди в такой переписке только передают тексты друг другу и выступают в роли живых прокси. Конечно, так бывает не всегда и далеко не все преподаватели составляют задания нейросетью, и не все студенты решают с ее помощью домашние работы. Но и редкостью такой сценарий уже не назовёшь. При этом, запрещать чат-боты бессмысленно — они уже часть нашей повседневной жизни, как интернет и смартфоны.
При этом сам ИИ может быть не врагом учебе. В этом году в MIT провели эксперимент: семь студенческих команд за месяц должны были спроектировать и собрать небольшой реактивный двигатель, и им разрешили пользоваться ИИ. Нейросеть работала как личный репетитор и закрывал пробелы в знаниях, отвечал на вопросы круглосуточно, без перерыва на обед и сон. Это помогло вообще приступить к работе даже тем, кто раньше не знал как в принципе устроены газовые турбины.
Но до полных испытаний двигателя дошли только две команды, обе из старшекурсников, а запустился он у одной. Нейросети галлюцинировали, поддакивали и не понимали физику, причём делали это уверенно. Победители относились к подсказкам ИИ осторожнее остальных и опирались на собственные знания.
К чему я об этом?
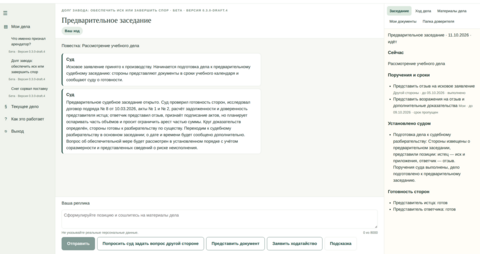
Мы хотели взять у ИИ то, что он умеет хорошо, и поставить студента в то же положение, в котором оказались команды из MIT. Так появилась идея создать ИИ-тренажер судебного процесса ChatCourt. Если кратко, идея заключается в симуляции реального судебного процесса с ролями судей, секретарей, ответчиков и истцов. Студент может выступать в качестве ответчика или истца, и задача каждого — выиграть дело. В симуляторе нет правильных или неправильных ответов, так что это не линейный или адаптивный тест. Каждое рассмотрение дела по сути уникально и зависит от реплик студента и других участников процесса. Оппонент может затупить или ошибку может допустить судья — все как у людей. Преподаватель оценивает действия студента через призму процесса, а не итог по делу.
Пользоваться своим чатом с ИИ во время заседания студент, конечно, будет, и помешать этому никто не сможет. Но ИИ может насоветовать ерунду. Чтобы это заметить, придётся изучить документы дела, проверить ответ модели и сформулировать свой. ИИ способен дать и базовые знания, только для этого нужно критическое мышление и желание разобраться в процессе и тогда ИИ может стать хорошим партнёром. При этом ии-тренажер не призывает пользоваться ИИ в ходе прохождения, его можно пройти и своими силами. Такова была идея. А что получилось на практике?
Как это устроено
Арбитражный процесс, первая инстанция. Студент выбирает сторону, истца или ответчика, и проходит шесть этапов: подготовка, предварительное заседание, судебное заседание, доказательства и ходатайства, прения, решение. Решение выносит ИИ-судья.
Модель в продукте должна быть российской. Тренажёр предназначен для российских вузов, а у них есть ограничения на использование иностранных ИИ-сервисов. Китайские модели под эти ограничения тоже попадают.
Замысел начинался как детерминированный «тренажёр-навигатор» без ИИ по ГПК и АПК. Но со временем его сузили до первой инстанции арбитражного процесса, а ИИ-участники появились с условием, что процессом по-прежнему управляет программа.
Дело начинается после принятия иска: подготовка, предварительное заседание, разбирательство, итог. Три учебных дела по урокам курса. Подачу иска, апелляцию, кассацию и исполнение вынесли на потом.
С самого начала было понятно, что управление процессом не должно вестись моделью. Нужно было разработать движок управления процессом. При этом он не должен был быть жестким, чтобы симуляция процесса была наиболее естетственной. Код должен решать, что допустимо, а что делать дальше должна решать модель.
Дальше я хотел бы рассказать с чем я столкнулся при разработке, а именно с нюансами тонкой настройки ИИ‑судьи в поисках баланса между качеством ответа и реалистичностью судебного процесса, чтобы не было ощущения что ты болтаешь с тупым ботом.
Технически это синхронный модульный монолит на Python [FastAPI] с SQLite: для пилота на несколько студентов этого вполне достаточно. Вообще, разработка не предвещала каких-либо больших проблем.
В ходе разработки я использовал для тестов модель от Антропик — Sonnet в качестве ИИ-судьи. У него прекрасные агентские навыки и тренажер для него был несложным. Но это была моей ошибкой. Я планировал в проде использовать GigaChat Ultra, но с недавних пор его убрали из коммерческого использования, а разработчикам выдали по бесплатных 50 млн. токенов для исследований, мне хотелось их сэкономить для бета тестирования.
Моей ошибкой было предоположение что модель от Сбера и Sonnet могут принимать и отдавать один и тот же формат — JSON. Но Sonnet может за один шаг сразу вызывать несколько функций, а GigaChat только одну функцию за раз.
Это был период долгого посыпания пеплом головы и битья головой об стол. Движок был несовместим с ГигаЧатом практически полностью. Легче было его переписать с нуля.
Промпт-инжиниринг
И вот когда я все же переписал движок под GigaChat я столкнулся с проблемой зацикливания модели — агент писал в чат одну и ту же фразу. Такое случается обычно, когда на вход идет один и тот же промпт, а температура модели выкручена до нуля. В таком случае модель выбирает следующим токеном самый вероятный и ответы начинают повторятся.
Почему промпт один и тот же?
Потому что движок детерминированный и если модель пишет неверный ответ, а движок его не принимает, он возвражает ему повторный промпт с пометной как исправить. И если ответ опять неверный, повторный промпт может уйти такой же 1 в 1.
Температуру модели я вывел эмперическим путем по ролям: судья 0,2, ИИ-сторона и подсказки 0,3, служебные проверки — 0,01. Ноль GigaChat не принимает. Но регуляровка температуры не сильно помогла — если слишком повысить его температуру модель перестает слушать инструкции и начинает выдавать галлюцинации. От бесконечных циклов поедания токенов спасло введение режима «Паузы», когда движок видит повторяющиеся сообщения от модели он останавливает процесс с соответствующим служебным сообщением.
Решением же самой проблемы зацикливания стало включение в промпт несколько нововедений:
-
пояснения, что именно не так и что сделать вместо этого;
-
внедрение кодировки отказов;
-
Для каждого кода отказа пример как исправить. Таких примеров набралось аж 45 штук;
-
журнал хода — что модель уже предлагала и почему это отклонено;
-
после обрыва ответа по длине повтор идёт с пометкой «пиши короче» и с поднятым лимитом 4000 токенов.
Да уж, столько тестов и проверок промптов я еще не проводил.
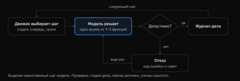
Одной правкой промпта дело не обошлось. В одном из прогонов судья семь раз подряд задал вопрос ответчику, хотя слово было у студента. После этого в движок пришлось внедрить «ведомый» режим: движок сам выбирает тип следующего шага и предлагает модели от одного до трёх действий. Действие, отклонённое за повтор, убирается из меню до конца хода. После повторного вопроса судье предлагается уже переход или итог. А если слово положено студенту, судья может спрашивать только его.
Один ход ИИ-судьи в ведомом режиме выглядит так:
Как устроена память
Изначально в движке я рассматривал использование LangGraph.
Каждому ИИ-участнику нужен свой «стол» который он может видеть: судья не должен видеть стратегию сторон, оппонент — папку студента. LangGraph умеет работать по мультиагентной схеме с разделённым контекстом, но по умолчанию агенты делят общую историю сообщений, а checkpointer хранит состояние всех ролей вместе с текстами студентов. Это означало что, изоляцию мне бы пришлось писать самому, а хранение — отключить. После этого от фреймворка оставался тонкий цикл, который проще написать самому, что в итоге и решил делать отказавшись от LangGraph.
Своей «памяти» у модели нет.
GigaChat Ultra поддерживает контекстное окно в размере 128 тыс. токенов. Перед каждым вызовом движок пересобирает для роли «стол» заново из журнала дела и опубликованной версии сценария. После вызова от него ничего не остаётся. Стол состоит из семи секций:
-
Позиция роли: стратегия своей стороны со слабыми местами или план заседания судьи. Подсказчику эта секция не даётся.
-
Опись дела: оглавление материалов. Короткие документы входят целиком, длинные модель открывает сама инструментом «открыть документ».
-
Протоколы прошлых заседаний вместо сырого журнала событий.
-
Заметки роли, до 15 штук. Это единственная «долгая память» модели. Она сама пишет их отдельным действием, они хранятся событиями в журнале дела и переживают перезапуск.
-
Рабочая секция: стадия, допустимые действия, неотмеченные проверки, повестка, что уже сделано в этой части, нормы, у судьи ещё подсказки системы и флаги арбитра.
-
Последние 10–15 реплик текущего заседания.
-
Журнал хода: что модель уже предлагала в этом ходе и что из этого отклонено.
Изначально я не использовал кэш, для разработки и тестирования промптов он был не нужен, пока я использовал через Claude code CLI модель Sonnet как ИИ-судью. Но когда дело дошло до реальных тестов с облачной моделью по API кэш дает ощутимую экономи. Он работает на стороне провайдера, и по нему есть несколько нюансов:
-
Ключ сессии. К каждому вызову добавляется заголовок X-Session-ID, хеш пары «попытка + роль». У служебных вызовов вместо роли — вид служебной задачи. GigaChat кэширует общее начало запросов с одинаковым ключом, а без заголовка кэш почти не срабатывал.
-
Порядок секций. Неизменное идёт первым: системная инструкция, позиция роли, опись, протоколы. Меняющееся — в конце: реплики, журнал хода, ведомый шаг и слой исправления. Поэтому повторный вызов той же роли попадает в кэш на всю неизменную часть.
Использование кэша дало довольно значительный эффект. На пробе из 25 981 входного токена 25 920 взяты из кэша. В целом при настройке доля кэша выросла примерно с 8% до 44% в некоторых случаях. Токены из кэша тарифицируются отдельно и заметно дешевле.
После всех манипуляций с настройками моделей удалось избавиться от зацикливаний и оптимизировать промпты так, что общий расход на один полный тестовый прогон по сценарию дела уменьшился с 1,7 млн. токенов на Sonnet до 0,55 млн. токенов из них 0,39 млн тарифицируемых и 0,17 млн из кэша (30% в среднем) на GigaChat, а кол-во вызовов уменьшилось с пиковых 100 до 62.
Прогон
Вызовов
Входные токены
Выходные токены
GigaChat, до оптимизации
100
1,3 млн
45 тыс.
GigaChat, после оптимизации
62
≈ 0,55 млн, из них 0,39 млн тарифицируемых и 0,17 млн из кэша (30%)
20 тыс.
Claude Sonnet 5.5
55–68
1,2–1,7 млн
—
Что в итоге
GigaChat Ultra проходит дело до решения без пауз, и ведомый режим включён на пилотном сервере.
Как к этому шли, видно по четырём прогонам одного дела на GigaChat Ultra. Каждая строка добавляет одну правку к предыдущей.
Шаг
Что изменил
Докуда дошло дело
Пустые ответы
Полное меню (Sonnet сам выбирал какие функции вызвать)
исходный вариант
пауза на открытии заседания
30%
Ведомый режим (GigaChat)
движок выбирает шаг, у модели 1–3 действия
предварительное заседание пройдено
21%
Плюс кэш (GigaChat)
X-Session-ID, неизменная часть запроса первой
дело дошло до конца, но были зацикливания и паузы
12,5%
Плюс новый промпт (GigaChat)
короткая инструкция с примерами
решение суда: 62 вызова, 7,5 минуты, 0 пауз
0%
Сейчас идёт бета-тестирование со студентами. О результатах буду писать уже в следующих статьях.
Риск ошибок ИИ-судьи по существу никуда не делся, и оба пункта ниже как раз о том, как уменьшать его дальше.
Самое заметное, чего тренажёр пока не умеет, — работать с судебной практикой. ИИ-судья и ИИ-оппонент опираются на материалы дела, сценарий и на то, что модель знает сама. Базы судебных решений и актуального законодательства в виде RAG за ними нет.
У зарубежных аналогов такой слой есть. В китайском AgentCourt агенты-юристы проходят тысячу гражданских дел и накапливают три базы знаний: нормы права, опыт прений и библиотеку дел. Правда, это исследовательский симулятор, а не учебный тренажёр — там учатся агенты, а не студенты.
В России решения существуют справочно-правовые системы с базами судебной практики и ИИ-ассистенты для юристов. Подключить одно из них к ChatCourt было бы логичным следующим шагом. Тогда судья и оппонент ссылались бы на реальные позиции судов, а студенту пришлось бы эти ссылки проверять, как в настоящем процессе.
Если вы делаете такой продукт и вам интересно попробовать его в учебном суде, напишите. Мы открыты к партнёрству.
Вторая вещь — само решение суда. Тренажёр доводит дело до решения, но текст этого решения пока слабый: до настоящего судебного акта ему далеко. Ближайший шаг понятен: настройки и работа с промптом. Но есть основания полагать, что одного промпт-инжиниринга здесь не хватит и модель придётся дообучать.
А это задача совсем другого уровня. Нужна большая языковая модель, которую не обучить на игровом ноутбуке. Нужен датасет: тонны реальных судебных решений, где на входе перечень фактов по итогам дела, а на выходе текст решения. Его ещё надо собрать и подготовить. Это уже исследовательская работа для университетов и лабораторий с соответствующими бюджетами. Если вам такая задача интересна, тоже напишите мне в тг: @argmaster
Источник: habr.com