
Строительная отрасль научилась собирать данные
Строительная отрасль уже давно активно цифровизируется в проектах применяются информационные модели, цифровые документы, ведомости, сметы, системы управления замечаниями, планированием, согласованиями и т.д..
Данных становится всё больше!
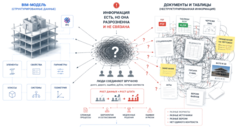
Но вместе с ними не исчезает одна из главных проблем строительного проекта — полноценная автоматизация процесса перевода данных в осмысленную информацию до сих пор не достигнута. Сегодня этот перевод выполняется преимущественно вручную. Специалистам приходится самостоятельно разбираться в массивах данных, интерпретировать их и компилировать в проектные артефакты — ведомости и сметы. В ходе такой кустарной обработки связи между блоками данных всё же формируются, но они намертво замыкаются на авторе-исполнителе. Без сквозных цифровых алгоритмов эта информация становится непрозрачной для остальной команды, а понимание того, «что делать с ней дальше», теряется. В масштабах всего проекта это неизбежно ведет к информационному хаосу».
Чтобы не было информационного хаоса, приходится вручную его обслуживать, даже при том что используем цифровые инструменты, но как правило они все исповедуют детерминированный подход, а все отклонения от выстроенного алгоритма обслуживаются специалистами, экспертами.
По сути, человек в этой схеме выполняет роль «хранителя контекста» для зоопарка не умеющих гибко адаптироваться программ. Цифровизация автоматизирует порядок, но бессильна перед энтропией. До тех пор, пока системы не научатся оперировать контекстом, вероятностями и нечеткой логикой так, как это делает человеческий мозг, эксперты будут оставаться заложниками детерминизма — живыми процессорами, сглаживающими углы несовершенных алгоритмов.
Масштабировать такой подход можно в основном за счёт увеличения штата, как итог — Строительная отрасль не научилась эффективно управлять данными!
 ChatGPT Image 19 мая 2026 г., 09_28_12.png
В этом и кроется главный парадокс цифровизации: масштабирование данных обнажило жесткость старого детерминированного подхода. Вместо интеллектуальной свободы мы получили огромный объем технологической рутины. Потребность в человеке возросла не только на уровне сложной аналитики, но и на уровне базовых конвейерных операций таких как: «ручной маппинг, механический перенос данных между изолированными базами и бесконечной сверки реестров, которые системы не способны сопоставить автоматически».
 Всё сложно
Девелопер говорит: “Нам нужен BIM/ТИМ” после появляется BIM/ТИМ отдел. Девелопер говорит: “Нам нужен AI/ИИ” после появляется люди занимающиеся этим направлением. Такой подход к масштабированию приводит к:
-
росту количества персонала;
-
сокращению скорость принятия решения;
-
неэффективности принятых решений;
-
повторению прошлых ошибок.
Сотрудники используют цифровые инструменты и это ускоряет их работу, но всё ещё требует большое количества времени к осмыслению данных. Значительная часть этой работы рутина такая как выполнение однотипных задач, формирования информации, анализ собранной информации и т.д..
Поэтому следующий шаг цифровизации строительства заключается уже не просто в накоплении информации, а эффективности работы с информацией. Один из методов эффективной работы заключается в том чтобы можно было быстро получать ответы и решения на возникающие вопросы и задачи. Для это хорошо должно подойти работа с AI/ИИ, но сначала нужно научить AI/ИИ понимать строительный объект.
Что значит «понимать строительный объект»?
Когда мы говорим, что специалист понимает строительный объект, что именно мы имеем в виду?
Он может прочитать чертёж, узнать конструкцию, разобраться в её составе и назвать характеристики. Но понимание проявляется и в том, что он способен объяснить: почему здесь принято именно такое решение, какую функцию оно выполняет, как связано с другими решениями и какие последствия повлечёт его изменение.
В этой статье под пониманием строительного объекта я имею в виду способность устанавливать смысл имеющихся сведений в их взаимосвязи.
Например, толщина стены — конкретный числовой параметр. Материал — характеристика её состава. Расположение — положение в пространстве здания. Взятые по отдельности, эти сведения описывают элемент. Рассмотренные вместе с его назначением, конструктивной схемой, узлами и требованиями проекта, они позволяют судить о роли этого элемента в объекте.
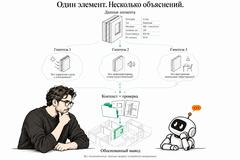
При этом одинаковые или похожие характеристики могут иметь разное значение в разных проектных решениях. Само наличие данных ещё не определяет, как именно следует их интерпретировать. Логику понимания можно раскрыть через несколько взаимосвязанных способностей. Получить сведения. Установить, что известно об элементе: его геометрию, свойства, состав, положение и описание.
Интерпретировать их. Определить, что означают эти сведения с инженерной точки зрения: о какой конструкции идёт речь, какие функции она может выполнять и какие особенности решения отражают её характеристики.
Соотнести с целым. Установить, какую роль элемент выполняет именно в рассматриваемом объекте, как связан с другими конструкциями, пространствами, системами и проектными решениями.
Вывести последствия. Объяснить, что из установленного следует для конкретной задачи: какие сведения нужны для расчёта, какие работы связаны с решением, что потребуется пересмотреть при его изменении.
Оценить основания вывода. Различить, что прямо задано в проекте, что получено расчётом, а что пока является предположением. Определить, достаточно ли сведений для ответа или возможны другие интерпретации.
 Что значит понять?
Эти способности не образуют строго линейную последовательность. Предварительное представление об элементе уточняется по мере изучения его связей, а новые сведения могут изменить первоначальный вывод.
В этом смысле понимать строительный объект — значит формировать связное и обоснованное представление о его элементах, их назначении и взаимосвязях, позволяющее объяснять принятые решения и определять их последствия в пределах доступной информации.
Что происходит, когда с той же информацией работает нейросеть?
Почему именно BIM/ТИМ?
Начинать работу над машинным пониманием строительного объекта логично с BIM/ТИМ-модели. Она предоставляет основу для анализа: элементы объекта представлены вместе с геометрией, свойствами, составом и заданными между ними связями.
Для нейросети это существенное преимущество. Ей не обязательно восстанавливать исходное описание конструкции по изображению или собирать его из разрозненных текстовых упоминаний. Значительная часть сведений уже организована и привязана к конкретным элементам.
Например, за названием “Базовая стена [1029275]” могут находиться данные о размерах, материалах, слоях, расположении и принадлежности к определённому типу. Если эти сведения заполнены, система получает достаточно содержательное описание для первоначальной интерпретации: может разобрать состав элемента, сопоставить его признаки с инженерными понятиями и предложить классификацию.
Ценность BIM/ТИМ здесь заключается в сочетании трёх составляющих: геометрии (на первых подходах в меньшей степени, хотя потенциал большой), свойств и положения элемента в структуре объекта. Они позволяют рассматривать сведения совместно и соотносить их с конкретной частью здания. Опять же возвращаясь к геометрии важно понимать, что даже если нет нужной информации об элементе, то можно благодаря геометрии, визуальной составляющей считывать дополнительно её. К пример у элемента нет заполненного свойства этаж или уровень, а у других элементов окружающих его есть, то косвенно мы считываем что он на таком-то этаже. Также если у наружной двери нет характеристики огнестойкости но визуально мы считаем что эта дверь ведет по пути к незадымляемой лестничной клетке (тип Н1) , то значит это эвакуационная дверь и там должен быть предел огнестойкости.
Это делает модель удобной основой для дальнейшего объединения информации. К её элементам можно привязывать документы, требования, виды работ и расчёты. Появляется предметная точка отсчёта: понятно, к какой конструкции или системе относятся дополнительные сведения.
Однако BIM/ТИМ-модель не следует считать исчерпывающим представлением обо всех решениях проекта. Даже на рабочей стадии проектирование информация в BIM/ТИМ-модели это порядка 50 % (по моей оценке).
Полнота её содержания зависит от стадии, требований к моделированию и практики участников. Часть сведений может находиться в узлах, спецификациях, расчётах, документах по организации строительства и других источниках. Даже если эти материалы существуют в цифровом виде, их связь с конкретными элементами модели не всегда задана явно.
Кроме того, структурированность не гарантирует качества данных. Свойства могут быть заполнены частично, названия — неоднозначны, а сведения в модели и документах — относиться к разным редакциям решения.
Поэтому модель даёт нейросети хорошую основу для интерпретации, но достаточность этой основы определяется задачей. Для поиска условных стен по материалу может хватить их параметров. Для определения состава работ по устройству тех же стен могут понадобиться сведения об узлах, соединениях и принятой технологии. Дополнительные источники необходимо подключать по мере анализа: именно они могут подтвердить первоначальную интерпретацию, уточнить её или показать, что она ошибочна.
BIM/ТИМ-модель — хорошая точка входа, потому что она предоставляет структурированное представление об элементах объекта, вокруг которого можно последовательно собирать и проверять контекст проекта.
Одним из первых практических шагов на этом пути становится классификация: сопоставление элементов модели с инженерными категориями и системой понятий, принятой для конкретной задачи.
Практический навык — классификация
Мы определились с пониманием строительного объекта, оно предполагает способность интерпретировать сведения, устанавливать связи и обосновывать выводы, то одной из практических задач должна стать классификация элементов. Она позволяет поставить перед системой конкретный вопрос: к какому классу относится рассматриваемый элемент и какие сведения дают основания для такого решения?
На первый взгляд ответ уже содержится в BIM/ТИМ-модели. Если элемент называется “Базовая стена”, зачем ещё раз определять, что это стена? Но класс необходимый для работы с проектом, может иметь разную степень подробности, отвечать на разные вопросы. Нам важно установить, является ли элемент монолитной конструкцией или сборным изделием, выполняет ли он несущую функцию, из каких слоёв состоит и к какой группе относится в системе заказчика, т.к. банально разная стоимость схожих объектов.
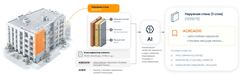 Вроде всё ровно
Поэтому задача заключается не в том, чтобы ещё раз назвать стену стеной. Необходимо соотнести сведения о ней с определённой системой понятий.
Классификация строительной информации — это отнесение объектов и сведений о них к установленным классам по определённым признакам. Классификатор задаёт названия, коды (код конечно же это не для человеческого восприятия, а для различных учётных систем), структуру и описание этих классов. Благодаря этому участники проекта могут использовать согласованные обозначения, даже если в исходных моделях и документах одни и те же конструкции названы по-разному.
При этом важно различать идентификатор элемента и его классификационный код. Идентификатор отвечает на вопрос “какой именно элемент мы рассматриваем?”, а код — “к какому классу он относится?”. У ста одинаковых панелей могут быть сто разных идентификаторов и один общий классификационный код.
Похожим образом устроена библиотека: название помогает узнать книгу, инвентарный номер — различить конкретные экземпляры, а классификационный индекс — определить место книги среди других изданий. Однако сам индекс не заменяет содержания книги. В строительной модели классификация тоже помогает организовать сведения, но не исчерпывает знания об объекте.
Чей язык должна понимать система?
Классификатор становится общим языком для тех участников, которые договорились его использовать. Однако из этого не следует, что для всех проектов и всех задач обязательно нужен один универсальный классификатор.
В проекте могут применяться отраслевые системы, корпоративные справочники или их сочетание. При этом системы классификации различаются не только названиями и кодами, но и тем, что именно они описывают. Например, OmniClass включает отдельные таблицы для разных аспектов строительной информации, а ETIM сосредоточен на классах продукции и её технических характеристиках. Их нельзя рассматривать как взаимозаменяемые списки названий. Описание OmniClass, устройство ETIM, КСИ.
Различаться могут и потребности участников одного проекта. Проектировщику требуется группировать элементы по конструктивному назначению, подрядчику — связывать их с выполнением работ, эксплуатирующей организации — организовывать сведения об обслуживаемых объектах. Не каждое такое представление требует собственного классификатора, но система должна учитывать, для какой задачи организуется информация.
Поэтому задача AI/ИИ состоит не в том, чтобы навязать всем участникам ещё один язык. Он должен помогать соотносить сведения об объекте с системами понятий, принятыми в проекте. Причём перевод между ними не сводится к замене одного кода другим. Одна система может объединять конструкции в общую сборку, а другая — разделять их по признакам, которые в первой вообще не учитываются. Тогда для установления соответствия потребуются дополнительные сведения об элементе.
Как AI классифицирует BIM-элемент
Представим элемент модели с названием:
«Базовая стена [1029275]».
В принятом для проекта классификаторе необходимо найти соответствующую ему позицию. Для примера рассмотрим условный класс «Трёхслойные наружные несущие железобетонные панели с гибкими связями».
Эта формулировка содержит несколько признаков: конструкция является панелью, изготовлена из железобетона, имеет три слоя, относится к наружным конструкциям, выполняет несущую функцию и содержит гибкие связи между слоями.
Название «Базовая стена» само по себе не раскрывает все эти особенности. Поэтому система обращается к доступным сведениям об элементе: параметрам, составу, описанию типа, назначению и связанным проектным данным.
Допустим, в нашем примере доступны следующие сведения:
-
Описание типа: Сборная стеновая панель;
-
Состав: Железобетон / утеплитель / железобетон;
-
Назначение: Наружная;
-
Несущая функция: Да;
-
Межслойные связи: Гибкие
Из них программа формирует описание для нейросети:
Сборная наружная несущая стеновая панель. Состав: железобетон, утеплитель, железобетон. Межслойные связи — гибкие.
Здесь мы рассматриваем работу с текстовыми описаниями и параметрами. Если для классификации требуется анализ геометрии, его необходимо включить в обработку отдельно: текстовая модель не получает пространственную структуру BIM/ТИМ-файла автоматически.
Как теперь связать описание элемента с нужной позицией классификатора? Один из вариантов — организовать работу в два этапа: предварительный поиск кандидатов и их последующее нейросетевое сопоставление.
Сначала — найти кандидатов
На первом этапе выполняется векторный поиск. Модель преобразует описание элемента в численное представление — вектор. Описания классов преобразуются аналогичным образом, причём их векторы можно подготовить заранее.
Затем система вычисляет близость представления элемента к представлениям классов и отбирает ближайшие позиции.
Задача этого этапа — сузить круг поиска. Например, в предварительную выборку могут попасть:
1. Трёхслойная наружная несущая ЖБ-панель с гибкими связями;
2. Трёхслойная наружная несущая ЖБ-панель с жёсткими связями;
3. Трёхслойная наружная ненесущая ЖБ-панель с гибкими связями;
Описания похожи, но различаются инженерно значимыми признаками. Для дальнейшего выбора важно сопоставить эти различия с данными рассматриваемого элемента.
Затем — Сопоставить элемент с каждым кандидатом
На втором этапе можно использовать модель Cross-Encoder. Она получает сразу два текста: описание элемента и описание одного из найденных классов.
Модель обрабатывает их совместно и выдаёт численную оценку соответствия. Эта операция повторяется для каждого кандидата, после чего система упорядочивает результаты.
Различие между этапами заключается в способе обработки. При векторном поиске сравниваются численные представления, подготовленные отдельно. Cross-Encoder обрабатывает каждую пару описаний совместно. Использование этих подходов в связке описано в документации Sentence Transformers.
Схема показывает один из вариантов реализации: векторный поиск отбирает кандидатов, Cross-Encoder оценивает соответствие каждой пары «элемент — класс».
Предположим, для нашего элемента получены следующие оценки кандидатов:
— Несущая панель с гибкими связями: 4,2;
— Несущая панель с жёсткими связями: 2,1;
— Ненесущая панель с гибкими связями: -0,8;
Числа условные: они иллюстрируют механизм, а не результаты испытания модели на строительных данных.
В показанном варианте большее значение соответствует более высокой оценке пары. Поэтому система предлагает первый класс.
Число 4,2 не означает вероятность 42% или количество совпавших признаков. Это выходная оценка модели, позволяющая упорядочить кандидатов. Примеры Cross-Encoder, возвращающих такие оценки, в том числе отрицательные, приведены в документации модели.
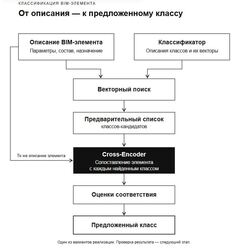
Сама работа нейросети не сводится к подсчёту одинаковых слов. Она использует закономерности, усвоенные при обучении, и может сопоставлять разные формулировки. Например, описание состава «железобетон / утеплитель / железобетон» может быть соотнесено с трёхслойной конструкцией. Насколько успешно конкретная модель выполняет такие сопоставления в строительной области, необходимо проверять на соответствующих примерах.
Предложенный класс и установленный факт
В нашем примере сведения о гибких связях были доступны. Но что произойдёт, если их убрать?
Нейросеть по-прежнему сможет вычислить оценки и поставить одну позицию первой. Однако преимущество кандидата не восстановит отсутствующее проектное решение. Выбор может опираться на закономерности обучения и другие доступные сведения, а не на подтверждённое устройство связей именно этой панели.
Поэтому “модель предложила класс” и “принадлежность к классу обоснована” — разные результаты.
При отсутствии существенных сведений система может сохранить несколько кандидатов, предложить более общую категорию или указать, что необходимо уточнить. Недостающий признак не должен незаметно превращаться в установленный факт.
Именно здесь классификация связывается с пониманием в том смысле, который мы определили ранее. Полезный результат — это не только выбранная позиция. Важно также установить, какие сведения подтверждают выбор и что остаётся неизвестным. Проверка этих оснований — следующий этап работы с предложением нейросети.
Что даёт установленный класс
Допустим, необходимые сведения проверены и класс выбран обоснованно. Что это позволяет сделать дальше?
В иерархическом классификаторе конкретная позиция связана с более общими. Например, в нашем условном справочнике трёхслойная железобетонная стеновая панель относится к железобетонным стеновым панелям, а те — к стеновым панелям в целом.
Теперь элемент можно находить на разных уровнях подробности. Для одного запроса нужны только трёхслойные панели определённого назначения. Для другого — все железобетонные стеновые панели. Для третьего — все стеновые панели независимо от частных разновидностей.
Заново анализировать описание каждого элемента при каждом запросе не требуется: система использует установленную принадлежность и структуру классификатора. Возможность переходить от общих групп к подробным данным и обратно предусмотрена, например, в применении OmniClass. Описание CSI.
В этом смысле можно говорить о вертикальных связях: конкретный элемент получает место в системе более общих классов. Но структура классификатора не создаёт доказательств его свойств. Если исходный класс выбран ошибочно, дальнейшая группировка распространит ошибку на выборки и отчёты.
Где заканчивается классификация?
После установления класса поиск элементов, переход к общим категориям и суммирование заданных показателей могут выполняться обычными алгоритмами. Например, классификация помогает сформировать выборку наружных стеновых панелей и определить их количество.
Общий классификатор также помогает согласовать обозначения между источниками. Для обмена данными при этом необходимо договориться, какие сведения передаются, как они связаны с элементами и как трактуются принимающей системой.
Таким образом, классификация закрепляет интерпретацию элемента в согласованной системе классов и делает её пригодной для дальнейшей работы.
Но принадлежность панели к классу ещё не определяет способ её монтажа, состав сопутствующих работ, сроки поставки и стоимость. Для этих выводов потребуются связи с другими решениями и условиями проекта.
Так мы подходим к следующему уровню задачи. Вертикальные связи показывают, к каким классам относится элемент. Горизонтальные должны связать его с конкретными конструкциями, документами, технологиями, работами и ресурсами. Именно на пересечении этих связей появляется возможность перейти от вопроса “что это за элемент? ”к вопросу“ что его наличие означает для данного проекта?”.
AI/ИИ не должен делать вид, что уверен всегда
Мы научили систему предлагать позицию классификатора. Но тут возникает сразу же вопрос: “что должно произойти после того, как она поставила один из вариантов первым?”
В рассматриваемом подходе исходные характеристики элемента дополняются новыми сведениями в системе классификации. Мы не предполагаем непосредственного изменения исходного файла BIM/ТИМ-модели.
В свойствах элемента сохраняются код и описание предложенной позиции, обоснование выбора, использованные сведения и ссылки на источники. Отдельно фиксируется статус: предложение AI/ИИ, подтверждённое решение или результат экспертного исправления. Для однозначного прочтения кода также важно сохранять название и редакцию классификатора. Поле обоснования должно помогать проверить решение: какие признаки учтены, почему выбран этот кандидат и каких сведений не хватает. Это проверяемое объяснение результата, а не гарантированная запись внутреннего хода вычислений нейросети.
Если эксперт изменяет классификацию, система сохраняет первоначальное предложение, исправленный результат, причину изменения и область применимости решения. Так возникает материал для последующих анализов, повторного использования опыта и подготовки обучающих примеров.
Следующий вопрос — какие предложения можно принимать автоматически, а какие требуют экспертного разбора.
Для практического применения AI/ИИ в строительстве недостаточно убедительного ответа. Нужен понятный порядок действий в случаях, когда сведений мало, они противоречат друг другу или подходят сразу несколько вариантов.
Представим знакомую панель. В одном случае её описание содержит состав, назначение, несущую функцию и тип межслойных связей. В другом — только название и толщину. В обоих случаях нейросеть может поставить какой-то класс первым. Но основания для принятия этих результатов различаются.
Здесь возникает соблазн свести всё к проценту уверенности: например, 98% — пропускаем автоматически, 64% — показываем инженеру.
Прежде чем строить такой светофор, стоит разобраться, что измеряет его шкала.
В предыдущем примере Cross-Encoder выдавал оценки соответствия. Они позволяли упорядочить кандидатов, но не являлись готовыми вероятностями правильного ответа. Перевести такую оценку в диапазон от нуля до ста ещё не значит придать ей вероятностный смысл.
Даже у классификатора, который выдаёт вероятности, высокая численная уверенность может расходиться с фактической точностью. Эту проблему исследовали Chuan Guo и соавторы в работе On Calibration of Modern Neural Networks: на рассмотренных задачах классификации изображений и текстов более точные сети могли оставаться избыточно уверенными. Исследование, ICML 2017.
Практический смысл калибровки прост: если система оценивает множество сопоставимых решений примерно в 90%, доля правильных решений в этой группе должна быть близка к 90%. Это характеристика поведения на множестве случаев, а не подтверждение конкретной панели.
Процент без проверки его смысла — просто число с убедительным значком.
Но и проверенной вероятности недостаточно для разрешения любого действия. Исправить категорию в поисковом каталоге и использовать её для автоматического формирования ведомости — разные по последствиям операции. Поэтому решение об автоматизации должно учитывать и надёжность модели, и полноту данных, и возможную цену ошибки.
Светофор должен управлять действием
Для предлагаемой системы удобно разделить результаты на три потока. Цвет здесь обозначает порядок обработки, а не настроение нейросети.
Поток
Что происходит с результатом
Зелёный (допустима автоматическая обработка)
Случай находится в проверенной области применения системы, необходимые сведения доступны, обязательные проверки пройдены. Результат можно использовать в пределах согласованных полномочий, сохраняя выборочный аудит.
Жёлтый (требуется решение специалиста)
Есть несколько правдоподобных кандидатов или не хватает различающего признака. Эксперт получает варианты, основания и конкретный вопрос, который нужно разрешить.
Красный (автоматическое назначение остановлено)
Обнаружено противоречие, неизвестный системе случай или недостаток критичных сведений. Требуется разбор исходных данных и проектного решения.
Границы между потоками нельзя назначить только потому, что «выше 95% выглядит надёжно». Их следует выбирать по результатам проверки на соответствующих данных и допустимым последствиям ошибки. При этом противоречие обязательному признаку должно останавливать назначение независимо от высокого балла модели.
В машинном обучении есть близкая постановка задачи — selective classification, классификация с возможностью отказа от ответа. Система принимает решение не для всех объектов, а для выбранной части. Исследователи рассматривают соотношение между долей принятых решений и ошибками среди них. Geifman и El-Yaniv показали такой подход на задачах распознавания изображений; их результаты не устанавливают готовые пороги для BIM, но дают основание для самого принципа отказа. Selective Classification for Deep Neural Networks, 2017.
Для нашей задачи это означает вполне конкретное поведение. Если система не различает панель с гибкими и жёсткими связями, полезный ответ выглядит так:
«Найдены два кандидата. Они различаются типом межслойных связей. В доступных данных этот признак отсутствует. Необходимо проверить описание изделия или соответствующий узел«.
Инженеру не приходится начинать поиск с нуля. Перед ним уже сформулирована причина остановки.
При этом зелёная зона не отменяет контроля. Система способна пропустить противоречие или уверенно применить знакомую закономерность к неподходящему случаю. Поэтому нужны выборочные проверки автоматических решений и пересмотр условий автоматизации при смене исходных данных, классификатора или модели.
AI/ИИ делает массовую работу, человек занимается экспертными исключениями
Представим рабочую ситуацию: проектировщик вручную присваивает коды тысячам элементов. Проверяющий открывает выгрузку и просматривает их заново. Заказчик получает результат и организует ещё одну проверку.
Каждый участник может действовать вполне обоснованно. Но если не передаются основания его выбора и результаты предыдущих проверок, следующему участнику приходится восстанавливать их самостоятельно. В таком процессе AI/ИИ полезен не тем, что позволяет объявить проверку ненужной. Он должен изменить то, на что расходуется внимание специалиста.
Система обрабатывает массив элементов, предлагает классы, выполняет заданные проверки и собирает неоднозначные случаи. Эксперт получает не километры одинаковых строк, а конкретные вопросы: почему расходятся два источника, какой признак различает кандидатов, применимо ли типовое правило к этому решению. Но и очередь исключений можно организовать плохо. Если каждый из тысячи одинаковых элементов требует отдельного подтверждения одной и той же причины, мы лишь перенесли ручную работу в другое окно. Полезнее объединять случаи по общей проблеме, сохраняя возможность проверить, действительно ли экспертное решение распространяется на всю группу.
Так мы приходим к разделению труда: “AI/ИИ делает массовую работу, а человек занимается экспертными исключениями”.
Специалист определяет правила допуска к автоматизации и проверяет, как система им следует. Его участие не ограничивается нажатием кнопки «Подтвердить» он управляет системой классификации.
AI/ИИ должен использовать опыт эксперта
Вернёмся к нашей трёхслойной панели. Система предложила класс «с гибкими связями». Инженер открыл узел и установил, что проектом предусмотрены жёсткие связи между слоями. Он меняет классификационную позицию.
Для примера обозначим исходный и исправленный классы как (К₁) и (К₂). Это условные обозначения: реальные коды требуют сверки с выбранной редакцией классификатора.
Если сохранить только замену (К₁) на (К₂), мы исправим текущую запись. Но не объясним системе, почему первоначальное решение оказалось неверным.
Запись «нужно было выбрать другой класс» мало помогает следующему разбору. Значительно полезнее комментарий:
«По узлу У-17 предусмотрены жёсткие связи между слоями. В описании типа этот признак отсутствует. Выбран класс панелей с жёсткими связями. Решение относится к изделиям этой марки, для которых применяется указанный узел«.
Пример условный.
Теперь сохранено не только исправление. Появились источник, различающий признак и границы применимости решения.
Что сохраняем
Для чего
Исходные сведения и предложенный класс
Чтобы воспроизвести ситуацию, в которой возникла ошибка
Исправленный класс и причина изменения
Чтобы понять, какое различие оказалось существенным
Документ, узел и их редакция
Чтобы проверить основание решения
Область применения
Чтобы не распространить частный случай на все похожие элементы
Экспертный комментарий ценен именно этим, он позволяет сделать ход решения доступным для повторного использования и проверки. Сам статус автора комментария не превращает его в безусловную истину. Если специалисты расходятся во мнениях или документы противоречат друг другу, системе нужно сохранить и разрешить это расхождение, а не просто принять последнюю правку.
Сохранить исправление — ещё не значит обучить нейросеть
Здесь легко совершить подмену. Инженер исправил код, запись попала в базу — и мы говорим: «AI/ИИ научился».
Но что именно изменилось?
Если появился только журнал исправлений, поведение модели может остаться прежним. Это похоже на протокол совещания: наличие файла ещё не означает, что его решения учтены в следующем выпуске проекта.
Чтобы опыт начал работать, нужен определённый механизм.
Первый вариант — использовать проверенный прецедент как контекст. При новом похожем случае система находит прежнее решение и передаёт его языковой модели вместе с источником и условиями применимости. Возможность использовать примеры в запросе без изменения параметров модели показана, в частности, в работе Language Models are Few-Shot Learners. Это пример механизма для языковых моделей, а не доказательство его качества на строительных задачах. Brown и соавторы, 2020.
Второй вариант — уточнить правило обработки. Если подтверждено, что определённая марка изделия в данной редакции проекта связана с конкретным узлом, это соответствие можно закрепить в информационной системе. Здесь меняется логика её работы; переобучение нейросети не обязательно.
Третий вариант — использовать исправления для дообучения. Проверенные случаи включают в подготовленную обучающую выборку и выполняют отдельную процедуру обновления параметров. Например, для Cross-Encoder можно подготовить пары описаний с подтверждёнными соответствиями и ошибочными кандидатами. Затем необходимо проверить, улучшилось ли ранжирование на примерах, не использовавшихся для обучения.
Эти варианты не следует смешивать. Добавить пример в запрос языковой модели — не то же самое, что дообучить модель сопоставления.
Исследования обучения на человеческой обратной связи также не дают основания обещать автоматическое улучшение всего сразу. Например, в работе Ouyang и соавторов отдельно рассматриваются сбор оценок, обучение и проверка результатов; авторы описывают как улучшения, так и ухудшения отдельных показателей. Это исследование языковых моделей, но важное для нашей логики различие остаётся: эффект обучения нужно измерять. Training Language Models to Follow Instructions with Human Feedback, 2022.
Опыт должен переноситься вместе с условиями
Предположим, в следующем проекте появилась панель с похожим названием. Должна ли система автоматически повторить прошлое исправление?
Только сходства названий недостаточно. У другой серии изделия может быть другой узел. В новой редакции проекта решение могли изменить. Прежний комментарий остаётся полезным, но его применимость необходимо установить заново.
Поэтому хороший результат повторного использования опыта может выглядеть так:
«В похожем случае классификация была изменена после проверки межслойных связей. Для текущего элемента этот признак также следует уточнить».
Иногда главный урок предыдущей ошибки — не готовый ответ, а понимание того, какой вопрос нельзя пропустить.
В предлагаемом подходе человек включён в контур принятия решений и улучшения системы — Human-in-the-Loop. Схема показывает, как сведения об элементе дополняются предложением AI/ИИ, проходят экспертный разбор и становятся опытом, который можно использовать дальше.
Исходный элемент → обогащённые характеристики → эксперт → память → новый цикл.
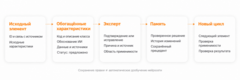
Отправная точка — исходный элемент: его идентификатор, связь с источником и доступные характеристики. На их основе AI/ИИ предлагает классификацию. В системе появляются дополнительные сведения: код и описание класса, обоснование выбора, использованные данные и источники. Пока это предложение, и его статус должен быть виден.
В случаях, требующих экспертного разбора, специалист подтверждает или исправляет результат. При этом важно сохранить не только итоговый класс, но и причину решения, источник подтверждения и область применимости. Например, исправление может относиться к определённой марке панели и конкретному узлу, а не ко всем внешне похожим конструкциям. После проверки решение попадает в память системы вместе с историей изменений. Так формируется прецедент: запись о том, какие сведения были доступны, что предложил AI/ИИ, что установил эксперт и на каком основании.
В новом цикле этот опыт можно использовать при анализе следующего элемента. Но сначала необходимо проверить, подходят ли прежние основания к текущему случаю. Похожее название ещё не означает одинаковое конструктивное решение. Поэтому система должна учитывать применимый прецедент и проверять полученный результат, а не механически переносить исправленный код.
Сохранение правки не равно автоматическому дообучению нейросети. В показанном цикле прежде всего накапливается проверенный опыт системы. Его дальнейшее использование может дополнять контекст, уточнять правила обработки или, после отдельной подготовки, давать материал для дообучения модели.
Эффект стоит оценивать по практическому результату: реже ли повторяются разобранные ошибки, сколько случаев удаётся обрабатывать автоматически при согласованном уровне качества и сколько времени требуется эксперту на оставшиеся исключения.
Главную мысль я сохранил: «классификация открывает путь к связям проекта». Но уточнил границы обещаний. Граф помогает объединять контекст и находить зависимости; расчёт последствий требует отдельных правил и алгоритмов. Убрал неподтверждённую «половину проекта» и противопоставление графов таблицам: «связанная информация может храниться и в существующих системах».
Ниже — расширенный вариант двух разделов. Исследования встроены в рассуждение, а строительные примеры обозначены как условные.
Но классификация — только начало
Мы определили класс элемента, сохранили основания выбора, предусмотрели экспертную проверку. Казалось бы, задача решена и теперь система должна понимать что перед ней, но не всё так просто.
Классификация позволяет отнести элемент к согласованной категории. Благодаря этому его можно найти, включить в нужную выборку, сравнить с другими элементами и использовать в отчётах. Это полезный результат. Однако между ответами «что это за конструкция?» и «что с ней предстоит сделать на этом объекте?» остаётся значительное расстояние.
Каталог запчастей помогает подобрать деталь. Порядок сборки механизма придётся искать отдельно. В строительстве различие ещё заметнее: даже одинаковые изделия могут применяться в разных условиях, требовать разной организации работ и входить в разные договорные обязательства. Поэтому следующий шаг — дополнить принадлежность к классу сведениями о роли элемента в конкретном проекте.
Здесь полезно разделить четыре вопроса.
Вопрос
Что необходимо установить
Идентичность: какой именно элемент?
Как различить конкретный экземпляр, его тип и представления в разных источниках
Роль: что он делает в этом объекте?
Какую функцию выполняет, в какую систему входит, какие решения от него зависят
Свойства и требования: что о нём известно?
Какие характеристики заданы или рассчитаны, какие требования предъявлены и чем подтверждено их выполнение
Контекст: с чем он связан?
Какие узлы, документы, работы, ресурсы, поставки и решения относятся к этому элементу
Эти вопросы нельзя заменить одним подробным названием класса. Код не указывает, в какой монтажный участок попала панель, по какой версии выполняется монтаж и какой поставщик должен привезти изделие на площадку.
Вернёмся к нашей панели. Классификатор описывает её как трёхслойную наружную несущую железобетонную конструкцию. Допустим, принадлежность установлена правильно. Теперь попробуем ответить на практический вопрос: какие работы необходимы для её установки?
Само название класса не определяет состав работ полностью. Потребуются сведения о соединениях, временном закреплении, обработке стыков и принятой технологии. Для планирования понадобится понимать, где устанавливается панель, какие конструкции должны быть готовы до её монтажа и какие ресурсы доступны. Если перейти к закупкам, появится ещё одно представление: марка изделия, количество, поставщик, партия и срок поставки. В договоре те же работы могут быть объединены в укрупнённую позицию. В графике одна операция может охватывать несколько панелей, а в ведомости изделия будут перечислены по отдельности.
Мы рассматриваем один физический объект, но разные задачи требуют разных связей вокруг него.
Особенно хорошо это видно на стыках. В условном примере две соседние панели образуют соединение, которое необходимо герметизировать. Если каждой панели независимо назначить полный объём работ по этому соединению, возникает риск двойного учёта. Если рассматривать только сами панели, соединение можно вообще потерять.
Значит, системе нужно представить не только изделия, но и сам стык, его участников, проектное решение и относящуюся к нему работу. Одного поля «код классификатора» для этого недостаточно.
Работы могут возникать между элементами. В каталоге отдельных изделий их легко не заметить.
Поэтому классификация становится опорой для следующего уровня описания. Она помогает выбрать подходящие типовые связи и правила, которые затем необходимо проверить на условиях проекта.
Например, класс панели может подсказать перечень возможных монтажных операций. Но какие из них действительно применимы, определяют проектные и технологические решения. Здесь сохраняется знакомое нам различие: типовая связь — кандидат, связь с конкретным объектом — утверждение, которому нужны основания.
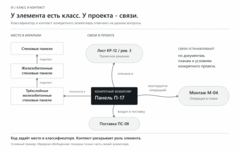
Такой переход исследуется в строительной информатике уже давно. Pauwels, Zhang и Lee в обзоре семантических технологий для архитектуры, проектирования и строительства выделяют три направления: обмен информацией между приложениями, связывание разных предметных областей и использование формализованной логики. При этом создание и поддержание связей между наборами данных авторы относят к нерешённым исследовательским задачам. Semantic Web Technologies in AEC Industry: A Literature Review, 2017.
Для нашего подхода это существенный вывод. Присвоить код — значит зафиксировать принадлежность к классу. Чтобы перейти к работам, ресурсам и стоимости, необходимо построить и поддерживать отношения с другими сущностями проекта.
От классификатора к контексту
BIM/ТИМ-модель даёт удобную точку входа: элементы, геометрию, параметры и часть связей между ними. Но состав доступных сведений зависит от проекта, стадии и требований к моделированию. Универсального процента, который показывал бы, какую долю проекта содержит любая BIM/ТИМ-модель, здесь нет.
Для нашей задачи важнее то, что необходимые сведения могут находиться за пределами доступной модели. В одном источнике хранится конструктивное решение. В другом — состав работ и правила определения объёмов. В третьем — календарный план. В четвёртом — договор, заказ или подтверждённая поставка. Эксплуатационные сведения могут появиться значительно позже.
Это разные виды информации. Классификатор задаёт категории. Сметная база содержит нормы, ресурсы и стоимостные данные в пределах своей структуры. Календарный график описывает операции и зависимости во времени. Договор устанавливает обязательства сторон. Они не обязаны повторять устройство друг друга. Но системе необходимо понимать, где их сведения относятся к одному объекту или процессу.
Представим, что проектировщик использует обозначение панели, закупщик — артикул поставщика, а подрядчик — укрупнённую позицию договора. Простого совпадения названий может не быть. Более того, один заказ способен включать изделия для нескольких монтажных участков, а одна договорная позиция — несколько видов работ.
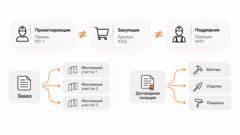 Многозадачные связи
Задача интеграции заключается в установлении этих соответствий с сохранением их смысла.
Почему одной большой таблицы недостаточно
В такой ситуации хочется собрать всё в одном месте, добавить к элементу столбцы с работами, ценами, сроками, поставщиками и договорами. Для ограниченной задачи это может быть вполне рабочим решением.
Сложности начинаются, когда отношения перестают укладываться в схему «одна строка — одно значение». Один элемент участвует в нескольких работах. Одна работа относится к группе элементов. Поставка распределяется между участками. Узел связывает несколько конструкций. У каждой связи могут быть собственные условия, источник и история изменений.
Табличные и реляционные системы способны хранить такие отношения. Поэтому вопрос не в том, что таблицы принципиально не подходят, а графы автоматически решают проблему. Важно, насколько явно описаны сущности и отношения между ними, насколько удобно (удобно — любимое слово всех продуктологов: “нет” ) их развивать и использовать в запросах.
Существующие базы при этом можно сохранить. Например, рекомендация W3C R2RML описывает способ представления реляционных данных в виде RDF-графа, включая варианты доступа к связанному представлению без обязательного переноса всей базы в новое хранилище. R2RML: RDB to RDF Mapping Language.
RDF-граф (Resource Description Framework) - это способ представления информации в виде взаимосвязанных данных, где каждый факт описывается тройкой: субъект → отношение → объект.
Например: “Стена → состоит из → трёх слоёв”.
Такая структура позволяет формировать сеть знаний, в которой объекты, их свойства и связи между ними имеют однозначное значение. Для предлагаемого подхода это означает, что нам не обязательно создавать новый «главный справочник всего». Можно выстроить слой связей между существующими источниками.
Что добавляет граф знаний
Граф знаний проекта представляет сущности и содержательные отношения между ними. Элемент модели, монтажная операция, документ, поставка или договор могут быть представлены отдельными узлами. Связи показывают, как именно они относятся друг к другу. Выделю здесь ключевое слово — «как».
Запись «панель связана с документом» почти ничего не объясняет. Документ может задавать конструкцию панели, подтверждать её характеристики, содержать замечание или фиксировать изменение. Для дальнейшего анализа это разные отношения.
 Граф де Ла Фер
В условном примере часть контекста панели можно представить так:
Сущность
Отношение
Связанная сущность
Панель П-17
Относится к классу
Трёхслойные наружные несущие ЖБ-панели
Панель П-17
Соединяется по решению
Узел У-17, редакция 3
Монтажная операция М-04
Охватывает
Панель П-17 и другие изделия участка
Операция М-04
Требует готовности
Опорных конструкций
Партия поставки ПС-08
Включает
Изделия для участка
Договорная позиция Д-12
Устанавливает обязательства по
Соответствующим работам
Теперь можно двигаться по цепочке от элемента к монтажной операции, от операции к условиям её начала, от изделий к поставке. Это позволяет задавать вопросы, выходящие за пределы поиска по коду.
Например: какие работы следующего периода зависят от изделий, поставка которых ещё не подтверждена? Какие элементы используют изменённый узел? Какие ведомости сформированы на основании прежней редакции решения?
Для этого связи должны быть определены и заполнены. Само появление графовой базы не создаёт отсутствующие сведения.
Показательный пример такого устройства — Building Topology Ontology, или BOT.
Building Topology Ontology (онтология топологии здания) — это формализованная модель знаний, описывающая структуру здания, его пространственные элементы и взаимосвязи между ними (здание → этаж → помещение → конструктивный элемент)
Она задаёт базовые понятия здания, этажей, пространств и элементов, а также отношения между ними. Авторы описывают её совместное использование с другими онтологиями и проверяют подход через экспорт и запросы к трём реальным крупным моделям зданий. Это исследование конкретного слоя строительного контекста, а не готовая модель всех процессов девелопера. Rasmussen и соавторы, BOT: The Building Topology Ontology.
Такой принцип полезен и нам. Пространственное устройство, классификацию, работы и поставки можно описывать согласованными частями, соединяя их через общие сущности.
Связи тоже требуют оснований
На предыдущем этапе мы сохраняли причину выбора класса. При переходе к графу это требование распространяется и на отношения.
Почему считается, что данная операция относится к этой панели? Откуда известно, что поставка обеспечивает конкретный участок? Кто подтвердил применение узла?
Для существенной связи важно знать источник, редакцию, статус и область действия. Предложение AI/ИИ следует отличать от подтверждённого соответствия. Планируемую поставку — от заказанной, а заказанную — от фактически полученной.
Иначе система легко ответит на вопрос «можно ли начинать монтаж?», используя факт, что изделие когда-то включили в заявку.
Для описания происхождения информации существуют специальные модели. Например, W3C PROV-O позволяет представлять, какие данные использовались, в результате какой деятельности появились новые сведения и какие участники связаны с их созданием. Это основа для хранения происхождения утверждений, а не автоматическая проверка их истинности. PROV-O: The PROV Ontology.
В предлагаемой системе такой подход продолжает уже введённую логику обогащения характеристик. Исходные сведения сохраняют связь с источником, а новые отношения получают собственные основания и статус проверки.
Что происходит при изменении
Здесь важно не приписать графу лишних способностей. Допустим, выросла цена материала. Значит ли это, что автоматически изменились логистика и срок монтажа?
Не обязательно. Стоимость может вырасти при прежних объёмах, поставщике и сроках. Договорные условия могут вообще исключать изменение цены уже заказанной партии. А вот замена изделия на более тяжёлое способна потребовать проверки условий подъёма, перевозки и технологии монтажа. Какие последствия действительно возникнут, зависит от конкретных ограничений и решений.
Граф помогает найти затронутые сущности и проследить зависимости. Чтобы рассчитать последствия, нужны дополнительные механизмы: правила измерения, формулы стоимости, производительность ресурсов, календари, технологические ограничения и алгоритмы планирования.
Карта дорог показывает связи. Время поездки приходится рассчитывать отдельно.
В строительных исследованиях это разделение хорошо видно. Niknam и Karshenas описывают приложение, объединяющее BIM/ТИМ-данные, знания о сметных комплексах и информацию поставщиков для подготовки оценки стоимости. Авторы прямо ограничивают цель сокращением повторяющихся операций, а не полной автоматизацией сметного процесса. Integrating Distributed Sources of Information for Construction Cost Estimating, 2015.
Другой пример — работа Soman и Molina-Solana по краткосрочному планированию. В ней проверка ограничений на основе связанных данных сочетается с обучением с подкреплением для формирования графика. Связанные данные обеспечивают контекст и проверку условий, а план строит отдельный алгоритм. Automating Look-Ahead Schedule Generation for Construction, 2022.
Поэтому рабочая последовательность выглядит так: «Изменение → поиск затронутых связей → проверка условий → расчёт последствий → согласование решения».
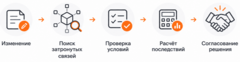
Часть этих операций можно автоматизировать. Но возможность автоматизации определяется доступными данными, правилами и полномочиями системы.
В этой архитектуре AI/ИИ помогает извлекать сведения, предлагать соответствия и разбирать неоднозначные описания. Граф сохраняет установленный контекст. Правила и расчётные алгоритмы используют его для конкретных задач. Эксперт разрешает случаи, для которых оснований или формализованных условий недостаточно.
Так классификация становится точкой входа в граф знаний проекта. Через неё мы переходим от согласованного названия элемента к его роли, связям и последствиям решений. И следующий полезный вопрос звучит уже предметно: какие связи необходимо установить, чтобы из сведений об элементе получить обоснованный состав работ?
Граф как способ увидеть связи
Вернёмся к панели П-17. В конструктивной модели у неё есть геометрия и параметры. В классификаторе ей соответствует позиция «Трёхслойные железобетонные стеновые панели». На фасаде у неё есть общий стык с соседней панелью, а в ведомости объёмов работ она участвует в расчёте монтажа. Чтобы использовать эти сведения вместе, нужно зафиксировать, что с чем связано, что означает эта связь и на каком основании она установлена.
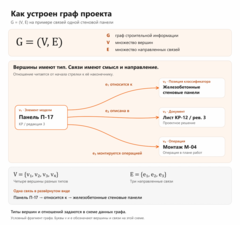
Предлагаемую модель можно описать как типизированный ориентированный граф (G = (V, E)), где (V) — множество вершин, а (E) — множество направленных связей между ними. Вершиной может быть элемент модели, позиция классификатора, чертёж или строка расчёта. У связи тоже есть тип. Панель относится к классу, описана в чертеже и монтируется определённой операцией. Тип связи подсказывает, по каким рёбрам идти, чтобы ответить на конкретный инженерный вопрос.
Класс панели на схеме показан на укрупнённом уровне. В примере поиска ниже используется более подробное назначение.
Что связывает граф
Какие сущности участвуют
Какой вопрос можно задать
Классификация
Элемент модели, назначение класса, позиция справочника и её иерархия
Что это за элемент и по каким категориям его можно найти?
Атрибуты
Определение параметра, требование к заполнению, значение и его источник
Какие сведения нужны об элементе и какие уже доступны?
Работы и объёмы
Элемент или стык, правило отбора и измерения, позиция ВОР, версия расчёта
Что вошло в расчёт и откуда взялся объём?
Стоимость
Позиция ВОР, расценка и источник цены
Какая расценка применена и на каких условиях?
Записи элементов и их параметры могут оставаться в реляционной базе, а граф связывает их с классификатором, документами и расчётами. Для перехода к исходной записи нужны идентификатор элемента, идентификатор модели и её редакция. Один и тот же справочник при этом можно использовать для нескольких моделей. Если для связей выбрано RDF-представление, один из способов отобразить в него данные реляционной базы описан в рекомендации W3C R2RML. W3C R2RML, раздел 1, Rasmussen и соавторы, Building Topology Ontology.
Здесь уместна аналогия с библиотечным каталогом. По одной рубрике можно найти книги в нескольких отделах, а по каталожной записи — нужное издание. В нашем случае рубрика соответствует позиции классификатора, а результат поиска ведёт к экземпляру в определённой редакции модели. Инженер может открыть исходную запись и проверить, какие сведения стоят за результатом поиска.
Что хранит назначение класса
Связь панели с классом можно представить отдельной записью о назначении. Например, панель П-17 связана с назначением М-03, которое указывает на позицию «Трёхслойные железобетонные стеновые панели». Такой узел может объединять несколько элементов одной редакции модели, если им назначен один класс. При этом у каждого элемента могут быть свои основания и свой статус проверки.
В системе классификации с назначением можно хранить код и описание позиции, редакции модели и классификатора, основание выбора и статус проверки. Допустим, ИИ предложил класс по описанию типа и составу панели, а инженер подтвердил его по спецификации. В записи останутся и предложение, и его основание, и результат проверки со ссылкой на источник. Эти сведения связаны с исходным элементом и могут использоваться в следующих запросах и расчётах.
Как граф выполняет поиск по нескольким моделям
Допустим, инженер просит показать все стеновые панели объекта. Система находит позицию «Стеновые панели», обходит её дочерние позиции на всех уровнях и ищет назначения, которые указывают на любой найденный класс, включая исходный. Через назначения она выходит на конкретные экземпляры из выбранных редакций моделей. Панель П-17 найдётся по широкой категории, хотя её прямое назначение указывает на более узкую позицию.
Здесь работает транзитивный обход иерархии. Если трёхслойные железобетонные панели входят в категорию железобетонных стеновых панелей, а те входят в категорию стеновых панелей, поиск по общей категории охватывает обе ступени. В SKOS непосредственную связь с более широкой категорией описывает skos:broader, а для транзитивного вывода предусмотрено отношение skos:broaderTransitive. В SPARQL путь skos:broader* позволяет проверить, можно ли пройти от назначенного класса к искомому. Ноль переходов соответствует прямому назначению на искомый класс, один и более — назначению на его дочернюю позицию. W3C SKOS, раздел 8.6.6 · W3C SPARQL, раздел 9.
Для других запросов нужны другие связи. Стеновой блок классифицируется как изделие, а стена из блоков — как конструкция. Для запроса «Покажи блоки» система ищет записи об изделиях. Для запроса «Покажи стены из блоков» она отбирает стены и проверяет их состав по отношению «выполнена из» или по связанному описанию конструкции.
Рассмотрим запрос «Покажи наружные стены второй секции, выполненные кладкой из блоков». Система проверяет четыре условия.
-
Элемент относится к классу стен или к одной из допустимых дочерних позиций.
-
В проекте подтверждено, что это наружная стена во второй секции.
-
Материал и способ устройства соответствуют запросу. Основанием служит проверенный параметр модели, описание состава или проектный документ.
-
Элемент представлен в выбранных редакциях моделей. Если одна стена показана и в АР, и в КР, система объединяет результаты только при подтверждённой связи между двумя представлениями одного экземпляра.
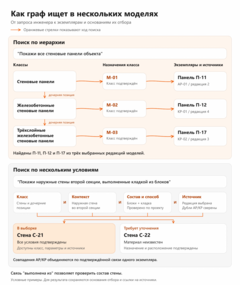
AI/ИИ помогает превратить формулировку инженера в условия поиска. Графовый запрос отбирает экземпляры, для которых найдены нужные связи и значения. Если расположение и назначение стены подтверждены, а материал неизвестен, система может вывести её среди элементов, требующих уточнения. Для каждого подтверждённого результата она показывает основания отбора, чтобы инженер мог проверить, почему стена попала в выборку.
Как граф связывает классы и требования к атрибутам
Мы нашли стеновые панели в нескольких моделях. Теперь проверим, хватает ли сведений о каждой из них. Допустим, к выпуску рабочей документации заказчик требует указать марку изделия, массу и обозначение секции. В предлагаемом графе класс «Стеновые панели» связан с этими требованиями, а каждый экземпляр — со своими значениями и их источниками.
На примере массы удобно различить три записи.
-
Определение параметра задаёт, что именно измеряется и в каких единицах. В нашем примере речь о массе одной панели в килограммах.
-
Требование указывает, для какого класса и к какому этапу нужно предоставить значение. К выпуску рабочей документации масса должна быть указана для каждой стеновой панели.
-
Значение относится к конкретному экземпляру. Например, для панели П-17 в третьей редакции спецификации указана масса 2 480 кг. Вместе со значением сохраняется ссылка на эту редакцию.
При проверке система по классу панели определяет, какие параметры обязательны на выбранном этапе, и ищет их значения в доступных данных. Если для П-17 масса не найдена, в отчёте появится конкретный пропуск. Заполнить его можно по согласованному источнику или по принятому в проекте правилу расчёта.
Определения параметров нужны и при объединении данных. Если 200 мм в модели и 0,2 м в спецификации обозначают полную толщину одной и той же стены, после перевода единиц значения совпадут. Если в одном файле поле «Толщина» описывает стену целиком, а в другом — только её несущий слой, этим полям соответствуют разные определения.
После сопоставления полей можно проверять наличие обязательных значений и их тип. Например, в RDF-графе с помощью SHACL можно задать правило, по которому у панели должно быть хотя бы одно значение массы, записанное числом заданного типа. W3C SHACL, ограничения на тип и число значений.
Как формируется ведомость объёмов работ
В новой редакции BIM-модели появилась ещё одна стеновая панель. Объём монтажа в ведомости объёмов работ (ВОР) может вырасти на одну штуку. А что произойдёт с герметизацией? Это зависит от того, какие стыки появились по проекту и выделена ли герметизация отдельной строкой. Девелопер может заранее определить, как обрабатывать такие случаи, и применять эти правила при каждом выпуске модели.
Девелопер связывает позиции классификатора с правилами формирования ВОР. По классу элемента система находит применимые правила. Каждое из них указывает, какие объекты входят в позицию ведомости, какие данные взять и как измерить объём. Например, для монтажа можно отбирать панели заданных классов в границах пакета работ, учитывать каждый экземпляр один раз и группировать результат по секциям. Инженер утверждает порядок для типового случая, после чего алгоритм применяет его к очередной редакции модели.
В прототипе, описанном Chen и соавторами, программа сопоставляла данные BIM-элементов с кодами строительной классификации, вызывала соответствующие правила измерения и формировала ведомость. В предлагаемой архитектуре связка «класс — правило» позволяет применять методику конкретного девелопера. Chen и соавторы, 2022, разделы 4.2 и 5.
Возьмём панели П-17 и П-18. Обе относятся к железобетонным стеновым панелям и входят в пакет работ по второй секции. Правило включает оба экземпляра в позицию «Монтаж стеновых панелей». Расчёт даёт 2 шт.
Для позиции «Герметизация межпанельных стыков» действует другое правило. От панелей граф ведёт к записи об их общем стыке С-01. Алгоритм берёт его длину из согласованной развёртки фасада и учитывает стык один раз. В ведомость попадает 3 пог. м. Если в другом пакете работ герметизация входит в состав монтажа, правило этого пакета учитывает её в составе соответствующей позиции.
Эти два расчёта показывают, зачем разделять правило отбора и правило измерения. Первое определяет, какие объекты попадут в расчёт: два экземпляра панелей или одна запись о стыке. Второе определяет вклад каждого объекта: одну штуку или длину в метрах. Для позиций, объём которых складывается из отдельных вкладов, расчёт можно записать так.
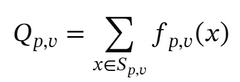
Здесь (p) — позиция ВОР, (v) — версия расчёта, (S_{p,v}) — выборка по правилу отбора, а (f_{p,v}(x)) — вклад объекта (x), определённый по правилу измерения в единице этой позиции.
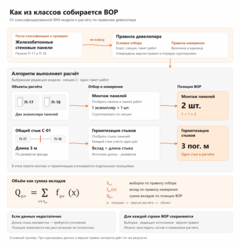
AI/ИИ помогает классифицировать элементы и выделять спорные назначения для проверки. Когда классы подтверждены, объёмы считает алгоритм. При одинаковых исходных данных и той же версии правил он даёт тот же результат. Если для С-01 не найдена длина, система указывает, какого значения не хватает, и отмечает позицию герметизации как рассчитанную не полностью.
По каждой строке ВОР сохраняется состав выборки, редакции источников и версия правила. При переходе от двух панелей к трём инженер может увидеть, какой экземпляр добавился в расчёт. При изменении методики он может установить, какое правило изменилось и на какие строки это повлияло.
Как граф помогает проверить стоимость и последствия изменений
К проверенной строке ВОР можно привязать расценку из сметы, коммерческого предложения или корпоративной базы. Вместе с суммой нужны валюта, единица измерения, дата, состав работ и условия применения. Два предложения по 1 200 ₽ за метр могут покрывать разный объём обязательств, если одно включает материалы, а второе относится только к работам. Пример объединения BIM-данных, сведений о работах подрядчика и цен поставщиков рассмотрен в исследовании Никнама и Каршенаса. Niknam и Karshenas, 2015.
Для герметизации стыка С-01 примем условную расценку 1 200 ₽ за погонный метр с материалами, без НДС. При длине 3 м стоимость позиции составляет 3 600 ₽. Допустим, в новой редакции развёртки длина того же стыка увеличилась до 3,2 м. По ссылкам на прежнюю редакцию система определяет, какие данные использовались в расчёте. Она находит запись о стыке, строку герметизации и связанную с ней стоимость.
Если новая длина подтверждена и расценка по-прежнему применима, новая стоимость составит 3 840 ₽. При неизменном составе панелей объём монтажа останется 2 шт. В новой версии расчёта сохраняется основание пересчёта, а из прежней можно восстановить, откуда взялись 3 м и 3 600 ₽. Для формального описания такого происхождения данных подходит PROV-O, где можно связать исходные сущности, действия обработки и полученные результаты. W3C PROV-O, раздел 3.1.
Как проверить предлагаемый метод
Для проверки нужен набор из нескольких проектов с проверенными назначениями классов, согласованными исходными данными и контрольной ВОР. В нём стоит предусмотреть характерные пограничные случаи. Панель представлена в двух моделях, материал стены неизвестен, две соседние панели ведут к одному стыку, часть изделий описана только в спецификации, очередная редакция чертежа меняет длину стыка.
На этом наборе можно отдельно проверить три результата.
1. Классификация и экспертные исключения. Как часто верный класс попал в список кандидатов, сколько принятых назначений оказалось правильным, какую долю случаев удалось обработать автоматически и сколько времени заняли подготовка данных и экспертная проверка по сравнению с исходным процессом. Эффект от использования экспертных правок проверяют на других проектах.
2. Поиск и формирование ВОР. Какие элементы найдены и какие пропущены, совпадают ли состав выборки и объём по каждой позиции с контрольными, можно ли воспроизвести расчёт по сохранённым данным и правилам.
3. Реакция на изменения. Находит ли система именно те строки, которые затронула новая редакция. Их перечень инженер задаёт заранее, чтобы сравнить ожидаемый результат с тем, что найдено по графу.
В начале статьи мы спрашивали, что значит понимать строительный объект. В нашей задаче это можно проверить одним вопросом. Почему в ведомости указано 3,2 метра герметизации и каких конструкций касается эта работа?
Инженер открывает строку ведомости и видит стык С-01, две панели, редакцию развёртки и правило измерения. Если цифра расходится с проектом, он может определить, где возникла ошибка: в исходном значении, в связи с элементами или в правиле расчёта. По такому ответу можно вернуться к проектному решению и повторить расчёт.
Источник: habr.com