
Всем привет, меня зовут Сергей Прощаев, и в этой статье расскажу про эксперимент, после которого иначе читаешь зелёную строку в отчёте об A/B‑тесте и по‑новому смотришь на данные в продуктовой аналитике.
Я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce и преподаю на курсах разработки и архитектуры в ОТУС.
Знакомая картина. Тест новой формы заказа показал относительный рост конверсии на 6%, p‑value 0,03, команда выкатывает вариант и закладывает шесть процентов в план. Через квартал рост найти не удаётся. Начинается разбор: новизна прошла, сезон сменился, соседний релиз помешал.
Всё это бывает. Но у такого разрыва есть причина, которой не нужны ни сезон, ни релиз, и она сидит в самой процедуре.
Мощность в этой статье — вероятность получить значимый результат именно в ожидаемую сторону, формально P(Z > 1,96) при настоящем эффекте и двустороннем уровне 5%. Если она ниже 50%, значимый рост обязан быть больше настоящего, иначе он не прошёл бы порог. Это явление называют проклятием победителя (Winner’s Curse).
Я решил посчитать, во сколько раз, и получил цифры, которые стоит знать до следующей презентации результатов.
Кнопка, которая дала плюс 55%
В декабре 2023 года Journal of Consumer Research опубликовал онлайн работу Бисваса, Абелл и Чако: в одном из её исследований скругление веб‑элементов увеличило CTR на 55% при p‑value 0,037.
В том тесте было 919 визитов. Звучит как находка на миллион, и звучит подозрительно. Кохави, Гельман, Имбенс и соавторы в статье для Econ Journal Watch пишут, что настоящие эффекты таких правок по их опыту обычно меньше одного процента и редко больше двух‑трёх.
Они провели три теста, каждый на аудитории более чем в две тысячи раз больше исходной. Оценки оказались примерно на два порядка меньше заявленных: 0,16%, 0,29% и 0,73%, а доверительные интервалы включали ноль.
Первая строка их аннотации формулирует механизм прямо: в исследованиях с мощностью ниже 50% значимая положительная оценка вынуждена преувеличивать настоящий эффект, чтобы пройти порог.
На KDD 2026 часть тех же авторов показала продолжение.
Восемь тестов по четырём популярным приёмам, медиана 2,4 млн пользователей на тест. Значимый эффект в ожидаемую сторону дали только два, один оказался значимым в обратную сторону, а остальные значимости не дали.
И главное для практика: даже при таких объёмах мощности не хватило на выручку на пользователя и конверсию в покупку, поэтому в приемлемые сроки авторам пришлось оценивать эффекты по промежуточным метрикам: CTR и числу добавлений в корзину.
Обычно считают так: тест значим, значит, эффект настоящий и примерно такого размера. Обе половины сложнее, чем кажется. Значимость лишь отвергает нулевую гипотезу при заданном уровне ошибки, а на вопрос о размере p‑value не отвечает.
Механизм: порог задаёт минимум
Представьте конверсию 5% и 44 137 пользователей на группу. Настоящий рост от варианта равен 2%. Стандартная ошибка относительного роста здесь около 2,93%, то есть шум в полтора раза больше сигнала.
Чтобы стать значимым, наблюдаемый рост должен превысить 1,96 стандартной ошибки:
def minimal_significant_lift(users, base): """Расчётный порог значимого роста при этой выборке.""" return ALPHA_Z * se_relative(users, base)def se_relative(users, base): return math.sqrt(2 * (1 - base) / (base * users))minimal_significant_lift(44137, 0.05) # 0.0575, то есть 5,75%Вот и вся ловушка. При таком объёме расчётный порог значимого роста около 5,75%. Оценка около 2% этот порог не пройдёт: тест либо промолчит, либо покажет почти втрое больше, либо изредка даст значимый минус.
Сама оценка эффекта до отбора честная: если усреднить все тесты, получится примерно 2%. Завышение появляется, когда мы оставляем только положительные результаты, прошедшие порог.
Как это выглядит в потоке решений, показано на схеме:
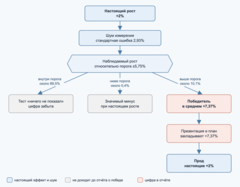 Значимость работает как фильтр: до отчёта доходит только верхний край шума
Главная мысль схемы: завышение появляется не из‑за ошибки в расчётах и не из‑за плохих данных. Отдельный тест посчитан честно, а смещение создаёт отбор: мы смотрим на цифру только тогда, когда она прошла порог.
Что я проверил
Формула выше красивая, но я не хотел верить ей на слово, поэтому собрал симуляцию.
Настоящий рост задан заранее и равен 2%, конверсия контроля 5%. На каждую строку таблицы 200 000 тестов, проверка распространённым z‑тестом двух долей, seed фиксирован.
Значимый минус в мощность не входит, его считаю отдельно. Ядро занимает несколько строк:
conv_a = rng.binomial(users, BASE, RUNS)conv_b = rng.binomial(users, BASE * (1 + TRUE_LIFT), RUNS)z = z_scores(conv_a, conv_b, users)lift = relative_lift(conv_a, conv_b)winners = z > ALPHA_Zratio = lift[winners].mean() / TRUE_LIFTДо любых выводов я проверил сам стенд. Тесты без эффекта дали 5,02% значимых результатов при ожидаемых 5%, измеренная мощность совпала с расчётной, а наибольшее расхождение коэффициента завышения в симуляции и по формуле составило 0,096: одно из различий в том, что формула делит на постоянную конверсию контроля, а симуляция на наблюдаемую.
В рамках заданной модели стенд воспроизводит ожидаемое.
Мощность
Пользователей на группу
Минимальный значимый рост
Средний рост победителя
Завышение
10%
44 137
5,75%
7,37%
3,68
20%
119 940
3,49%
4,57%
2,28
30%
197 633
2,72%
3,65%
1,82
50%
368 393
1,99%
2,83%
1,41
80%
752 700
1,39%
2,26%
1,13
95%
1 246 180
1,08%
2,06%
1,03
Читать таблицу стоит снизу вверх. Настоящий эффект во всех строках один и тот же, меняется только число пользователей, а значит, и шум.
Чем меньше пользователей, тем выше порог и тем сильнее цифра в отчёте отрывается от настоящей.
Дальше несколько наблюдений.
-
Мощность 80% не отменяет завышения. Даже в хорошо спланированном тесте победитель показывает 2,26% вместо 2%. Мелочь для решения, но заметная для прогноза в рублях. Речь о среднем: при мощности 80% выше настоящего эффекта оказываются примерно 62% победителей, остальные его недооценивают. Ниже 50% выше оказываются почти все. Проблема становится серьёзной ниже 50%, и авторы работы с KDD считают, что именно такими были многие эксперименты, откуда взялись громкие цифры. Размер выборки легко занизить незаметно: достаточно посчитать его от эффекта, на который надеешься, а не от того, который правдоподобен.
-
При малой мощности появляются значимые результаты с неверным знаком. При мощности 10% таких 3,78% среди всех значимых, вариант на самом деле лучше, а тест уверенно говорит, что хуже. При мощности 50% и выше их доля в таблице округляется до нуля.
-
Пользователи нужны в количествах, которых часто нет. Для мощности 80% при конверсии 5% рост в 10% требует 31 231 пользователя на группу, рост в 5% уже 122 121, в 2% 752 700, а в 1% почти 3 млн. Если настоящие эффекты обычно меньше процента, большинству продуктов честно измерить их негде. Отсюда и вывод авторов KDD про косвенные метрики.
-
Остановка на первой значимости завышает эффект даже в мощном тесте. Смотреть на дашборд можно. Проблема начинается, когда решение принимают при первом p‑value ниже 0,05 с обычным порогом. Я взял 14 дней и итоговую мощность 80%, проверял значимость каждый день и останавливал тест на первом срабатывании. Без настоящего эффекта доля значимых результатов выросла с 5,00% до 21,85%, это известная цена подглядывания. Менее известно другое: при настоящем эффекте завышение выросло с 1,13 до 1,65, а медианный день остановки оказался пятым. Ранняя остановка ловит именно момент, когда шум сложился удачно. Для промежуточных решений нужны последовательные методы: заранее заданные границы остановки или always‑valid‑интервалы.
-
В потоке тестов завышение больше, чем в одном тесте. Выше настоящий рост был фиксирован, а идеи бывают разные. Для этого сценария я задал настоящие эффекты нормальным распределением со средним ноль и разбросом 1%. Порядок величины близок к опыту Кохави и соавторов, но само распределение — моё допущение, а не их оценка. Модель здесь тоже другая: наблюдаемая оценка равна настоящему эффекту плюс нормальный шум, без биномиальной симуляции.
Пользователей на группу
Заявлено победителями
На самом деле
Завышение
Победитель на самом деле вредит
20 000
10,32%
0,50%
20,51
30,3%
100 000
4,71%
0,98%
4,78
13,6%
500 000
2,33%
1,33%
1,76
3,0%
Строка про 20 000 пользователей и есть тот самый случай из заголовка: заявлено больше 10%, на самом деле полпроцента, и почти каждый третий выкаченный «победитель» снижает конверсию. Эту долю задаёт допущение: при нулевом среднем идеи до теста в среднем бесполезны.
Если команда заранее отбирает гипотезы с положительным ожидаемым эффектом, вредных победителей будет меньше.
Что возвращает оценку на место
Я сравнил несколько способов на потоке со 100 000 пользователей на группу и разбросом эффектов 1%.
Настоящий средний рост победителей здесь 0,99%, а сами они заявляют 4,72%. От таблицы выше цифры отличаются, потому что выборка другая.
Способ
Оценка
На самом деле
Завышение
Доля первых победителей
Взять цифру как есть
4,72%
0,99%
4,77
100%
Повторный тест, считать все повторы
1,00%
0,99%
1,01
100%
Повторный тест, только победившие снова
4,82%
1,69%
2,84
9,3%
Снижение к среднему, разброс по истории
0,97%
0,99%
0,98
100%
То же при тяжёлых хвостах эффектов
0,98%
1,13%
0,87
100%
Самая неочевидная здесь третья строка. Правило «подтвердили повторным тестом» звучит строго, и как фильтр оно действительно поднимает настоящий рост с 0,99% до 1,69%. Но если записать в отчёт цифру только у тех, кто победил второй раз, завышение возвращается: почти втрое.
В таблице значение при основном seed, на 40 других оно меняется от 2,8 до 3,0. Отбор по значимости снова сделал своё дело. Без нового отбора остаётся только среднее всех повторов, включая незначимые. Оно честно оценивает группу первых победителей, но не эффект каждого отдельного изменения и не средний эффект всех исходных идей.
Снижение к среднему в простом варианте занимает одну строку:
def shrink_factor(tau, se): """Доля наблюдаемого роста, которая остаётся при разбросе настоящих эффектов tau.""" return tau ** 2 / (tau ** 2 + se ** 2)Смысл понятен без формул: чем больше шум относительно обычного разброса эффектов, тем меньше наблюдаемой цифре можно верить и тем сильнее она тянется к нулю.
Это простое нормальное байесовское сжатие к нулю. На платформах экспериментов применяют более сложные варианты: например, в Bayesian Hybrid Shrinkage, проверенном на экспериментах Meta, у каждого теста свой локальный коэффициент.
Последняя строка таблицы показывает честную цену такой простоты: когда редкие большие эффекты существуют, простая формула начинает занижать. Как выбрать путь для конкретного победителя, показано на схеме:
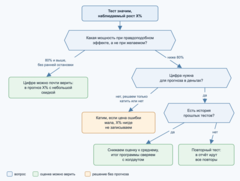 Что делать с победителем: решение катить и цифра для прогноза разделяются
Главная мысль схемы: решение катить и цифра для прогноза не обязаны совпадать. Выкатить вариант при низкой мощности иногда разумно, если он дешёвый и не вредит защитным метрикам. Заносить его результат в план нельзя.
Ограничения
Это симуляция, а не данные конкретного продукта. Она показывает механизм и его масштаб, но не отвечает, какая доля завышения у вас.
Таблицы про конверсию опираются на биномиальную метрику. У выручки на пользователя дисперсия обычно больше, и пользователей нужно ещё больше. Обратное тоже верно: снижение дисперсии вроде CUPED при том же размере выборки поднимает мощность и уменьшает завышение.
Распределение настоящих эффектов в таблицах потока задано допущением. Разброс 1% — мой иллюстративный сценарий, близкий по порядку к эффектам правок интерфейса у Кохави и соавторов, а не оценка стандартного отклонения.
Если ваши изменения крупные, например новая цена или новый продукт, завышение будет меньше. Поэтому разброс стоит оценить по своей истории: по всем прошлым тестам, а не только по победителям, и с учётом разных размеров выборок. Формула в репозитории считает ошибку у всех тестов одинаковой.
Новизна, сезонность и взаимное влияние тестов не моделируются. На реальном проде они могут добавляться к разрыву, но не отменяют его. И наконец, снижение к среднему возвращает правильное среднее по потоку, но не скажет, какой именно победитель настоящий.
Что проверить у себя
Для этого не нужен ни стенд, ни numpy. Я вынес формулы в скрипт на стандартной библиотеке, он принимает размер группы, конверсию контроля и рост, в который вы верили до теста:
python3 retrodesign.py --users 50000 --base 0.05 --lift 0.02 --observed 0.06 --tau 0.01мощность 0.108минимальный значимый рост 5.40%завышение у победителя 3.38 разаоценка после снижения 0.70% (остаётся доля 0.116)Это и есть тест из начала статьи: при 50 000 пользователей на группу плюс 6% как раз дают p‑value около 0,03. Мощность при настоящих 2% равна 11%, а заявленные 6% при разбросе эффектов 1% дают оценку около 0,7%. Это оценка в рамках модели, а не доказанный эффект конкретного продукта.
Я бы предложил начать с четырёх шагов:
-
Посчитать минимальный значимый рост для своих типовых тестов. Если он больше эффектов, которые вы реально видели, значимый результат будет завышен всегда.
-
Не складывать проценты победителей. У тестов разные метрики и аудитории, эффекты взаимодействуют, поэтому сумма ничего не докажет. Прогнозы стоит сверять с накопленным результатом из шага 4.
-
Разделить решение и прогноз. В отчёте о тесте держать две строки: катим или нет и какую цифру берём в план.
-
Завести холдаут. Постоянная случайная группа без выкаченных изменений показывает накопленный эффект всего набора. Эффект каждого отдельного теста она не восстанавливает, зато проверяет, сходятся ли обещания программы экспериментов с результатом.
Вывод
Я бы перестал считать цифру из значимого теста измерением. Это измерение плюс надбавка за прохождение порога, и размер надбавки легко посчитать заранее.
При мощности 80% она заметно меньше, но не исчезает: в моей модели около 13%. При мощности 20% результат завышен вдвое с лишним, а в заданном мной потоке слабых тестов разрыв доходит до двадцати раз.
Значимость по‑прежнему полезна, чтобы отсеять шум, но для прогноза в деньгах нужна отдельная оценка.
Ссылка на мой репозиторий с экспериментом
Начать стоит с expected.txt: там все таблицы статьи и контроли стенда.
Формулы лежат в retrodesign.py, им хватает стандартной библиотеки, симуляция в simulate.py, а команда ./run.sh пересчитывает всё заново и сверяет с эталоном.
Источники:
-
Репозиторий с экспериментом
-
Biswas D., Abell A., Chacko R. Curvy Digital Marketing Designs: Virtual Elements with Rounded Shapes Enhance Online Click‑Through Rates, Journal of Consumer Research 51(3), 2024
-
Kohavi R., Linowski J., Vermeer L. et al. Power Analysis is Essential: High‑Powered Tests Suggest Minimal to No Effect of Rounded Shapes on Click‑Through Rates, Econ Journal Watch 23(1), 139–172, 2026
-
Kohavi R., Linowski J., Vermeer L. et al. Trustworthy A/B Patterns and the Winner’s Curse: Lessons from Eight Large‑Scale Replications, KDD 2026
-
Mudd R., Zaidi A., Friedberg R. et al. Breaking the Winner’s Curse with Bayesian Hybrid Shrinkage, arXiv, 2026
Когда A/B‑тест показывает рост, важно правильно интерпретировать результат, оценить его влияние на продукт и понять, какие решения действительно подтверждаются данными.
Чтобы увереннее работать с метриками, анализировать информацию и находить закономерности, приходите на бесплатные открытые уроки:
-
30 ноября, 20:00. «ИИ‑инструменты аналитика данных». Записаться
-
14 декабря, 19:00. «Анализ показателей бизнеса с помощью инструментов Битрикс24». Записаться
-
15 декабря, 20:00. «От выгрузки Excel до выводов за 60 минут: разведочный анализ с ИИ без кода». Записаться
Ещё больше возможностей узнать новое — в дайджесте открытых уроков OTUS.
Источник: habr.com