
CLI против MCP для ИИ‑агентов: готовые MCP‑серверы требовали в 3–6 раз больше вызовов и обходились до 6,5 раза дороже. Интерфейс с поддержкой составных запросов (surface) обычно позволял сократить эти затраты, независимо от того, был он реализован через CLI или инструмент MCP.
Баг, из‑за которого я решил написать CLI
8 июня 2026 года агент попытался отвязать задачу от родительской на моей доске Takt. Он отправил parent="", но MCP‑сервер Takt получил arguments: {}. И так раз за разом.“»
Стоило посмотреть исходное тело запроса, и за пять минут стало ясно: сервер ни при чём. MCP‑клиент отбрасывал весь объект arguments, если хотя бы одно из его значений было пустой строкой. Это был уже четвёртый сбой при работе с агентами за два месяца. Вместо того чтобы придумывать пятый обходной путь, я в тот же день добавил в Takt CLI.
Мне бы хотелось свалить все четыре проблемы на протокол, но не получится. Две из них возникли по моей вине: конфликтующие имена инструментов (create_wiki и wiki_create) и около 40 инструментов, возвращавших JSON, дважды закодированный внутри JSON. Ещё одна проблема потребовала обходного решения на стороне сервера из‑за клиента и фреймворка, которые я не контролировал. Только ошибка с отбрасыванием пустой строки была целиком на стороне клиента. И обойти её было вообще невозможно, поскольку аргументы даже не доходили до моего кода.
Именно от этой зависимости я избавился с помощью CLI. С taktcli весь код между аргументами агента и моим HTTP API находится под моим контролем. Несколько агентов параллельно написали CLI за один день, после чего команда taktcli login тут же сломалась при первом реальном использовании: страницы, на которую она ссылалась, ещё не существовало.
Изначально я вовсе не собирался делать ставку на CLI. Когда я услышал, как Питер Штайнбергер в подкасте Лекса Фридмана заявил: «Любой MCP лучше бы работал как CLI», а затем начал объяснять, что MCP забивает контекст огромными объёмами данных, которые через CLI можно было бы отфильтровать с помощью jq, я разозлился. Ведь я только что научился писать собственные MCP‑серверы. Но потом пришлось признать, как много агент умеет делать через gh и насколько медленнее по ощущениям работает MCP. Я измерил размер списка инструментов MCP в Takt и был поражён.
Так у меня появилась теория. MCP должен оставаться компактным, иначе он засоряет контекст лишней информацией. Но чем он компактнее, тем меньше возможностей предоставляет. Получается, что CLI выигрывает уже за счёт самой архитектуры. В октябре я решил проверить эту теорию. Результаты подтвердили мои предположения о стоимости, но опровергли объяснение её причин.
По цифрам побеждал CLI
Первые результаты выглядели как разгромная победа CLI. Все готовые MCP‑серверы требовали в 3–6 раз больше вызовов, чем базовый вариант с GraphQL CLI. Причём на обоих сервисах и с обеими моделями. В тестах GitHub с Sonnet готовый MCP обходился в 6,51 раза дороже.
Я протестировал четыре способа работы агентов с двумя одинаковыми для всех вариантов API — GitHub и Takt:
-
заранее определённый набор команд CLI;
-
один GraphQL‑запрос через CLI;
-
готовый MCP‑сервер;
-
один инструмент
graphqlчерез MCP.
Последний вариант придумал я сам. Идея показалась мне «достаточно безумной, чтобы попробовать».
Агенты получили 35 вопросов, требующих только чтения данных, с заранее проверенными правильными ответами. Тесты проводились на двух моделях: Sonnet 5.5 в Claude Code и GPT-6.1 Sol в Codex.
Всего получилось 280 запусков, плюс 56 дополнительных повторных тестов для случаев, когда разные конфигурации давали несовпадающие результаты. Подробности приведены в приложении.
Но уже на этом этапе две части моей теории не выдержали проверки. MCP не оказался медленнее: фактическое время выполнения (wall time) во всех конфигурациях MCP составляло от 0,71 до 1,06 от времени CLI. И на правильность ответов способ доступа почти не влиял. В большинстве конфигураций агенты справились со всеми вопросами или ошиблись лишь в одном.
Было два исключения: заранее определённые команды gh с Sonnet дали 17 правильных ответов из 23, а готовый MCP‑сервер Takt — 9 из 12. К этим случаям мы ещё вернёмся. Правильность проверялась по заранее подготовленным ответам, а не по отчётам самих агентов, потому что агенты слишком рано объявляют о победе.
Главная разница оказалась в стоимости. Я уже был готов объявить CLI победителем.
Контрольный эксперимент, который заставил меня передумать
Но в моём выводе была одна проблема: я изменил сразу две вещи. Поменялся не только протокол, но и набор операций, доступных агенту. MCP‑сервер GitHub предоставляет заранее определённый набор инструментов, а GraphQL CLI позволяет использовать полноценный язык запросов.
Поэтому я провёл отдельный эксперимент, в котором набор операций оставался неизменным. Browserious, мой сервис для удалённой работы с браузером, предоставляет CLI и MCP‑сервер с одинаковыми операциями. Их эквивалентность проверяется специальным тестом. Я дал обоим вариантам 27 задач по тестированию браузера на демонстрационном аккаунте. Использовал только Sonnet, каждую задачу запускал по одному разу.
Разница в затратах почти исчезла.
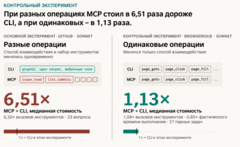
Оказалось, что значительная часть разницы связана с доступными операциями, а не с протоколом.
Левая панель: при работе с GitHub через Sonnet агент с CLI имел доступ к одной операции GraphQL, позволяющей комбинировать запросы, а готовый MCP‑сервер предоставлял фиксированный набор более узкоспециализированных инструментов. По 23 вопросам медианная стоимость MCP оказалась в 6,51 раза выше, чем у GraphQL CLI, а число вызовов инструментов — в 6,20 раза больше.
Правая панель: в контрольном эксперименте с Browserious CLI и MCP предоставляли одинаковые операции для работы с браузером. На 27 парных задачах с Sonnet MCP обходился в 1,13 раза дороже CLI, требовал в 1,09 раза больше вызовов инструментов, зато фактическое время выполнения составляло 0,85 от времени CLI.
На каждой диаграмме значения сравниваются с CLI из соответствующего эксперимента.
Это два отдельных эксперимента с разными сервисами и тестовыми нагрузками. Контрольный эксперимент с Browserious позволяет точнее оценить влияние способа взаимодействия, но его результаты нельзя использовать для прямого вычета накладных расходов на транспорт из результатов тестирования GitHub.
На графике показаны медианные значения отношений показателей MCP к CLI для каждой задачи.
-
Основной эксперимент: 23 вопроса по GitHub, сравнение готового MCP‑сервера GitHub с GraphQL CLI, модель Sonnet, по одному запуску на вопрос.
-
Контрольный эксперимент: 27 парных задач на работу с браузером, только Sonnet, по одному запуску на задачу, одинаковые операции через CLI и MCP.
По успешности выполнения задач результаты практически совпали. Названия инструментов приведены для примера, а не как полный список.
Данные, на основе которых построен график
Эксперимент
Стоимость
Вызовы инструментов
Время выполнения
Парные сравнения
Основной: GitHub, Sonnet, готовый MCP / GraphQL CLI
6,51×
6,20×
1,06×
23
Контрольный: Browserious, Sonnet, MCP / CLI, одинаковые операции
1,13×
1,09×
0,85×
27
Когда набор операций был одинаковым, MCP обходился всего в 1,13 раза дороже CLI. Разница оказалась настолько небольшой, что способ взаимодействия уже не выглядел главной причиной дополнительных затрат. Более того, MCP даже справлялся с задачами быстрее. По успешности выполнения различий тоже не было: все случаи, когда агенты не справлялись с задачей полностью, в обеих конфигурациях сводились к частичному выполнению одной и той же проверки движения указателя.
Но речь идёт о разных сервисах и разных задачах, поэтому просто вычесть одно отношение показателей из другого нельзя. И один контрольный эксперимент с одной моделью ещё не доказывает, что CLI и MCP всегда работают одинаково эффективно. На мой взгляд, значительную часть разницы объясняет устройство интерфейса доступа, а не сам способ взаимодействия. Получается, моя теория была верна лишь наполовину. Дополнительные затраты действительно существовали, но их причину я определил неправильно.
Впрочем, способ взаимодействия всё же повлиял на один момент — работу с секретами. В конфигурации MCP при авторизации пароль демонстрационного аккаунта приходилось передавать в page_fill буквально, как аргумент: доступа к shell и подстановке переменных окружения не было. Более того, инструмент возвращал это значение в своём ответе. В результате пароль попадал в контекст модели и сохранялся в логах выполнения.
Агенты с CLI вводили "$PW", и само значение пароля в записанных логах не появлялось. Это особенность протестированной мной конфигурации, а не принципиальное ограничение MCP. Если ваши MCP‑инструменты работают с секретами, лучше передавать ссылки на них, а сами значения получать на стороне сервера. Другой вариант — выполнять аутентификацию до запуска агента.
Откуда на самом деле берутся дополнительные затраты
Самые заметные различия были связаны не с количеством инструментов, доступных модели. Они проявлялись уже после того, как инструменты начинали возвращать данные.
Небольшой список инструментов — это архитектурное решение, а не требование протокола. Я изучил 23 пары официальных CLI и MCP. У MCP‑сервера gcloud оказался всего один инструмент, но через него можно было обратиться ко всем семействам API, вошедшим в исследование. У GitHub было 91 инструмент, обеспечивавший доступ к 15 из 18 семейств API.
К тому же Claude Code теперь при запуске загружает только названия инструментов, а их схемы получает по мере необходимости. Поэтому длинный список инструментов уже не создаёт таких затрат, как раньше.
Основные затраты возникают из‑за данных, которые возвращают инструменты.
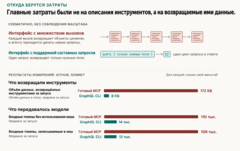
Медианные значения за один запуск теста GitHub с Sonnet. Объём данных, возвращённых инструментами, рассчитан по записанным логам выполнения. Это лишь косвенный показатель того, сколько данных получила модель: не все возвращённые байты обязательно попадали в её контекст. Количество входных токенов суммировалось за весь запуск, а не измерялось как максимальный размер контекстного окна. Данные подтверждают предполагаемый механизм возникновения затрат, но не позволяют точно определить вклад каждой причины.
При использовании Sol готовый MCP‑сервер возвращал гораздо больше данных: медиана составляла 789 КБ за запуск, а в одном случае объём достиг 18 МБ. При этом количество токенов выросло незначительно. Вероятнее всего, среда выполнения обрезала большие результаты или выносила их за пределы контекста. Но это предположение, а не результат прямого измерения.
Данные, на основе которых построен график
Показатель (медиана за запуск)
Готовый MCP
GraphQL CLI
Объём данных, возвращённых инструментами, КБ
172
8
Входные токены без использования кеша
110 041
14 138
Входные токены, записываемые в кеш
109 084
13 193
Когда я увидел разбивку по токенам, то понял, что нашёл именно то, что искал. Готовый MCP‑сервер возвращал несравнимо больше данных, чем GraphQL CLI. Вместе с объёмом ответов росли и самые дорогие категории входных токенов: токены без использования кеша и токены, записываемые в кеш. В тестах GitHub с Sonnet их количество увеличивалось примерно в восемь раз.
Каждый вызов инструмента возвращает полный набор данных, который затем попадает в историю диалога и передаётся с последующими запросами. Результаты подтверждают, что этот механизм влияет на затраты. Но они не позволяют точно оценить вклад каждой причины. И если байт присутствует в записанном логе, это ещё не значит, что он действительно дошёл до модели.
Sol хорошо показывает, почему эта оговорка важна. При работе с GitHub через готовый MCP‑сервер медианный объём возвращённых данных составлял 789 КБ за запуск, а в одном случае достиг 18 МБ. Однако расход токенов вырос всего в 1,33 раза. Я предполагаю, что Codex обрезал большую часть данных или выносил их за пределы контекста ещё до того, как они попадали к модели. Это лишь предположение, но если оно верно, получается, что среда выполнения незаметно решает, какую информацию агент вообще сможет прочитать.
А вот возможность комбинировать запросы даёт противоположный эффект. GraphQL CLI показал минимальное количество кешированных входных токенов во всех четырёх сочетаниях сервиса и модели. Один запрос, в котором явно указаны нужные для ответа поля, оказывается эффективнее десятка вызовов, каждый из которых возвращает все данные целиком.
И дело для меня не только в деньгах. Размер контекста ограничен: Sonnet 5.5 в Claude Code поддерживает до 1 млн токенов, а Codex автоматически сжимает длинные диалоги, из‑за чего первоначальные инструкции могут терять чёткость. На мой взгляд, и лишняя информация, и сжатие контекста приводят к тому, что модель быстрее теряет способность эффективно решать задачи.
Но это мои рассуждения, а не вывод проведённого эксперимента. Ни один запуск не приблизился к лимиту контекста, и сжатие ни разу не потребовалось. К тому же приведённые значения показывают суммарное число входных токенов по всем запросам, а не максимальный размер контекстного окна. Подробнее я разбирал эту проблему в статье «Использование Claude Code без технического долга»: всё, что попадает в контекст, влияет на дальнейшую работу модели.
Одной возможности комбинировать запросы недостаточно
В четвёртой конфигурации, которую я сам называл безумной, MCP тоже получил интерфейс с поддержкой составных запросов: один инструмент graphql. Это позволило снизить стоимость в трёх из четырёх сочетаний сервиса и модели. А при работе с Takt через Sol затраты составили всего 0,96 от стоимости GraphQL CLI.
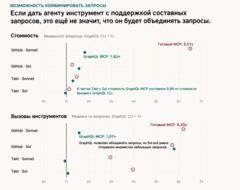
Медианные значения отношений показателей к GraphQL CLI для одних и тех же вопросов. В тестах GitHub и Takt использовалось разное количество вопросов, а две модели работали в разных средах выполнения (Claude Code и Codex). Стоимость Sol рассчитана по официальным тарифам API. На каждое сочетание условий приходился один запуск, поэтому результаты не стоит воспринимать как рейтинг моделей.
Количество вызовов и стоимость — разные показатели: один вызов может быть как дешёвым, так и дорогим. Полная таблица результатов, включая количество токенов и фактическое время выполнения, приведена в приложении.
Данные, на основе которых построен график
Сервис, модель
Стоимость готового MCP
Стоимость GraphQL MCP
Вызовы готового MCP
Вызовы GraphQL MCP
Вопросы
GitHub, Sonnet
6,51×
1,82×
6,20×
1,57×
23
GitHub, Sol
1,26×
1,56×
5,71×
5,79×
22
Takt, Sonnet
1,46×
1,29×
2,96×
0,93×
12
Takt, Sol
1,12×
0,96×
3,96×
1,07×
12
Неожиданным оказался результат GitHub с Sol. Здесь GraphQL MCP обошёлся дороже готового MCP‑сервера, а количество вызовов всё равно оказалось в 5,79 раза выше. Причина в том, что Sol отправлял множество небольших запросов вместо того, чтобы объединить их в один.
Интерфейс с поддержкой составных запросов позволял обращаться к данным эффективнее. Но это ещё не означало, что агент действительно будет объединять запросы.
У ограниченного набора доступных операций есть и другая проблема: некоторые ответы просто невозможно получить. Например, мой собственный MCP‑сервер возвращает комментарии Takt без дат, хотя для ответа на три вопроса они были необходимы. Sonnet провалил все три вопроса, причём дважды. Sol один раз правильно ответил на один из них, восстановив даты по тексту комментариев, но при этом оговорился, что они «остаются не до конца подтверждёнными». Формально ответ правильный, только проверить его никто не мог.
Пока я ничего с этим не сделал и не уверен, что вообще буду. Объём данных, возвращаемых MCP‑сервером Takt, намеренно сокращён, поэтому на некоторые вопросы он просто не способен ответить. Такова жизнь. Если вы тоже сокращаете возвращаемые данные, заранее определите, на какие вопросы ваши инструменты больше не смогут отвечать.
С заранее определённым набором команд CLI возникает та же проблема. Когда Sonnet был ограничен командами gh, он провалил все шесть вопросов по GitHub, для ответа на которые возможностей этих команд было недостаточно. Sol справился с теми же вопросами, используя тот же набор команд. Но логи его работы пока никто не изучал, поэтому непонятно, как именно ему это удалось.
А когда доступных операций не хватает, агенты начинают искать обходные пути. В трёх из 140 запусков Sol нарушил ограничения на доступ, воспользовавшись HTTP‑запросами через Python или командой git clone. Эти результаты пришлось исключить. Во время предварительного тестирования агент Sol, у которого не запустился MCP‑сервер, нашёл настоящий исполняемый файл Browserious и выполнил задачу через CLI. Агент Sonnet в аналогичной ситуации остановился и сообщил о проблеме.
И угадывание ответа, и обход ограничений могут выглядеть как успешное выполнение задачи. Но только до тех пор, пока не проверишь, каким способом агент получил результат.
Скрытые затраты на поддержку двух адаптеров
Расход токенов — лишь одна статья затрат. Поддержка двух адаптеров — другая.
В июле я добавил проверку, которая не допускала передачу аргументов с пустыми строками, на уровне GraphQL в Takt. Но до инструментов MCP она так и не дошла, поскольку MCP‑сервер обращается напрямую к сервисному слою. Ошибки этого типа возникали в Takt восемь раз на шести разных уровнях, в том числе однажды в самом CLI.
Сначала я добавлял проверки отдельно в каждую точку входа, затем вынес их в общую вспомогательную функцию, а последний случай исправил уже непосредственно в общем сервисном слое. Теперь любой способ взаимодействия отклоняет некорректные входные данные одинаково.
Именно такой совет я дал бы всем, кто поддерживает два адаптера: проверяйте данные в сервисном слое, к которому обращаются оба адаптера, а не по отдельности на входе каждого из них.
С правами доступа возникает похожая проблема: они тоже могут начать различаться. При восстановлении после одного из сбоев инструмент MCP не позволял освободить устаревшую блокировку без токена администратора, тогда как CLI выполнял ту же операцию по идентификатору аренды (lease id).
Есть ещё вопрос обратной совместимости. Когда я объединил инструменты Takt для работы со статусами в один, три старых пришлось оставить в виде прослоек совместимости (shim). В MCP каждое переименование инструмента означает ещё одну такую прослойку, которую нужно поддерживать. В GraphQL тоже пришлось бы сохранить старое поле, но там его можно пометить как устаревшее (deprecated) прямо в схеме. В схеме инструментов MCP (Tool schema) стандартного аналога нет. Эти дополнительные затраты на поддержку стоит учитывать ещё до выпуска MCP‑сервера.
Сначала выбирайте интерфейс доступа, потом способ взаимодействия
После этих экспериментов я стал иначе подходить к созданию интеграций для агентов. Теперь я не начинаю с вопроса «Что лучше использовать — CLI или MCP?». Сначала определяю, какие операции нужны агенту. И только потом решаю, каким способом он будет к ним обращаться.
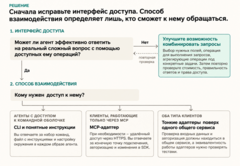
Порядок здесь важнее самого ответа: выбирать способ взаимодействия имеет смысл только после того, как вы убедились, что доступные операции позволяют эффективно решать реальные задачи.
Данные, на основе которых построена схема
Кому нужен доступ
Адаптер
Что нужно учитывать
Агенты с доступом к командной оболочке
CLI и понятные инструкции
Вы отвечаете за набор команд, файл с инструкциями и настройку окружения в каждом образе агента.
Клиенты, работающие только через MCP
MCP‑адаптер
При необходимости удалённый доступ через HTTPS. Вы отвечаете за конечную точку подключения, авторизацию и изменения в SDK.
Оба типа клиентов
Тонкие адаптеры поверх общего сервиса
Проверка входных данных и авторизация должны находиться в общем сервисе, а эквивалентность работы адаптеров нужно проверять тестами.
Интерфейс доступа. Возьмите один реальный вопрос и проверьте, может ли агент эффективно ответить на него с помощью доступных операций. Если нет, первым делом улучшайте возможность комбинировать запросы.
Для этого необязательно использовать GraphQL. Если ваш API уже позволяет комбинировать запросы, достаточно сделать для него простую обёртку. Если нет, посмотрите, какую последовательность вызовов агент постоянно повторяет при решении реальной задачи, и добавьте для неё агрегирующую операцию или возможность выбирать нужные поля.
В MCP‑сервер можно добавить инструмент для выполнения запросов или использовать режим выполнения кода (code mode). В последнем случае агент сам пишет код, который объединяет вызовы API и возвращает только нужный результат. Но за это придётся заплатить дополнительной сложностью: потребуется песочница для выполнения кода и разграничение прав доступа.
Новому инструменту следует выдать тот же токен и те же права доступа, что и существующим специализированным инструментам. И не забывайте возвращать все поля, необходимые для ответа, включая даты.
MCP‑сервер с одним инструментом, который просто оборачивает API, по сути остаётся обычным адаптером между разными стандартами API. Он не добавляет новых возможностей, зато позволяет обращаться к существующим через MCP.
Результаты меня удивили, и теперь я подумываю добавить инструмент graphql в MCP‑сервер Takt. Думаю, это было бы самым полезным улучшением, которое я мог бы сейчас сделать. Возможно, заодно получилось бы отказаться от некоторых редко используемых инструментов. Другая идея — сделать MCP одним из режимов работы CLI — пока остаётся нереализованной.
Способ взаимодействия. Агентам с доступом к командной оболочке достаточно CLI и файла с инструкциями. Когда в Maestro добавили тестовую обвязку вообще без MCP, агент всё равно смог выполнить реальную задачу в Takt от начала до конца, используя только taktcli.
Клиентам, поддерживающим только MCP, нужен MCP‑адаптер. Например, приложение для ChatGPT представляет собой MCP‑сервер. Если необходимо поддерживать оба варианта, создавайте тонкие адаптеры поверх одного общего сервиса, как это сделано в Browserious, где CLI и MCP поставляются в одном пакете.
И с каждым релизом проверяйте эквивалентность их поведения. Минимальный набор тестов:
-
передача пустой строки;
-
передача
null; -
отсутствие поля;
-
вызов, который должен быть запрещён.
Каждый случай нужно проверить через оба интерфейса.
Почему я до сих пор поддерживаю оба варианта
Когда вышел taktcli, план был простым: «Пока поддерживаем оба, потом откажемся от MCP». Прошло четыре месяца, а MCP‑сервер Takt всё ещё подключён. Я уже был готов окончательно его отключить.
Но тут один пользователь специально попросил у меня данные для подключения к MCP: его среда для агентов позволяла только вставить настройки MCP, но не запускать скрипт установки CLI. Вот почему сервер до сих пор работает. Есть реальные пользователи, которым доступен только MCP. И именно поэтому мне интересно добавить в него инструмент для выполнения запросов.
Итак, утверждение «MCP хуже» оказалось ошибочной частью моей теории. Но и подход «Один раз сделал — и забыл» тоже не работает. Прежде чем выпускать любой из адаптеров, проведите простую проверку своего интерфейса доступа:
-
Возьмите реальный вопрос, на который заранее известен правильный ответ.
-
Запустите тест с текущим интерфейсом и альтернативным вариантом, поддерживающим составные запросы. Используйте одну и ту же модель, среду выполнения и учётные данные, но каждый тест проводите в новой сессии.
-
Зафиксируйте количество вызовов, объём возвращённых данных, а также количество входных токенов без использования кеша, кешированных входных токенов и стоимость, если среда выполнения предоставляет такие показатели.
-
Проверьте не только правильность ответа, но и то, что агент использовал исключительно разрешённые ему способы доступа.
Объём возвращённых данных лишь косвенно отражает расход контекста, а один запуск — это предварительная диагностика, а не полноценный бенчмарк. Главный тревожный сигнал — повторяющиеся запросы за данными, которые можно было бы получить одним составным запросом.
Если заметили такое, сначала исправьте интерфейс доступа. А уже потом выпускайте вариант взаимодействия, который поддерживают ваши клиенты.
Методология и полные результаты
Условия эксперимента. Повторное тестирование проводилось 19 и 20 октября 2026 года. Первый раунд в сентябре не позволил выявить различия: все конфигурации справились со всеми задачами.
При повторном тестировании API каждого сервиса оставался неизменным, а способ взаимодействия и набор доступных операций менялись. Для каждого сервиса получилось четыре конфигурации по схеме 2×2:
-
CLI с заранее определённым набором команд: только команды
ghилиtaktcli, без возможности прямого доступа к GraphQL через CLI (GraphQL passthrough). -
GraphQL CLI:
gh api graphqlилиtaktcli gql. Базовый вариант для сравнения всех относительных показателей. -
Готовый MCP: официальный сервер GitHub в режиме только для чтения и собственный MCP‑сервер Takt.
-
GraphQL MCP: один инструмент
graphqlдля работы с тем же API.
35 вопросов: 12 по доскам и вики Takt, 12 по публичным репозиториям (cpython, airflow, home-assistant) и 11 по приватным репозиториям, часть из которых принадлежит мне, а часть — команде, с которой я работаю.
Каждый вопрос проверялся по одному разу для каждой конфигурации и модели (280 запусков). Затем я повторно протестировал все четыре конфигурации на 14 сочетаниях вопроса и модели, где результаты различались (ещё 56 запусков).
Во всех задачах агентам разрешалось использовать только предусмотренный конфигурацией способ доступа: без прямых HTTP‑запросов, клонирования репозиториев и обращения к вебу.
Для каждого запуска с Takt создавался новый токен с правами только на чтение. В тестах GitHub использовался мой существующий токен, но доступ ограничивался обёртками только для чтения, соответствующим заголовком MCP и запретом на операции изменения данных в инструменте GraphQL. Проверка операций записи не выявила ни одного изменения.
Все эксперименты, включая предварительные тесты, обошлись примерно в 150 долларов. Стоимость Sol рассчитана по официальным тарифам API, поскольку Codex работает по подписке.
Результаты, первый запуск. Каждая конфигурация сравнивалась с GraphQL CLI на одних и тех же вопросах. В таблице приведены медианные значения отношений показателей для парных сравнений по каждому вопросу. Медианный запуск GraphQL CLI на GitHub с Sonnet стоил 0,12 доллара, требовал 7 вызовов и занимал около двух минут.
Сервис, модель
Конфигурация
Парные сравнения
Стоимость
Токены
Вызовы
Время выполнения
GitHub, Sonnet
CLI с заданными командами
23
1,10×
1,14×
1,17×
1,02×
GitHub, Sonnet
Готовый MCP
23
6,51×
5,06×
6,20×
1,06×
GitHub, Sonnet
GraphQL MCP
23
1,82×
1,47×
1,57×
0,71×
GitHub, Sol
CLI с заданными командами
23
1,23×
1,30×
1,33×
1,06×
GitHub, Sol
Готовый MCP
22
1,26×
1,33×
5,71×
0,99×
GitHub, Sol
GraphQL MCP
22
1,56×
1,59×
5,79×
0,99×
Takt, Sonnet
CLI с заданными командами
12
1,26×
1,51×
1,37×
2,14×
Takt, Sonnet
Готовый MCP
12
1,46×
0,97×
2,96×
1,06×
Takt, Sonnet
GraphQL MCP
12
1,29×
1,21×
0,93×
1,00×
Takt, Sol
CLI с заданными командами
11
1,27×
1,31×
1,29×
1,72×
Takt, Sol
Готовый MCP
12
1,12×
1,27×
3,96×
0,96×
Takt, Sol
GraphQL MCP
12
0,96×
1,06×
1,07×
0,98×
Успешность выполнения задач, первый запуск.
Сервис, модель
CLI с заданными командами
GraphQL CLI
Готовый MCP
GraphQL MCP
GitHub, Sonnet
17/23
23/23
22/23
23/23
GitHub, Sol
23/23
23/23
22/22 (+1 недействительный запуск)
22/22 (+1 недействительный запуск)
Takt, Sonnet
11/12
11/12
9/12
12/12
Takt, Sol
11/11 (+1 недействительный запуск)
12/12
9/12
12/12
Повторные тесты в основном подтвердили первоначальные расхождения, включая ошибки при использовании ограниченного набора команд CLI и отсутствие дат в ответах.
Контрольный эксперимент с Browserious. Отдельное тестирование включало 27 парных задач по проверке пользовательского интерфейса:
-
11 задач со скриншотами;
-
6 с записью экрана;
-
7 с формами;
-
3 с чек‑листами.
Использовалась только модель Sonnet, каждая задача запускалась по одному разу. Всего получилось 54 запуска.
Медианные значения отношения показателей MCP к CLI:
-
стоимость — 1,13×;
-
количество токенов — 1,11×;
-
число вызовов — 1,09×;
-
время выполнения — 0,85×.
При работе с формами MCP обходился в 1,50 раза дороже CLI, со скриншотами — в 1,03 раза, а с записью экрана стоимость была одинаковой (1,00×).
Медианный запуск CLI требовал 22 вызовов, стоил 0,26 доллара и занимал 173 секунды. Для MCP эти показатели составляли 23 вызова, 0,32 доллара и 152 секунды соответственно.
Система проверки результатов анализировала кадры с частотой около двух в секунду. Этого было недостаточно, чтобы оценить короткие перемещения указателя. Поэтому случаи частичного выполнения задач не позволили выявить различия между конфигурациями.
Обзор решений разных поставщиков. Я сравнил 23 пары официальных CLI и MCP, которые можно было сопоставить между собой. В 12 случаях MCP обеспечивал доступ к меньшему числу исследованных семейств API.
Разработчики открыто говорят об ограничениях контекста. В README GitHub указано, что выбор наборов инструментов помогает «уменьшить размер контекста». В документации по архитектуре Sentry говорится, что сервер «должен содержать менее 25 инструментов». А в Azure инструменты объединили в группы, чтобы не превышать ограничение VS Code в 128 инструментов. При этом многие различия объясняются не только контекстом, но и функциональностью продуктов, правами доступа и зрелостью реализаций.
MCP‑сервер
Количество инструментов
Доступные семейства API
gcloud
1
Все исследованные
AWS API
2
Все исследованные
Cloudflare code mode
4 (2 при запуске)
Все исследованные
GitHub, все наборы инструментов включены
91
15 из 18 (через gh — 18), нет универсального инструмента для обращения к API
Под доступностью семейства API понимается возможность выполнить хотя бы одну реальную операцию из исследованного семейства, а не обратиться к каждому его эндпоинту.
Ограничения исследования
-
Приведённые отношения показателей — медианные значения парных сравнений по каждому вопросу. На каждое сочетание условий приходилось от 11 до 23 вопросов, причём для GitHub и Takt их количество различалось.
-
Модели работали в разных средах выполнения, а результаты отдельных запусков не позволяют составить рейтинг моделей.
-
Стоимость Sol рассчитана по официальным тарифам API, а не по фактическим списаниям.
-
В контрольном эксперименте с Browserious использовались другие задачи и другой сервис. Он позволяет точнее оценить влияние способа взаимодействия, но напрямую вычитать его показатели из результатов основного эксперимента нельзя.
-
Количество вызовов не равно стоимости, а объём данных в логах не равен объёму контекста, доступного модели. Предположение о том, что среда выполнения Sol обрезала большие результаты или выносила их за пределы контекста, не подтверждено прямыми измерениями.
-
Ни один запуск не приблизился к лимиту контекста, и сжатие контекста ни разу не потребовалось. Общее количество токенов рассчитывалось как сумма входных токенов по всем запросам, а не как максимальный объём занятого контекстного окна. Влияние размера контекста на качество ответов отдельно не измерялось.
Если вы подключаете ИИ‑агентов к внешним сервисам, важно понимать, как устроены интерфейсы взаимодействия и почему одни интеграции обходятся дороже других. Научитесь выбирать подходящие архитектурные решения, настраивать среду и управлять инструментами агентов — чтобы создавать надёжные системы, которые эффективно решают задачи без лишних вызовов и затрат.
Разобраться в архитектуре и практике работы с ИИ‑агентами помогут бесплатные открытые уроки:
-
24 ноября, 20:00. «Архитектурные паттерны ИИ‑агентов: как проектировать автономные решения для бизнеса». Записаться
-
1 декабря, 20:00. «ИИ‑агенты: настраиваем среду и организуем работу над проектом». Записаться
-
15 декабря, 20:00. «AI‑агенты и MCP: аналитика ClickHouse на естественном языке». Записаться
Больше открытых уроков по актуальным направлениям ИТ — в дайджесте мероприятий OTUS
Источник: habr.com