
Приложение читает каталог через GET, при промахе загружает данные из SQL и записывает их командой SET с TTL пять минут. На этом кэширование часто и заканчивается. Между тем одновременные промахи или изменение цены потребуют от приложения гораздо больше кода.
Дальше речь о cache-aside, где приложение само заполняет кэш. Числа условные, нагрузочные тесты здесь не проводились.
Цена большого ответа
Карточке товара нужны цена и остаток, а в Redis лежит весь каталог одним JSON на 2 МБ. Приложение каждый раз забирает эти мегабайты, чтобы вытащить два поля. Пятьсот таких чтений за секунду дают около 1 ГБ/с данных, ещё без расходов протоколов. Для SQL получилось облегчение, для сети и приложения добавилась работа.
Для hash стоит проверить команду чтения. С HGETALL по сети опять поедет всё содержимое; с HMGET только выбранные поля. Можно завести ключ на товар, обновляя каталог по частям. Тогда во время обновления читатель может собрать товары разных версий, и допустимость такого ответа зависит от задачи.
Начать диагностику можно с команд:
SLOWLOG GET 20
 INFO clients
 INFO commandstats
У SLOWLOG есть существенное ограничение: он измеряет выполнение команды, исключая сетевой обмен. Ожидание соединения из пула и разбор ответа измеряются в приложении. Поэтому пустой журнал совместим с медленной карточкой товара. Без клиентских замеров можно принять обработку JSON за задержки Redis.
Если клиент отправляет команды по одной, между ними придётся ждать ответы. Pipeline сокращает отдельные ожидания. Каталог всё равно передаётся целиком. С пачками тоже не стоит увлекаться. Redis хранит ещё не прочитанные клиентом ответы в памяти, поэтому ограничение считают и в командах, и в байтах результата. Для атомарного исполнения обычный pipeline не подходит.
Одно значение загружают несколько раз
Пока один обработчик загружает отсутствующее значение из SQL, другие тоже обнаруживают пустой ключ. Они ещё не знают, что результат уже загружается, и начинают ту же работу. До первой записи в Redis база получит несколько одинаковых чтений. Если SQL отвечает медленно, таких чтений успеет накопиться ещё больше.
После массовой выгрузки эти промежутки совпадут у множества ключей с одинаковым TTL. Вместо ровно пяти минут срок хранения можно случайно выбирать от четырёх до пяти, если это укладывается в требования к свежести:
import random
 ttl_seconds = random.randint(240, 300)
В давность результата входит и время его загрузки. Самому популярному ключу случайный TTL мало поможет: запросы всё равно придут за одним значением. Здесь приложение объединяет заполнение. Только один обработчик получает данные из источника, остальные ждут в пределах своего таймаута либо используют прежний результат, если он ещё не слишком старый.
Mutex в коде охватит только один процесс. Для нескольких экземпляров приложения нужна общая координация. Если используется блокировка Redis, у неё есть срок аренды и токен владельца, который атомарно проверяют при снятии. Аренда закончилась, но зависший обработчик от этого не остановился. Чтобы отклонить его позднюю запись, получатель должен проверить монотонный fencing token. Одной команды SETNX для этого недостаточно.
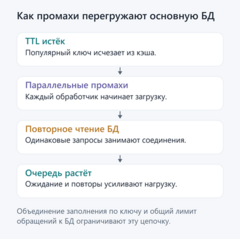
При недоступном Redis запросы пойдут за разными товарами. На такой случай база получает общий лимит загрузок: объединение по ключу ограничивает лишь повторную работу для одного товара. Число повторов и ожидание кэша также ограничивают, иначе весь срок ответа клиенту уйдёт на безуспешные попытки. Для проверки на стенде отключают доступ к Redis.
Если запросы пойдут в обход Redis, хватит ли базе ресурсов на них всех?
Кэш остался пустым
Нехватка памяти способна оставить кэш пустым при вполне рабочем Redis. SQL ответил, приложение попробовало сохранить результат, получило ошибку SET и проигнорировало её. Клиенту ответили успешно, а следующий запрос снова полезет в SQL. По HTTP-ошибкам такую неполадку не поймать. Нужен счётчик неудачных заполнений.
INFO memory
 INFO stats
 CONFIG GET maxmemory
 CONFIG GET maxmemory-policy
Если у всех ключей отсутствует TTL, volatile-политике будет не из чего выбирать. Она вытесняет только записи со сроком действия. Чтение по-прежнему работает, но команды, которым нужна дополнительная память, получают ошибку, как при noeviction. Для отдельного восстанавливаемого кэша можно сравнить allkeys-lru и allkeys-lfu. Сессии и прочие незаменимые данные требуют отдельного решения по хранению. Смена номера логической БД собственного лимита памяти не создаёт.
RSS процесса может быть больше maxmemory. Часть буферов репликации и AOF исключена из расчёта вытеснения; её размер виден в mem_not_counted_for_evict. При распределении RAM на хосте запас нужен и этим буферам, и соседним процессам. Причину исчезновения ключей проще искать по приращениям двух счётчиков за один интервал: evicted_keys показывает вытеснение, expired_keys истечение срока.
Удаление не спасло цену
В кэше опять старая цена, хотя после обновления базы ключ удалили. Это возможно, если А прочитал цену до обновления, Б записал новую в SQL и удалил ключ, а А задержался и выполнил свой SET последним. Получилось успешное сохранение уже устаревшего результата. Обновление БД перед удалением ключа не закрывает эту гонку.
С коротким TTL неверная цена исчезнет раньше, но гонка останется. Строгая актуальность требует согласовать обновление с заполнением. Это можно делать общей блокировкой либо проверкой версии, сохраняя маркер обновления. Если маркер лежит в удаляемом ключе, удаление уничтожит и версию для сравнения. При оформлении заказа приложение сверяет цену с источником истины.
Поиск ключей во время работы
На маленькой базе с KEYS * удобно искать записи. На большой та же команда надолго займёт сервер перебором ключей, задерживая прочие запросы. С SCAN получится разбить работу на вызовы. COUNT обозначает объём работы, а не число ключей: ответ может быть пустым или содержать повторы. Заканчивать обход надо по курсору 0.
У большой коллекции дорого стоит само освобождение памяти. Команда UNLINK удалит ключ и перенесёт эту работу из основного потока в асинхронное выполнение. RSS при этом может уменьшиться позже. Порции всё равно нужны: во время массовой чистки следует смотреть, что происходит с задержками остальных запросов.
На стенде нужны два прогона с прежними ключами, размерами ответов и частотой обновлений:
· Популярный ключ истекает во время нагрузки.
· Приложение теряет доступ к Redis.
В обоих случаях сравнивают p95/p99 и ошибки приложения, количество SQL-запросов, очередь соединений и память всего хоста. Если база перегружается, заполнение кэша и лимиты надо дорабатывать.
Источник: habr.com