
Я разработчик примерно на шести проектах одновременно, и созвонов у меня много. После каждого надо помнить, кто что обещал, и через неделю найти, где мы договорились про сроки. Облачными заметкерами я не пользовался: останавливали бот, который заходит в звонок отдельным участником, и звук чужих людей у кого-то на серверах.
Началось всё случайно: листал рилсы и наткнулся на ролик (ссылку не сохранил), где показывали большой промпт для Claude Code, инструкцию «собери локальную транскрибацию на Маке» на mlx-whisper и pyannote. Я отдал этот файл агенту со словами «хочу транскрибацию звонков по зуму/гугл миту». Через девять дней получилось приложение для macOS: оно пишет звонок двумя дорожками, расшифровывает и разбирает по голосам на самом Маке, а краткие итоги по желанию отдаёт внешнему ассистенту. Код открыт, порт на Windows лежит в отдельной ветке и почти готов.
Сразу о том, что уходит с компьютера, чтобы не было вопросов дальше. Запись, распознавание, эходав и разделение по голосам работают локально. Итоги пишет Claude Code, Codex или Cursor, если вы их подключили, и им уходит текст расшифровки; локальной LLM для итогов пока нет, без ассистента всё работает, просто без итогов. Есть ещё необязательный свой сервер в вашем аккаунте Cloudflare: если его подключить, туда уходит звук звонков, а голосовые отпечатки только если вы это включите, об этом ниже.
Дальше про то, обо что я спотыкался. Почти всё оказалось не там, где я ждал.
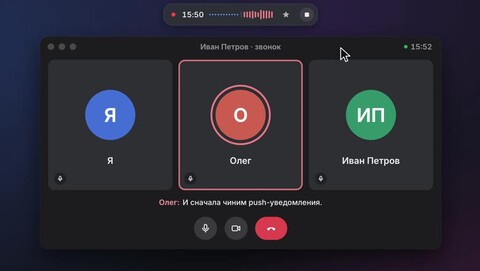
 Весь путь за 20 секунд: звонок, запись одной кнопкой, расшифровка, итоги и ответ ассистента по звонку (данные вымышленные)
Первый день: две дорожки вместо одной
Исходный промпт умел только расшифровывать готовые файлы, записи в нём не было. Первая версия с записью появилась через 14 минут после первого сообщения: иконка в строке меню и четыре пункта.
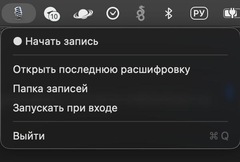 Первая версия, ещё под именем CallRecorder
Самое полезное решение того дня: писать не одну смесь, а две дорожки, микрофон отдельно и звук собеседников отдельно. «Я» и «они» разделены физически, и разбирать по голосам нужно только вторую дорожку. Это сняло половину будущих проблем с диаризацией.
На третий день друзья попросили «а можно все это как dmg сделать?», и скрипт стал приложением.
Запись звука на macOS
Начинал я со ScreenCaptureKit: он отдаёт системный звук без виртуальных драйверов вроде BlackHole. На второй день, на настоящем звонке, он с 4:40 стал отдавать цифровую тишину: звонок идёт, а в файле нули. Почему, я так и не выяснил до конца. Вместо этого в приложении появилось правило: если с дорожки собеседников две минуты идёт тишина, а звонок продолжается, приложение предупреждает и заново захватывает звук.
На четвёртый день я позвонил по FaceTime, и индикатор записи стоял на нуле, хотя собеседника я прекрасно слышал. Звук FaceTime играет не сам FaceTime, а системный процесс avconferenced, и захват ScreenCaptureKit, привязанный к приложению звонка, его не получает. Решение: Core Audio process tap (AudioHardwareCreateProcessTap, есть с macOS 14.2). Он стал основным путём, ScreenCaptureKit остался запасным. Встраивали прямо во время живого звонка: в 18:02 начали, в 18:05 обе дорожки писались.
Отдельно пришлось повозиться с TCC. Пока приложение было подписано ad-hoc, каждая пересборка сбрасывала разрешения: в Системных настройках галки стоят, а CGPreflightScreenCaptureAccess возвращает false, потому что разрешение привязано к подписи старой сборки. Помог постоянный сертификат, потом Developer ID. Разрешений в итоге три: микрофон, запись экрана и отдельно запись системного звука для tap. Первая нотаризация висела в «In Progress» около 29 часов, так бывает с новым аккаунтом разработчика, дальше минуты.
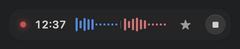 Капсула записи: моя дорожка синяя, собеседники коралловые
Эхо без наушников
Я часто созваниваюсь без наушников. Микрофон слышит и меня, и динамики, и в расшифровке собеседник говорит дважды: своей дорожкой и в моей. Поначалу я с этим мирился, пока, послушав запись, не написал агенту: «я там себя в эхо собеседников вообще слышу только».
Первая версия вычитала из микрофона дорожку собеседника классическим адаптивным фильтром. Лог писал, что убирается 6 дБ, а в плеере звук был роботизированный. Когда стали разбираться, выяснилось, что сдвиг между дорожкой собеседника и его эхом в микрофоне за один звонок менялся 69 раз, от -91 до +248 мс. Отрицательный сдвиг это не физика комнаты: микрофон и системный звук пишутся двумя потоками со своими буферами и часами, и их взаимное положение плавает. Мы же брали одно число на весь звонок (124 мс), фильтр почти всё время промахивался и на деле убирал 0,2 дБ. Вдобавок тихий встроенный микрофон поднимали на 30 дБ, и остаток эха становился громким, как оригинал.
Сейчас схема такая: сдвиг отслеживается по ходу звонка, после линейного фильтра стоит подавитель остатка, а нейросеть LocalVQE (1,3 млн параметров, 11 МБ) включается только на участках, где говорит собеседник. Уровень голоса собеседника в моей дорожке, пока говорит только он, упал с -26 до -71 dBFS, лишних слов в таких местах было 1676, стало 549. Мою речь, когда собеседник молчит, обработка не трогает.
Большую LocalVQE v1.3 (54 МБ) я сравнивал с лёгкой v1.2 и на слух, и по цифрам: остаток эха отличался на 1,2 дБ, а лёгкая работает в 40 раз быстрее реального времени против 26. Оставил лёгкую. WebRTC AEC3 проверял на шести реальных звонках: он в пять раз быстрее, но эха оставляет заметно больше, сейчас он записан в планы как облегчённый вариант. Шумодавы DeepFilterNet3 и GTCRN не подошли: они съедают голоса людей, которые сидят рядом со мной. Компромисс, который пришлось принять: тихий далёкий голос в комнате, пока говорит собеседник, приглушается. Сырые дорожки при этом не меняются никогда, обработка идёт в копиях.
«Почему я там 1000 раз говорю thank you»
Через три дня после первого релиза друг поставил приложение себе и прислал:
Расшифровал вроде) но почему я там примерно 1000 раз говорю thank you, притом что я молчал 99 процентов времени))
Защита от галлюцинаций Whisper была с первого дня: фильтр субтитровых фраз («Продолжение следует», «Спасибо за просмотр», «Редактор субтитров»), отсев зацикленного текста по степени сжатия, штатные no_speech_threshold и hallucination_silence_threshold. Не помогло.
Я воспроизвёл ситуацию: 10 минут самого тихого фона комнаты и 6 секунд речи в середине. Движок решил, что дорожка просто тихая, и поднял её на 30 дБ. После этого детектор речи по громкости нашёл «речь» в 406 секундах из 606, и Whisper написал на почти пустой дорожке 197 строк: «Да.», «Ну да.», «Ням-ням.». Ни одна не похожа на субтитровую фразу, поэтому фильтр их пропустил. Если язык английский или определяется автоматически, на таком фоне чаще всего выходит «Thank you.».
Помог Silero VAD как второе мнение после распознавания: строки, под которыми он не слышит голоса, отбрасываются. Перед распознаванием я его не ставлю, потому что резать звук до Whisper значит терять тихую далёкую речь и рвать модели контекст. На моём 75-минутном звонке «Thank you» и «Спасибо» на пустом месте было 41 строка, осталась 1. Цена: одна отброшенная строка, похоже, была настоящей далёкой фразой.
Попутно всплыло другое: при повторной расшифровке один и тот же звонок давал разный текст (на 10-минутном куске 106 сегментов и 461 слово против 90 и 487). Whisper, когда результат куска не проходит пороги, перерасшифровывает его с ненулевой температурой, то есть со случайной выборкой. Отключать этот механизм нельзя, без него модель зацикливается на «Спасибо. Спасибо. Спасибо». Я его оставил и зафиксировал seed, теперь текст совпадает до символа.
Кто это сказал
pyannote (speaker-diarization-3.1) обычно делит дорожку на голоса неплохо, но на одном рабочем созвоне собеседник у меня «задвоился», а двое других перепутались. Оказалось, модель поделила дорожку не по голосам, а по типу речи: в одну метку попали все короткие «угу» и «здорово», в другую все длинные реплики двух разных людей.
При этом косинусное сходство эмбеддингов (WeSpeaker ResNet34) с сохранёнными образцами голосов показывало правду: 0,6 против 0,3 в одной части звонка и 0,85 против 0,2 в другой. Теперь каждый кусок речи от 3 секунд дополнительно сверяется с сохранёнными голосами участников, и имя ставится, если сходство от 0,5 и отрыв от второго кандидата не меньше 0,15. На том звонке 38 из 43 длинных реплик получили правильное имя.
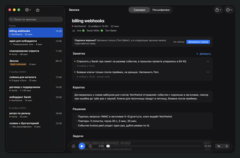 Окно звонков: расшифровка по говорящим и итоги (демо-данные)
Образцы копятся сами: назвал собеседника один раз, и дальше звонки проекта подписываются автоматически. Если голос незнакомый, имя по смыслу разговора пытается угадать ассистент («Маша, привет»), и такие имена выделены другим цветом, чтобы было видно, что это догадка.
 Переименовать говорящего один раз на всю расшифровку
Голосовые отпечатки собеседников это биометрические данные (в РФ 152-ФЗ, в ЕС GDPR). Они хранятся на Маке и удаляются по одному. Раньше их отправка на свой сервер была включена по умолчанию, и при подготовке этой статьи я решил, что так нельзя: в ближайшей версии она выключена, пока вы сами её не включите.
17 гигабайт
В тот же день я заметил, что «что-то питоновское жрёт 8 гигов». Замерили на длинном звонке: на 75 минутах процесс доходил до 17 ГБ на Маке, у которого их 16.
Самой крупной причиной оказался кэш MLX: освобождённые буферы он держит для повторного использования и по умолчанию не отдаёт. После Whisper на 75-минутной дорожке процесс держал 9,7 ГБ кэша рядом с моделью на 1,5 ГБ, и так до конца обработки. Лечится одной строкой и очисткой после каждой дорожки:
MLX_CACHE_LIMIT = 512 * 2**20 # небольшой кэш для цикла декодированияdef _transcribe(audio, **kw): mx.set_cache_limit(MLX_CACHE_LIMIT) mx.random.seed(SEED) # повторная расшифровка даёт тот же текст try: return mlx_whisper.transcribe(audio, **kw) finally: mx.clear_cache()Остальное мельче, но набиралось. Библиотека строит лог-мел-спектрограмму всей дорожки одним выражением, и в памяти одновременно живут все кадры, их спектры и полосы, примерно 12 объёмов самого звука, 3,5 ГБ на 75 минут; теперь спектрограмма считается поминутно. Whisper и pyannote не выгружались после своих этапов. Диаризация шла батчами по 32 окна и держала 4 ГБ. Эходав копировал опорную дорожку под каждый вариант сдвига.
Этап
Память было
Память стало
Время, мин
Подготовка и эходав
9,1 ГБ
4,0 ГБ
2,8
Распознавание микрофона
12,0 ГБ
3,6 ГБ
9,2
Распознавание собеседников
12,0 ГБ
3,7 ГБ
10,7
Разделение по голосам
17,0 ГБ
2,6 ГБ
11,0
Склейка и файл для плеера
16,0 ГБ
1,2 ГБ
2,6
Весь прогон, пик
17,0 ГБ
4,0 ГБ
36,2
Памяти стало в четыре раза меньше, прогон стал на 6% дольше (36 минут против 34), результат диаризации тот же до реплики. 36 минут на 75-минутный звонок звучит долго, но это две полные дорожки по 75 минут плюс диаризация, а обработка идёт в фоне с низким приоритетом, чтобы не мешать работать.
Какую модель брать для русского
Один и тот же 75-минутный звонок, M1 Pro с 16 ГБ, весь прогон с двумя дорожками:
Модель
Размер
Пик памяти
Время
Whisper Turbo (MLX)
1,6 ГБ
4,0 ГБ
36 мин
Whisper Large v3 (MLX)
3,1 ГБ
4,9 ГБ
68 мин
Whisper Small (MLX)
0,5 ГБ
4,0 ГБ
23 мин
GigaAM v3 (ONNX, int8, CPU)
0,2 ГБ
3,2 ГБ
20 мин
Parakeet v3 (ONNX, int8, CPU)
0,7 ГБ
4,5 ГБ
23 мин
Пик памяти почти одинаковый, потому что его задаёт не распознавание, а эходав и диаризация.
Метрику WER на своих звонках я не считал, размеченного набора у меня нет. Был менее академичный тест: я разметил 55 матерных слов в двух русских подкастах и посмотрел, кто сколько найдёт. GigaAM v3 нашёл 53, Parakeet 48, Whisper Turbo 43, Whisper Large v3 42, Nemotron 3.5 ASR 0.6B от NVIDIA 41. Whisper вдобавок сам цензурит мат («пи***ц»), и подсказка «без цензуры» не помогает. Тест шуточный, но тихую неформальную речь он проверяет неплохо.
На моих звонках GigaAM v3 точнее остальных в именах и живой речи и при этом самый маленький. Его минус: он не берёт словарь проекта как подсказку, поэтому по умолчанию стоит Whisper Turbo. Large v3 вдвое медленнее Turbo, а разницы в качестве на своих записях я не заметил.
Как это писалось
Я фулстек-разработчик с 15-летним стажем, но код этого проекта почти целиком написал Claude Code. Моя часть: решать, что делать и чего не делать, гонять всё на своих живых звонках и проверять результат. Метрики помогали найти проблему, а финальный выбор, как с эходавом, я делал на слух. Этот текст я тоже собирал вместе с Claude по логам сессий, цифры взяты оттуда, правил и проверял сам. Публичная история репозитория короче девяти дней: первые дни код жил в черновой ветке, перед первым релизом я её сжал.
Код под MIT. Тесты движка, приложения и сервера, UI-прогон по всем контролам на демо-данных и проверки Gitleaks, Semgrep и CodeQL идут в CI, сборки подписаны и нотаризованы. Лицензии моделей разрешают такое использование: Whisper, pyannote, GigaAM и Silero VAD под MIT, Parakeet и эмбеддинги WeSpeaker под CC BY 4.0, LocalVQE под Apache 2.0.
А почему не взять готовое
Готовое я, конечно, смотрел. Облачные сервисы вроде Otter и Fireflies часто заходят в звонок ботом, а звук уходит к ним. Granola и Jamie обходятся без бота, но расшифровка всё равно облачная. MacWhisper локальный, но он про файлы и диктовку, а не про историю звонков с голосами и проектами. Открытые Meetily, Hyprnote и Minutes по-настоящему локальные, и идеи у них хорошие, но мне хотелось маленькую капсулу записи, которая не мешает во время звонка, и нормальный звук без наушников. Так что это не «лучше всех», а то, что удобно мне.
Чего пока нет
-
Нужен Mac на Apple Silicon и macOS 15 или новее.
-
Разделение по голосам ошибается, когда люди говорят друг поверх друга.
-
Нет локальной LLM для итогов.
-
Нет WER на размеченном наборе, выбор модели основан на моих звонках.
-
Нет релиза для Windows: порт (faster-whisper на CUDA, запись через WASAPI, интерфейс на WinUI 3) лежит в отдельной ветке и почти готов, про него будет отдельная статья.
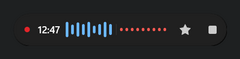 Windows-версия: капсула записи
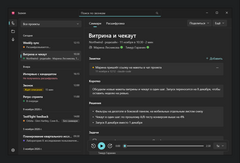 Windows-версия: окно звонков на WinUI 3 (демо-данные)
Законы о записи разговоров в разных странах разные. Я предупреждаю собеседников и советую делать так же. Автоматический старт записи в приложении есть, но по умолчанию выключен, а на капсуле записи есть напоминание о согласии.
Репозиторий: github.com/Able1991/sozvon. Особенно полезны баг-репорты про необычные конфигурации звука.
Источник: habr.com