
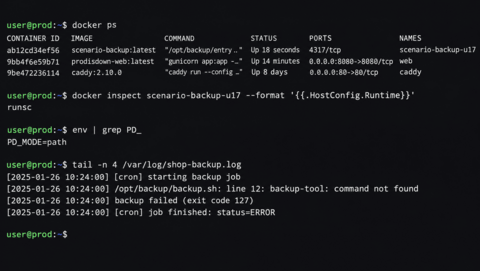
В моем проекте реализованы кейсы с неисправностями системы. Сами неисправности довольно привычные: не запускается приложение, не работает резервное копирование, заканчиваются файловые дескрипторы, Nginx отдаёт ошибку.
Сложность оказалась не в том, чтобы сломать сервис. Нужно сделать так, чтобы каждый новый запуск начинался с предсказуемого состояния, независимо от того, что делал предыдущий пользователь.
При этом не хотелось сводить прохождение к запоминанию одной команды. Например, если резервная копия не создаётся, причина не обязана каждый раз быть одинаковой.
Расскажу, как сейчас устроена подготовка таких окружений, на примере сценария с cron.
Вместо снимка системы — скрипт подготовки
В проекте используются Docker и gVisor. Для каждого сценария есть свой образ, из которого создаётся отдельный контейнер.
Но я не сохраняю готовый снимок машины после того, как намеренно что-то в ней сломал. Вместо этого неисправность формируется при запуске нового контейнера.
Сценарий описывается в manifest.yaml. В нём в том числе перечисляются варианты поломки.
При подготовке запуска Python выбирает один из них:
def pick_variant(scenario_info): variants = scenario_info["variants"] return random.choice(variants)["id"] if variants else NoneЗатем параметры варианта передаются контейнеру через переменные окружения с префиксом PD_:
def variant_environment(scenario_info, variant_id): return { f"PD_{key.upper()}": value for key, value in variant_vars(scenario_info, variant_id).items() }После этого управление получает сценарный entrypoint.sh или init.py, который подготавливает нужное состояние файлов, конфигураций и сервисов.
По сути, у меня есть не набор заранее сломанных серверов, а набор инструкций, которые воспроизводят поломку.
И здесь важно различать две вещи. Я не стремлюсь получить побайтово одинаковую систему при каждом запуске. PID, временные метки, случайные значения и даже конкретная причина неисправности могут отличаться.
Повторяться должна сама диагностическая задача.
Пример с резервным копированием
Допустим, пользователь получает инцидент: ночной бэкап перестал создаваться.
В сценарии предусмотрены три причины:
-
Скрипт не находит исполняемый файл из-за
PATH. -
Скрипт зависит от текущего рабочего каталога.
-
Для выполнения операции не хватает прав.
В init.py это определяется выбранным режимом:
mode = os.environ.get('PD_MODE', 'path')assert mode in ('path', 'cwd', 'permissions')Для первого варианта инициализация заменяет абсолютный путь к программе на короткое имя:
if mode == 'path': script.write_text( script.read_text().replace( '/opt/backup/bin/backup-tool', 'backup-tool' ) )Для второго — заменяет абсолютный путь к конфигурации на относительный:
if mode == 'cwd': script.write_text( script.read_text().replace( '/opt/backup/config/backup.conf', 'config/backup.conf' ) )В обоих случаях результат для пользователя один: резервное копирование не сработало.
Но разбираться приходится в разных причинах.
Одного изменения файла недостаточно. Мне нужно, чтобы к моменту подключения пользователь уже увидел последствия неисправности.
Поэтому при подготовке сценария выполняется команда, имитирующая запуск задания в ограниченном окружении:
sudo -u backup /usr/bin/env -i HOME=/home/backup LOGNAME=backup USER=backup SHELL=/bin/bash PATH=/usr/bin:/bin /bin/bash -c 'cd /home/backup; /opt/backup/backup.sh >> /var/log/shop-backup.log 2>&1' || trueЗдесь несколько деталей.
env -i позволяет запустить скрипт без наследования обычного окружения процесса. Мы явно задаём PATH и другие нужные переменные.
Вывод записывается в журнал. Пользователь сможет начать диагностику с него, как это обычно происходит при разборе подобных проблем.
А || true не даёт неудачному запуску самого бэкапа прервать подготовку учебного окружения.
Это намеренное поведение: ошибка резервного копирования должна существовать, но контейнер при этом должен продолжить работать.
Перед открытием пользовательского терминала служебные переменные PD_* убираются из окружения оболочки, чтобы выбранный вариант нельзя было просто прочитать обычной командой env.
Разумеется, это не защита секрета от пользователя с root-доступом. Смысл лишь в том, чтобы не оставлять готовый ответ среди переменных окружения.
Когда считать сломанный сервер готовым?
С обычным приложением всё относительно понятно: запустили контейнер, проверили, отвечает ли сервис.
С учебным стендом ситуация интереснее.
Если я специально подготовил сценарий, в котором веб-сервис не работает, то обычная проверка его исправности не годится. Иначе корректно подготовленная неисправность будет считаться ошибкой запуска.
Сейчас основным сигналом готовности в проекте служит доступность веб-терминала ttyd.
Он запускается после выполнения сценарной подготовки. Система проверяет подключение к терминалу и дополнительно учитывает время прогрева, предусмотренное для конкретного задания.
Но здесь у текущей реализации есть недостаток.
Доступность терминала ещё не доказывает, что нужная неисправность действительно появилась. Кроме того, при таймауте проверки терминала система может продолжить подготовку пользовательской сессии, записав предупреждение.
Получается, что у меня пока недостаточно строго разделены две проверки:
Готовность окружения — можно ли подключиться и выполнять команды.
Готовность инцидента — действительно ли сервис находится в нужном неисправном состоянии.
В идеале у каждого сценария должна быть отдельная проверка начальной поломки, которая выполняется до того, как пользователь начнёт расследование.
Например, для случая с бэкапом нужно не просто убедиться, что терминал доступен, а проверить признаки ожидаемого неудачного выполнения задания.
Это одна из вещей, которые я ещё хочу доработать.
Пользователь нажал «Сбросить», пока контейнер запускался
Ещё один случай обнаруживается уже не внутри Linux, а в логике самого приложения.
Подготовка контейнера занимает некоторое время. Пользователь может запросить запуск, а затем сбросить сценарий до окончания подготовки.
Что делать с контейнером, который появится после сброса?
Если без дополнительных проверок привязать его к пользовательской сессии, получится некорректное состояние. Пользователь уже отказался от запуска, а система завершила подготовку и пытается выдать ему старое окружение.
Поэтому создание контейнера и его привязка к запуску — отдельные операции.
После подготовки код проверяет, удалось ли присоединить контейнер к актуальной записи:
if not attached: log.info( "Run %s was reset while starting; removing its container", run_id ) containers.stop_container(info["container_id"]) returnЕсли за время подготовки запуск был сброшен, контейнер удаляется.
Есть и защита от одновременных запросов одного пользователя на запуск одного сценария. Если актуальный запуск уже существует, система возвращает его, вместо того чтобы создавать ещё один.
Сами контейнеры тоже не могут жить бесконечно. Фоновая очистка удаляет окружения по таймаутам, а максимальное время жизни стенда ограничено одним часом.
Для меня это оказалось не менее важной частью тренажёра, чем подготовка неисправностей.
Создать контейнер относительно просто. Гораздо важнее не оставлять его работать после того, как он перестал быть нужен.
Что ещё стоит улучшить
Сейчас вся система рассчитана на довольно небольшой VPS: 3 vCPU и около 6 ГБ RAM.
Игровые контейнеры запускаются через runsc и имеют ограничения по памяти, CPU и количеству процессов. Для некоторых сценариев лимиты отличаются. Например, инцидент с высокой загрузкой CPU после подготовки получает более жёсткую процессорную квоту.
Но по мере добавления новых сценариев появились вопросы, которые ещё предстоит решить.
Во-первых, инициализация неисправности пока зависит от корректности конкретного entrypoint или init.py. Мне нужен более строгий способ проверять, что подготовка каждого варианта закончилась ожидаемым результатом.
Во-вторых, фоновые запуски сейчас выполняются внутри процесса веб-приложения. Для небольшой нагрузки это работает, но при перезапусках и росте числа одновременных запросов отдельный обработчик задач был бы надёжнее.
В-третьих, используются изменяемые теги Docker-образов. Для точного воспроизведения определённой версии стенда лучше фиксировать конкретные версии образов.
Это не проблемы, которые уже решены. Скорее список вещей, до которых я дошёл по мере развития проекта.
В итоге
Когда я начинал делать Linux-тренажёр, больше всего думал о самих заданиях: что сломать, какие логи оставить, насколько сложной сделать диагностику.
Теперь значительная часть работы связана с тем, что происходит до появления терминала и после его закрытия.
Нужно правильно выбрать вариант, подготовить неисправность, не перепутать готовность контейнера с состоянием сервиса, обработать повторные запросы и убрать окружение после завершения.
Самым удобным решением для меня стала программная подготовка поломок вместо хранения готовых снимков системы.
Она позволяет использовать один сценарий для нескольких вариантов неисправности и не зависеть от изменений, сделанных предыдущим пользователем.
Источник: habr.com