
Интересно наблюдать за тем, как порой разные подходы и парадигмы обмениваются своими лучшими качествами в процессе развития. Одно из таких событий в области хранения и обработки данных — противостояние и сближение DWH и Data Lake.
DWH появился раньше Data Lake. С ростом объёмов данных потребовалась новая парадигма — так появилось озеро данных. Классический DWH при этом никуда не исчез, просто занял свою нишу.
Сравнение: озеро данных vs хранилище данных
Характеристика
Data Lake
Data Warehouse
Тип данных
Любые форматы
Структурированные, очищенные
Схема
Schema-on-Read
Schema-on-Write
Масштабирование
Горизонтальное
Вертикальное
Обработка
ELT
ETL
Аналитика
Исследования, ML
BI-отчёты
Управление
Требует дисциплины; с Iceberg — ACID
Встроенное
Как видим, у каждого подхода свои сильные стороны. Data Lake выигрывает в гибкости и стоимости хранения, но требует дисциплины — без неё озеро быстро превращается в набор плохо управляемых файлов. Data Warehouse даёт порядок и предсказуемость, но плохо подходит для сырых и полуструктурированных данных.
Apache Iceberg пытается сократить этот разрыв: он добавляет к озеру данных ACID-транзакции, схемы и каталог — то, за что раньше приходилось идти в DWH. Об этом дальше.
Что же такое Apache Iceberg
Apache Iceberg — это табличный формат нового поколения для Data Lake. Работает поверх Parquet / ORC / Avro в S3 или HDFS и превращает набор файлов в управляемую, транзакционную таблицу.
-
ACID — атомарные коммиты, устойчивые к падениям.
-
Time Travel — чтение любой прошлой версии таблицы.
-
Скрытые партиции — Iceberg сам применяет трансформы к фильтрам.
-
Оптимистичная конкурентность — параллельные писатели не ломают таблицу.
Три слоя архитектуры Iceberg
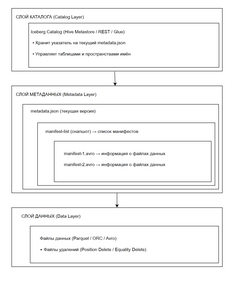 Структура файла Iceberg
Iceberg разделяет данные и метаданные. Благодаря этому мы можем менять структуру и откатываться к прошлым версиям.
Catalog Layer — это точка входа, через которую движки (Spark, Trino, Flink) обращаются к таблице. Каталог хранит указатель на текущий metadata.json и управляет пространствами имён и таблицами.
Metadata Layer — это дерево, состоящее из нескольких уровней.
Компонент
За что отвечает
metadata.json
Это главный файл таблицы. В нём — схема таблицы, список партиций, настройки и ссылка на текущий слепок (снапшот) и прочая информация.
manifest-list (снапшот)
Это состояние таблицы на конкретный момент времени. В нём перечислены все manifest-файлы, которые относятся к текущей версии.
manifest-файлы (.avro)
Каждый манифест содержит список физических файлов с данными и их статистику (сколько записей, мин/макс значения, размер).
Data Layer
На нижнем уровне — обычные Parquet / ORC / Avro. Помимо data-файлов в Merge-on-Read (MOR) используются delete-файлы:
-
Position Delete — удаление по позиции строки в конкретном файле.
-
Equality Delete — удаление по значению ключа.
В Copy-on-Write (COW) delete-файлов нет: Iceberg перезаписывает затронутые data-файлы целиком. В нашем эксперименте с UPDATE использовался именно COW — поэтому в снапшоте v2 мы увидим total-delete-files: 0.
Format v3: deletion vectors
Format v3 вместо отдельных файлов с пометками об удалении использует компактные битовые карты, которые хранятся в отдельных Puffin-файлах в хранилище. Это уменьшает объём служебных данных при частых обновлениях, ускоряет потоковую загрузку и упрощает удаление отдельных строк по запросу.
Поднимаем Iceberg локально
Чтобы посмотреть, как Iceberg работает на практике, поднимем локальный стенд: Spark + REST-каталог + MinIO. Воспользуемся docker-compose.yml:
docker-compose.yml
services: spark-iceberg: image: tabulario/spark-iceberg container_name: spark-iceberg build: spark/ networks: iceberg_net: depends_on: - rest - minio volumes: - ./warehouse:/home/iceberg/warehouse - ./notebooks:/home/iceberg/notebooks/notebooks environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 ports: - 8888:8888 - 8080:8080 - 10000:10000 - 10001:10001 rest: image: apache/iceberg-rest-fixture container_name: iceberg-rest networks: iceberg_net: ports: - 8181:8181 environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 - CATALOG_WAREHOUSE=s3://warehouse/ - CATALOG_IO__IMPL=org.apache.iceberg.aws.s3.S3FileIO - CATALOG_S3_ENDPOINT=http://minio:9000 - CATALOG_S3_PATH_STYLE_ACCESS=true minio: image: minio/minio container_name: minio environment: - MINIO_ROOT_USER=admin - MINIO_ROOT_PASSWORD=password - MINIO_DOMAIN=minio networks: iceberg_net: aliases: - warehouse.minio ports: - 9001:9001 - 9000:9000 volumes: - ./minio_data:/data command: ["server", "/data", "--console-address", ":9001"] mc: depends_on: - minio image: minio/mc container_name: mc networks: iceberg_net: environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 entrypoint: | /bin/sh -c " until (/usr/bin/mc alias set minio http://minio:9000 admin password) do echo '...waiting...' && sleep 1; done; # Проверяем, существует ли бакет warehouse, и создаём только если его нет if ! /usr/bin/mc ls minio/warehouse > /dev/null 2>&1; then echo 'Creating bucket warehouse...'; /usr/bin/mc mb minio/warehouse; /usr/bin/mc policy set public minio/warehouse; else echo 'Bucket warehouse already exists, skipping creation.'; fi; tail -f /dev/null "networks: iceberg_net:docker-compose up -ddocker-compose psПосле выполнения команды
docker-compose up -dнеобходимые нам ресурсы будут доступны по следующим адресам:Jupyter Notebook — http://localhost:8888
Minio Console — http://localhost:9001 (логин: admin, пароль: password)
В итоге локально подняты сервисы:
— spark‑iceberg — Jupyter Notebook (PySpark) + Spark UI,
— rest — REST‑каталог Iceberg,
— minio — S3-совместимое хранилище,
— mc — автоматическое создание бакета warehouse.
Теперь создадим неймспейс и таблицу через Jupyter Notebook — http://localhost:8888:
from pyspark.sql import SparkSessionfrom pyspark.sql.types import StructType, StructField, IntegerType, StringType, DoubleTypespark = SparkSession.builder .appName("Iceberg") .getOrCreate()# Создаём неймспейсspark.sql("CREATE NAMESPACE IF NOT EXISTS iceberg_db")# Создаём таблицуspark.sql(""" CREATE TABLE iceberg_db.orders ( id BIGINT, user_id BIGINT, amount DECIMAL(10,2), status STRING, created_at TIMESTAMP ) USING iceberg""")# Загружаем начальные данныеspark.sql(""" INSERT INTO iceberg_db.orders VALUES (1, 101, 150.00, 'NEW', CAST('2026-09-01 10:00:00' AS TIMESTAMP)), (2, 102, 250.00, 'NEW', CAST('2026-09-01 11:00:00' AS TIMESTAMP)), (3, 103, 350.00, 'PROCESSED', CAST('2026-09-02 12:00:00' AS TIMESTAMP))""")# Проверяемspark.sql("SELECT * FROM iceberg_db.orders ORDER BY id").show()После выполнения команд CREATE TABLE и INSERT в MinIO автоматически создалась следующая структура:
-
Бакет
warehouse— корневая директория, где Iceberg хранит все данные. -
Внутри бакета появилась папка
iceberg_db— это наш namespace. -
Внутри неё папка
orders— наша таблица.
 Minio — iceberg_db / orders
Папка iceberg_db / orders / — это наша таблица orders. Iceberg создал внутри две служебные папки: data и metadata.
data — физические файлы с данными в формате Parquet (именно наши записи).
 Minio — iceberg_db / orders / data
metadata — метаданные таблицы: схема, снапшоты, файлы манифестов — всё, что позволяет Iceberg управлять данными и делать, например, Time Travel.
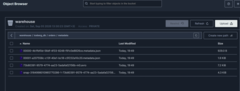 Minio — iceberg_db / orders / metadata
Файл
Что это
Описание
00000-…metadata.json
Версия 0
Создан при CREATE TABLE. Хранит схему, но данных ещё нет.
00001-…metadata.json
Версия 1
Создан при INSERT. Теперь таблица знает, где лежат данные.
73b80391-…-m0.avro
Manifest-файл
Карта данных. Содержит список Parquet-файлов, их размер, количество записей и статистику (мин/макс).
snap-318499…-…avro
Snapshot
Слепок таблицы на момент времени.
Теперь попробуем сделать update записи:
# Обновляем статус заказа с id=1spark.sql(""" UPDATE iceberg_db.orders SET status = 'PROCESSED' WHERE id = 1""")# Проверяем результатspark.sql("SELECT * FROM iceberg_db.orders ORDER BY id").show()По умолчанию Iceberg выполняет
UPDATEв режиме Copy-on-Write (COW): старый data-файл не редактируется, а полностью перезаписывается новым. Новый снапшот при этом создаётся в любом случае — он фиксирует результат коммита. Разница в том, что попадает в снапшот: в COW — новый data-файл вместо старого, в MOR — delete-файл(ы) и новый data-файл с обновлёнными строками.
После UPDATE в MinIO появились новые файлы, а старые остались нетронутыми:
-
добавился новый
metadata.json(версия 2) — теперь таблица знает об изменении; -
появились два новых манифеста (
-m0.avroи-m1.avro): один описывает новый data-файл с обновлёнными данными, второй — DATA-манифест, в котором старый data-файл помечен как удалённый из текущего снапшота. -
создан новый снапшот (
snap-182508…) — слепок таблицы после UPDATE, позволяющий вернуться к предыдущему состоянию.
Главное: старые файлы (00001-…, snap-318499…) остались на месте — именно это даёт Iceberg возможность делать Time Travel и откатиться к любой версии данных.
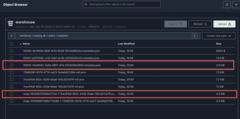 Состояние metadata после UPDATEБыло (после INSERT-ов) 4 файла:
Файл
Версия
00000-…metadata.json
v0 (CREATE TABLE)
00001-…metadata.json
v1 (INSERT 3 записи)
73b80391-…-m0.avro
Манифест v1
snap-318499…-…avro
Снапшот v1
Стало (после UPDATE) 8 файлов:
Файл
Что это
Комментарий
00000-…metadata.json
v0 (CREATE TABLE)
Остался без изменений
00001-…metadata.json
v1 (INSERT 3 записи)
Остался без изменений
00002-42af404c-…metadata.json
v2 (UPDATE)
Новый. Версия таблицы после UPDATE
73b80391-…-m0.avro
Манифест v1
Остался от первого INSERT
7cec91b6-…-m0.avro
Манифест v2
Новый. Карта данных после UPDATE
7cec91b6-…-m1.avro
Манифест v2 (второй)
Новый. Ещё один манифест
snap-182508…-…avro
Снапшот v2
Новый. Слепок после UPDATE
snap-318499…-…avro
Снапшот v1
Остался от первого INSERT
При каждом изменении Iceberg создаёт новый metadata.json вместо перезаписи старого, в нашем случае на каждый шаг:
Шаг 1 — создание таблицы (нет данных).
Шаг 2 — первый INSERT (3 записи).
Шаг 3— UPDATE (изменена запись id = 1).
В классическом Data Lake (например, Hive + Parquet) UPDATE — это нетривиальная операция. Чаще всего она требует полной перезаписи части или даже всей таблицы, потому что файлы физически перезаписываются. История изменений при этом теряется, если вы заранее не настроили специальные механизмы.
Iceberg же не перезаписывает файлы, а создаёт новые и хранит старые версии как снапшоты. Это делает откат изменений встроенной возможностью, а не дополнительным костылем.
Рассмотрим последний metadata.json v2 (00002-42af404c-…):
metadata.json v2
{ "format-version": 2, "table-uuid": "979adc0a-2eb0-439a-9060-47b779fb16b5", "location": "s3://warehouse/iceberg_db/orders", "last-sequence-number": 2, "last-updated-ms": 1788714006961, "last-column-id": 5, "current-schema-id": 0, "schemas": [ { "type": "struct", "schema-id": 0, "fields": [ { "id": 1, "name": "id", "required": false, "type": "long" }, { "id": 2, "name": "user_id", "required": false, "type": "long" }, { "id": 3, "name": "amount", "required": false, "type": "decimal(10, 2)" }, { "id": 4, "name": "status", "required": false, "type": "string" }, { "id": 5, "name": "created_at", "required": false, "type": "timestamptz" } ] } ], "default-spec-id": 0, "partition-specs": [ { "spec-id": 0, "fields": [] } ], "last-partition-id": 999, "default-sort-order-id": 0, "sort-orders": [ { "order-id": 0, "fields": [] } ], "properties": { "owner": "root", "write.parquet.compression-codec": "zstd" }, "current-snapshot-id": 182508751058227124, "refs": { "main": { "snapshot-id": 182508751058227124, "type": "branch" } }, "snapshots": [ { "sequence-number": 1, "snapshot-id": 3184998010965770286, "timestamp-ms": 1788713361940, "summary": { "operation": "append", "spark.app.id": "local-1788713089586", "added-data-files": "3", "added-records": "3", "added-files-size": "4690", "changed-partition-count": "1", "total-records": "3", "total-files-size": "4690", "total-data-files": "3", "total-delete-files": "0", "total-position-deletes": "0", "total-equality-deletes": "0", "engine-version": "3.5.5", "app-id": "local-1788713089586", "engine-name": "spark", "iceberg-version": "Apache Iceberg 1.8.1 (commit 9ce0fcf0af7becf25ad9fc996c3bad2afdcfd33d)" }, "manifest-list": "s3://warehouse/iceberg_db/orders/metadata/snap-3184998010965770286-1-73b80391-9579-4774-aa23-5adafa02156b.avro", "schema-id": 0 }, { "sequence-number": 2, "snapshot-id": 182508751058227124, "parent-snapshot-id": 3184998010965770286, "timestamp-ms": 1788714006920, "summary": { "operation": "overwrite", "spark.app.id": "local-1788713089586", "added-data-files": "1", "deleted-data-files": "1", "added-records": "1", "deleted-records": "1", "added-files-size": "1632", "removed-files-size": "1550", "changed-partition-count": "1", "total-records": "3", "total-files-size": "4772", "total-data-files": "3", "total-delete-files": "0", "total-position-deletes": "0", "total-equality-deletes": "0", "engine-version": "3.5.5", "app-id": "local-1788713089586", "engine-name": "spark", "iceberg-version": "Apache Iceberg 1.8.1 (commit 9ce0fcf0af7becf25ad9fc996c3bad2afdcfd33d)" }, "manifest-list": "s3://warehouse/iceberg_db/orders/metadata/snap-182508751058227124-1-7cec91b6-902c-4259-90ad-140c2b1147ff.avro", "schema-id": 0 } ], "statistics": [], "partition-statistics": [], "snapshot-log": [ { "timestamp-ms": 1788713361940, "snapshot-id": 3184998010965770286 }, { "timestamp-ms": 1788714006920, "snapshot-id": 182508751058227124 } ], "metadata-log": [ { "timestamp-ms": 1788713353050, "metadata-file": "s3://warehouse/iceberg_db/orders/metadata/00000-4b1fbf0d-56df-4f33-8248-f91c0e8826ce.metadata.json" }, { "timestamp-ms": 1788713362032, "metadata-file": "s3://warehouse/iceberg_db/orders/metadata/00001-a207558c-c13f-40e1-bc18-c5f232a10c20.metadata.json" } ]}Схема таблицы (schemas).
Хранит структуру таблицы: имена полей, типы данных и уникальный ID каждого поля. Благодаря этому Iceberg поддерживает полный набор операций эволюции схемы — добавление, удаление, переименование и изменение порядка столбцов:
"schemas": [ { "type": "struct", "schema-id": 0, "fields": [ {"id": 1, "name": "id", "type": "long"}, {"id": 2, "name": "user_id", "type": "long"}, {"id": 3, "name": "amount", "type": "decimal(10, 2)"}, {"id": 4, "name": "status", "type": "string"}, {"id": 5, "name": "created_at", "type": "timestamptz"} ] }]Что произошло бы при удалении столбца amount?
spark.sql("ALTER TABLE iceberg_db.orders DROP COLUMN amount")В schemas появится новая версия схемы с новым schema-id, а старый снапшот схемы сохранится в истории:
"current-schema-id": 1,"schemas": [ { "type": "struct", "schema-id": 0, "fields": [ {"id": 1, "name": "id", "type": "long"}, {"id": 2, "name": "user_id", "type": "long"}, {"id": 3, "name": "amount", "type": "decimal(10, 2)"}, {"id": 4, "name": "status", "type": "string"}, {"id": 5, "name": "created_at", "type": "timestamptz"} ] }, { "type": "struct", "schema-id": 1, "fields": [ {"id": 1, "name": "id", "type": "long"}, {"id": 2, "name": "user_id", "type": "long"}, {"id": 4, "name": "status", "type": "string"}, {"id": 5, "name": "created_at", "type": "timestamptz"} ] }]Столбец amount с id: 3 пропадёт из текущей схемы, но останется в старой версии schema-id: 0. Parquet-файлы не перезаписываются — данные столбца физически остаются внутри файлов. Однако rollback не восстанавливает схему: после отката таблица читается по текущей схеме, в которой столбца amount уже нет. Чтобы вернуть столбец, нужна отдельная операция изменения схемы, а не rollback.
current-snapshot-id
Это текущая версия таблицы после UPDATE. Именно на неё сейчас указывает каталог. Видим, что “current-snapshot-id”: 182508751058227124. Это указатель на текущее состояние таблицы, то есть на актуальный на данный момент снапшот. После UPDATE строки текущим стал второй снапшот (182508751058227124), потому что он отражает состояние после обновления записи.
snapshots
Здесь хранится вся история таблицы:
Снапшот 1 (INSERT 3 записи) { "sequence-number": 1, "snapshot-id": 3184998010965770286, "timestamp-ms": 1788713361940, "summary": { "operation": "append", "spark.app.id": "local-1788713089586", "added-data-files": "3", "added-records": "3", "added-files-size": "4690", "changed-partition-count": "1", "total-records": "3", "total-files-size": "4690", "total-data-files": "3", "total-delete-files": "0", "total-position-deletes": "0", "total-equality-deletes": "0", "engine-version": "3.5.5", "app-id": "local-1788713089586", "engine-name": "spark", "iceberg-version": "Apache Iceberg 1.8.1 (commit 9ce0fcf0af7becf25ad9fc996c3bad2afdcfd33d)" }, "manifest-list": "s3://warehouse/iceberg_db/orders/metadata/snap-3184998010965770286-1-73b80391-9579-4774-aa23-5adafa02156b.avro",-
operation:append— добавили новые данные, -
added-records: 3— вставили 3 записи, -
total-records: 3— всего в таблице 3 записи, -
manifest-list— ссылка на файл со списком всех данных.
Снапшот 2 (UPDATE записи) { "sequence-number": 2, "snapshot-id": 182508751058227124, "parent-snapshot-id": 3184998010965770286, "timestamp-ms": 1788714006920, "summary": { "operation": "overwrite", "spark.app.id": "local-1788713089586", "added-data-files": "1", "deleted-data-files": "1", "added-records": "1", "deleted-records": "1", "added-files-size": "1632", "removed-files-size": "1550", "changed-partition-count": "1", "total-records": "3", "total-files-size": "4772", "total-data-files": "3", "total-delete-files": "0", "total-position-deletes": "0", "total-equality-deletes": "0", "engine-version": "3.5.5", "app-id": "local-1788713089586", "engine-name": "spark", "iceberg-version": "Apache Iceberg 1.8.1 (commit 9ce0fcf0af7becf25ad9fc996c3bad2afdcfd33d)" }, "manifest-list": "s3://warehouse/iceberg_db/orders/metadata/snap-182508751058227124-1-7cec91b6-902c-4259-90ad-140c2b1147ff.avro",-
operation: overwrite— перезапись (UPDATE внутри), -
parent-snapshot-id— ссылка на предыдущий снапшот, -
added-data-files: 1— создан один новый файл с обновлённой записью, -
deleted-data-files: 1— один старый файл помечен как удаленный, -
total-records: 3— записей по-прежнему три (одна обновлена).
Как правильно получить snapshot ID
Snapshot ID — 64-битное число. JavaScript хранит точно только до 2^53, поэтому в браузерной консоли MinIO последние цифры могут исказиться. Надёжнее брать ID из SQL:
SELECT snapshot_id, parent_id, operation, committed_atFROM iceberg_db.orders.snapshotsORDER BY committed_at;Time Travel
Iceberg позволяет читать таблицу на момент прошлого снапшота, не меняя её текущее состояние. Это и есть Time Travel в строгом смысле.
Чтобы посмотреть список снапшотов обратимся к orders.snapshots:
SELECT snapshot_id, parent_id, operation, committed_atFROM iceberg_db.orders.snapshotsORDER BY committed_at;До UPDATE был снапшот 3184998010965770286, а после — 182508751058227124.
Тогда можно прочитать состояние до UPDATE:
SELECT *FROM iceberg_db.orders VERSION AS OF 3184998010965770286ORDER BY id;Можно читать и по времени коммита:
SELECT *FROM iceberg_db.orders TIMESTAMP AS OF '2026-09-05 13:35:00'ORDER BY id;Важно: VERSION AS OF и TIMESTAMP AS OF — это только чтение. Они не переключают таблицу на старую версию. Для переключения нужен rollback.
Теперь попробуем откатиться к прошлой версии снапшота: для этого в Iceberg есть специальная процедура. К слову, в Iceberg множество процедур для различных ситуаций:
Процедура
Назначение
Пример вызова
rewrite_data_files
Компактизация: объединяет множество мелких файлов в более крупные для ускорения запросов и снижения нагрузки на метаданные.
CALL system.rewrite_data_files('iceberg_db.orders')
expire_snapshots
Удаляет старые снапшоты и связанные с ними файлы данных, которые больше не нужны.
CALL system.expire_snapshots('iceberg_db.orders', TIMESTAMP '2026-09-01 00:00:00')
remove_orphan_files
Удаляет осиротевшие файлы — те, что физически есть в хранилище, но на них нет ссылок в метаданных Iceberg.
CALL system.remove_orphan_files(table => 'iceberg_db.orders')
rewrite_manifests
Переписывает и консолидирует файлы манифестов, чтобы оптимизировать их структуру и ускорить планирование запросов. Рекомендуется для таблиц с большим количеством снапшотов.
CALL system.rewrite_manifests('iceberg_db.orders')
rollback_to_snapshot
Откатывает таблицу к состоянию на конкретный снапшот по его ID.
CALL system.rollback_to_snapshot('iceberg_db.orders', 3184998010965770286)
Процедура expire_snapshots из таблицы выше требует особой аккуратности, так как она ограничивает Time Travel. Процедура удаляет старые снапшоты и связанные с ними data-файлы. После её выполнения VERSION AS OF и TIMESTAMP AS OF по удалённым снапшотам работать не будут — вернуться к этим версиям уже нельзя. Срок хранения снапшотов задаётся свойствами таблицы:
ALTER TABLE iceberg_db.orders SET TBLPROPERTIES ( 'history.expire.max-snapshot-age-ms' = '432000000', -- 5 дней 'history.expire.min-snapshots-to-keep' = '10');Не менее осторожной должна быть процедура remove_orphan_files. Она ищет в хранилище файлы, на которые нет ссылок в метаданных, и удаляет их. Если параллельно идёт длительная запись, её файлы могут быть ещё не закоммичены, но уже физически лежат в хранилище — и remove_orphan_files может принять их за «осиротевшие» и удалить. Это повредит таблицу. Запускать процедуру стоит с безопасной задержкой:
CALL system.remove_orphan_files( table => 'iceberg_db.orders', older_than => current_timestamp() - interval '3' day);Берём ID предыдущего снапшота из файла metadata.json, который мы смотрели ранее.
Первый снапшот (INSERT 3 записи): 3184998010965770286.
# Откатываемся к состоянию ДО UPDATEspark.sql("CALL system.rollback_to_snapshot('iceberg_db.orders', 3184998010965770286)")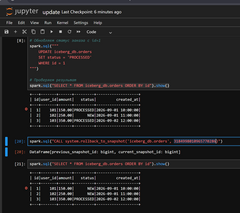
Мы успешно откатили таблицу к состоянию до UPDATE: id=1 имел статус PROCESSED и снова стал NEW.
После выполнения rollback_to_snapshot таблица вернулась к состоянию первого INSERT. Данные физически не перезаписывались.
rollback_to_snapshot — это metadata-only операция, она не читает и не перезаписывает файлы данных. Вместо этого создаётся новый metadata.json (следующая версия), в котором поле current-snapshot-id указывает на выбранный старый снапшот. Старый metadata.json остаётся на месте как часть истории таблицы.
"current-snapshot-id": 3184998010965770286, "refs": { "main": { "snapshot-id": 3184998010965770286, "type": "branch" } },Партиционирование в Apache Iceberg
Партиционирование — это способ группировки данных для ускорения запросов. В Iceberg оно работает немного иначе, чем в классических системах.
Как это работает
Задание партиций. При создании таблицы задаётся правило группировки через трансформ-функции: days(order_date), months(order_date), bucket(10, user_id). Это называется partition spec. Данные при записи раскладываются по файлам в соответствии с этим правилом.
Скрытое партиционирование (hidden partitioning). Пользователь не видит партиций и не указывает их в запросах. Iceberg сам применяет трансформ к фильтрам по исходным колонкам. Если таблица партиционирована по days(order_date), запрос с WHERE order_date = '2026-02-01' прочитает только данные за этот день.
Эволюция партиционирования. Стратегию можно изменить в любой момент через ALTER TABLE ... ADD PARTITION FIELD. Старые данные остаются в прежних партициях, новые пишутся по новой схеме.
Оптимизация запросов (partition pruning). При выполнении запроса Iceberg смотрит в метаданные, определяет, какие трансформы применены к колонкам, и читает только те файлы, которые попадают в нужные партиции.
Ключевое отличие от Hive
Iceberg не полагается на имена папок для отсечения партиций. В Hive путь order_date_day=2026-01-01/ сам по себе является партицией. В Iceberg информация о партициях хранится в метаданных — в манифестах. Для каждого data-файла манифест содержит значения партиционных полей и их границы (min/max).
Это даёт два преимущества:
-
Partition pruning работает по метаданным, а не по структуре каталогов. Iceberg может вообще не раскладывать данные по папкам — физическая структура не является контрактом.
-
Стратегию партиционирования можно менять без перезаписи данных. В Hive она задаётся при создании таблицы и не подлежит изменению без полной перезаписи. Iceberg позволяет добавлять новые партиционные поля на лету.
Пример: добавляем партиционирование по user_id.
Создадим таблицу с партиционированием по дням:
CREATE TABLE iceberg_db.orders_partition ( id BIGINT, user_id BIGINT, amount DECIMAL(10,2), status STRING, order_date DATE)USING icebergPARTITIONED BY (days(order_date))Вставим данные за разные дни:
INSERT INTO iceberg_db.orders_partition VALUES (1, 101, 150.00, 'NEW', DATE '2026-01-01'), (2, 102, 250.00, 'NEW', DATE '2026-01-15'), (3, 103, 350.00, 'PROCESSED', DATE '2026-02-01'), (4, 104, 450.00, 'NEW', DATE '2026-02-15')В metadata.json появится секция partition-specs:
"partition-specs": [ { "spec-id": 0, "fields": [ { "name": "order_date_day", "transform": "day", "source-id": 5, "field-id": 1000 } ] }]Теперь добавим партиционирование по user_id — это даст возможность эффективно фильтровать не только по дате, но и по пользователю:
ALTER TABLE iceberg_db.orders_partitionADD PARTITION FIELD bucket(10, user_id)Iceberg не переписывает данные и не создаёт новые папки для старых записей. Он лишь обновляет метаданные: добавляет новый partition-spec и меняет default-spec-id.
В обновлённом metadata.json:
-
default-spec-idтеперь указывает на 1 — новые данные будут писаться по новой схеме; -
в массиве partition-specs появился второй spec с
spec-id: 1, содержащий два поля:order_date_day(от старого spec) иuser_id_bucket(новое); -
старый spec с
spec-id: 0никуда не исчез — он всё ещё хранится в метаданных и описывает структуру старых данных.
"default-spec-id": 1,"partition-specs": [ { "spec-id": 0, "fields": [ { "name": "order_date_day", "transform": "day", "source-id": 5, "field-id": 1000 } ] }, { "spec-id": 1, "fields": [ { "name": "order_date_day", "transform": "day", "source-id": 5, "field-id": 1000 }, { "name": "user_id_bucket", "transform": "bucket[10]", "source-id": 2, "field-id": 1001 } ] }]Старые данные остаются в партициях по дням, новые получат дополнительное разбиение по user_id. Iceberg хранит все исторические версии схемы партиционирования и при запросах использует актуальную информацию для оптимизации.
Copy-on-Write (COW)
По умолчанию в Apache Iceberg для операций UPDATE, DELETE и MERGE используется режим Copy-on-Write. В нашем эксперименте с UPDATE использовался именно этот режим.
Когда мы обновляем или удаляем запись, Iceberg находит все файлы, содержащие эту запись. Вместо их изменения он полностью перезаписывает эти файлы, создавая новые версии уже с примененными изменениями. При этом старые файлы помечаются как устаревшие.
-
Главный плюс: максимальная скорость чтения. В файлах данных никогда нет мусора, и читать их нужно как есть.
-
Главный минус: высокая нагрузка на запись. Даже изменение одной строчки в огромном файле приведет к перезаписи всего этого файла. Это делает COW неэффективным для частых обновлений.
Это больше подходит для сценариев, где данные обновляются редко, но читаются очень часто и требуют максимальной скорости.
Merge-on-Read (MOR)
В данном режиме при обновлении или удалении записи Iceberg не трогает существующие файлы с данными. Вместо этого он создаёт небольшой отдельный файл с изменениями. В этом файле хранится информация, какую запись и как нужно изменить.
Когда мы читаем данные, движок вынужден на лету совмещать (merge) исходные файлы и все накопившиеся файлы с изменениями, чтобы показать финальную версию.
-
Главный плюс: максимальная скорость записи. Операции обновления выполняются очень быстро, так как не требуют перезаписи больших файлов.
-
Главный минус: замедление чтения. Со временем копятся файлы с изменениями, и каждый запрос тратит всё больше времени на их склейку. Это требует периодической
компактизации — процесса, который применяет все накопленные изменения и создаёт чистые файлы.
Как переключить режим
Режим задаётся на уровне таблицы через свойства. Посмотреть текущие настройки:
SHOW TBLPROPERTIES iceberg_db.orders;Включить Merge-on-Read:
ALTER TABLE iceberg_db.ordersSET TBLPROPERTIES ( 'write.update.mode' = 'merge-on-read', 'write.delete.mode' = 'merge-on-read', 'write.merge.mode' = 'merge-on-read');Вернуть Copy-on-Write (по умолчанию):
ALTER TABLE iceberg_db.ordersSET TBLPROPERTIES ( 'write.update.mode' = 'copy-on-write', 'write.delete.mode' = 'copy-on-write', 'write.merge.mode' = 'copy-on-write');В Apache Iceberg эти две стратегии позволяют гибко настраивать таблицы под конкретную нагрузку. Выбор между COW и MOR — это, по сути, компромисс между скоростью записи и скоростью чтения.
-
COW даёт максимальную производительность запросов ценой более медленных и тяжёлых операций записи.
-
MOR обеспечивает быструю запись большого потока изменений, но требует либо мириться с более медленными запросами, либо периодически тратить ресурсы на компактизацию для очистки данных.
Ограничения Iceberg
Iceberg решает много проблем озера данных, но не все. Вот о чём стоит помнить:
-
Мелкие файлы. Частая запись мелкими порциями замедляет планирование. Лечится
rewrite_data_files. -
Конкурентность. Оптимистичная: при конфликте коммит повторяется или падает.
-
Схема. Удалённый столбец не восстанавливается через rollback, сужение типа не поддерживается.
Что по итогу?
Iceberg — это табличный формат для Data Lake, который решает проблемы, знакомые каждому дата-инженеру: отсутствие транзакций, сложности с эволюцией схемы и партиционирования, невозможность отката. Работает поверх Parquet/ORC, не требует перезаписи данных и не претендует на замену DWH. Просто делает озеро чуть более управляемым — но, как и любой инструмент, требует обслуживания: компактизации, expire снапшотов, мониторинга метаданных.
Источник: habr.com