
Ollama server настройка
Устанавливаем ollama server
brew install ollamaUbuntu
#curl -fsSL https://ollama.com/install.sh | sh
Запускаем сервер. Если требуется, чтобы сервер был доступен не только на локальной машине, но и на эмуляторе или c любого телефона в сети надо добавить: OLLAMA_HOST=0.0.0.0 тогда к серверу можно будет обращаться через IP
OLLAMA_HOST=0.0.0.0:11434 ollama serveЗагружаем модели. Например gemma4:12b
ollama pull gemma4:12bПроверяем что сервер запущен и модель доступна. Для MacBook на чипе с ARM архитектурой cкачиваем mlx модели.gemma4:12b-mlx.PROCESSOR 100% GPU означает, что вся модель загружена в память видеокарты (GPU), и все вычисления (генерация токенов) идут на GPU, а не на CPU.
ollama show gemma4:12b-mlxЗапущенная модель:
#ollama ps
NAME ID SIZE PROCESSOR CONTEXT RUNNER UNTIL
gemma4:e4b-mlx 5a08735df03c 9.4 GB 100% GPU 4096 mlx 4 minutes from now
Список всех установленных моделей:
#ollama list
NAME ID SIZE MODIFIED nomic-embed-text:latest 0a109f422b47 274 MB 24 hours ago qwen3.5:9b-mlx 203e30078279 8.9 GB 2 days ago gemma4:12b-mlx ded7a2735003 7.7 GB 2 days ago gemma4:e4b-mlx 5a08735df03c 9.5 GB 2 days ago Проверить реальный запрос из локальной сети
#curl -s http://127.0.0.1:11434/api/generate -d '{ "model": "gemma4:e4b-mlx", "prompt": "Привет", "stream": false}'Привет
{ "model": "gemma4:e4b-mlx", "created_at": "2026-11-06T18:05:23.518505Z", "response": "Привет! 😊 Чем я могу помочь?", "done": true, "done_reason": "stop", "context": [2,105,9731,...], "total_duration": 269059958, "load_duration": 638667, "prompt_eval_count": 18, "prompt_eval_cached_count": 17, "prompt_eval_duration": 9167, "eval_count": 8, "eval_duration": 266089083}Или так:
ollama run gemma4:12b "Объясни, что такое Kotlin"Android Studio Agent
Можно пробовать подключать Агента в Android Studio
 ollama AI Agent Android Studio
Android/iOS client ollama
Все настроено. Переходим к мобильному клиенту. Создаем новый проект на kmp с общим UI.
 Новый проект
В качестве Di выбираем Koin. UI общий для двух платформ. Делаем максимально просто. Koin так же поддерживает ViewModel для kmp из коробки. Для запросов в сеть используется Ktor.
В KMP можно использовать глобальный startKoin, но для Compose Multiplatform удобнее koinApplication. Он создает локальный контейнер прямо внутри Composable-функции App(). Это спасает от конфликтов при использовании @Preview в Android Studio, гарантирует правильный жизненный цикл и позволяет обойтись без правок Swift-кода для iOS.
Различия koinApplication от startKoin:
koinApplication возвращает контейнер (и его scope) только вам; startKoin возвращает его ещё и в глобальный GlobalContext, делая scope видимыми и живущими на уровне всего процесса. Всё остальное — следствия этого одного различия
scope «возвращается»
// koinApplication — scope «возвращается» только вамval koinApp = koinApplication { modules(appModule) }val sessionScope = koinApp.koin.createScope("session")// никто, кроме этого кода, sessionScope не видитsessionScope.close()koinApp.close() // всё умерло// startKoin — scope «возвращается» в GlobalContextstartKoin { modules(appModule) }val sessionScope = GlobalContext.get().createScope("session")// теперь scope виден всему процессу через GlobalContextstopKoin() // всё умерлоДоступность API: startKoin (глобальный) vs composable KoinApplication (локальный)
startKoin (глобальный)
KoinApplication (локальный)
koinInject()
✅
✅
koinViewModel()
✅
✅
by inject()
✅
❌
by viewModel()
✅
❌
get() (top-level)
✅
❌
getKoin()
✅
❌
KoinComponent
✅
❌
androidContext()
✅
❌ (нужен startKoin)
Общая точка входа в приложение:
@Composable@Previewfun App( appDeclaration: KoinAppDeclaration = {}) { KoinApplication(configuration = koinConfiguration { modules( viewModelModule, commonModule ) }) { MaterialTheme { RootScreen() } }}Для примера достаточно. Еще один плюс — не надо править Swift-код (например, ContentView.swift), который сгенерировала Android Studio. Мы пишем в Android Studio и оттуда же запускаем на Android и iPhone.
Однако для сборки под iOS всё равно понадобится Xcode и macOS. KMP освобождает нас от написания UI на Swift, но не отменяет инструменты Apple. Кроме того, если понадобится настроить Info.plist (например, добавить NSAllowsArbitraryLoads для HTTP) или подключить нативные SDK, заходить в Xcode всё же придется.
Стоит отметить, что у KoinApplication могут быть свои подводные камни. В частности, я пока не разобрался, как правильно разбивать на модули большое приложение в такой архитектуре. Также открытым остается вопрос: достаточно ли использовать только koinInject() для Compose, или где-то всё же обязательно понадобится классический inject(). Буду рад, если кто-то поделится опытом в комментариях.
Подход вызывать initKoin из iOS и Android:
initKoin()
fun MainViewController() = ComposeUIViewController( configure = { initKoin() }) { App()}// android:name=".MyApp"class MyApp : Application(), KoinComponent { override fun onCreate() { super.onCreate() initKoin { androidLogger() androidContext(this@MyApp) } }}fun initKoin(appDeclaration: KoinAppDeclaration = {}) = startKoin { appDeclaration() modules( databaseModule, networkModule, repositoryModule, viewmodelModule ) }Поскольку сервер у нас на http вместо https, не забываем usesCleartextTraffic. Кстати, эмулятор iPhone разрешил доступ без изменений. Помнится я добавлял NSAllowsArbitraryLoads.
usesCleartextTraffic
android:usesCleartextTraffic="true"usesCleartextTraffic — это атрибут в AndroidManifest.xml (начиная с API 23), который определяет, разрешает ли приложение незашифрованный HTTP-трафик (cleartext)
iPhone
NSAppTransportSecurity NSAllowsArbitraryLoads Далее добавил Navigation3. Хорошая статья Navigation3 + Koin в Compose Multiplatform. Понравились комментарии в которых обсуждалось, стоит ли хранить последнее состояние экранов.
SavedStateConfiguration
val config = remember { SavedStateConfiguration { serializersModule = SerializersModule { polymorphic(NavKey::class) { subclassesOfSealed() } } } } val backStack = rememberNavBackStack(config, HomeRoute) // Текущий маршрут (последний в стеке) — для title / bottom bar val currentRoute: NavKey? = backStack.lastOrNull()encodeDefaults
Стоит упомянуть о двух режимах ответа Ollama — потоковый (стриминг) и целый
В Ollama это управляется полем stream в запросе к /api/generate, /api/chat. Нельзя ставить stream = false по умолчанию! Сериализатор затрет это поле если вы зададите ему false. Ollama по умолчанию отдаст вам поток, что приведет к неожиданному результату. Это можно поправить настройками сериализатора, но я потратил время что бы понять, куда делся stream из запроса. View->Tool Windows->App Inspector->Network Inspector в помощь.
OllamaRequest(model = settings.getCurrentModel().id, prompt = prompt, stream = false)Модель запроса:
@Serializabledata class OllamaRequest( val model: String, val prompt: String, val stream: Boolean // не присваивать false в этом месте)Можно поправить настройками сериализатора:
json(Json { ignoreUnknownKeys = true isLenient = true encodeDefaults = true // ← гарантирует, что stream попадёт в JSON})«По умолчанию Kotlinx.Serialization не сериализует поля, значения которых совпадают с дефолтными (в данном случае
false). Ollama, не найдя в JSON явного указанияstream: false, включает потоковый режим по умолчанию. НастройкаencodeDefaults = trueспасает ситуацию».
Если обращаться к чату, то требуется задать роль. В /api/chat роль обязательна для каждого сообщения. В /api/generate ролей нет вообще — там просто prompt
Магия тут
package com.kmp.ollamechat.repositoryimport com.example.chatkmpdontshareui.repository.model.OllamaRequestimport com.example.chatkmpdontshareui.repository.model.OllamaResponseimport io.ktor.client.HttpClientimport io.ktor.client.call.bodyimport io.ktor.client.request.postimport io.ktor.client.request.setBodyimport io.ktor.http.ContentTypeimport io.ktor.http.contentTypeclass OllamaClient( private val settings: Settings, private val client: HttpClient) { suspend fun sendPrompt(serverUrl: String, prompt: String): Result { return try { val response: OllamaResponse = client.post("$serverUrl/api/generate") { contentType(ContentType.Application.Json) // Вставляем объект запроса. Ktor сам его сериализует в JSON. setBody( OllamaRequest( model = settings.getCurrentModel().id, prompt = prompt, stream = false ) ) // Если используете Ollama Cloud, раскомментируйте: // header(HttpHeaders.Authorization, "Bearer ВАШ_КЛЮЧ") }.body() // Получаем и десериализуем ответ Result.success(response.response ?: "Unknown Error") } catch (e: Exception) { Result.failure(e) } }}Ответы потока
Привет
{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.399462Z","message":{"role":"assistant","content":"Привет"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.411176Z","message":{"role":"assistant","content":"!"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.474175Z","message":{"role":"assistant","content":" Чем"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.532257Z","message":{"role":"assistant","content":" могу"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.596336Z","message":{"role":"assistant","content":" помочь"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.596359Z","message":{"role":"assistant","content":"?"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.596427Z","message":{"role":"assistant","content":" 😊"},"done":false}{"model":"gemma4:e4b-mlx","created_at":"2026-11-09T03:41:29.596487Z","message":{"role":"assistant","content":""},"done":true,"done_reason":"stop","total_duration":358141959,"load_duration":1705667,"prompt_eval_count":18,"prompt_eval_cached_count":17,"prompt_eval_duration":236000,"eval_count":7,"eval_duration":353180958}Магия потока
package com.kmp.ollamechat.clientimport com.kmp.ollamechat.chat.ChatRequestimport com.kmp.ollamechat.chat.OllamaChatChunkimport com.kmp.ollamechat.chat.OllamaChatRequestimport com.kmp.ollamechat.repository.Settingsimport com.kmp.ollamechat.repository.model.StreamOllamaEventimport io.ktor.client.HttpClientimport io.ktor.client.plugins.ResponseExceptionimport io.ktor.client.request.preparePostimport io.ktor.client.request.setBodyimport io.ktor.client.statement.bodyAsChannelimport io.ktor.http.ContentTypeimport io.ktor.http.contentTypeimport io.ktor.utils.io.readLineimport kotlinx.coroutines.flow.Flowimport kotlinx.coroutines.flow.flowimport kotlinx.serialization.json.Json/** * streamChat() * Стриминговый запрос к /api/chat. * Возвращает Flow: токены по мере генерации + Done/Error. * Flow отменяемый — отмена корутины закрывает соединение и останавливает генерацию. */class StreamOllamaClient( private val settings: Settings, private val client: HttpClient, private val json: Json) { fun streamChat( serverUrl: String, messages: List, modelId: String, ): Flow = flow { // Переменная для отслеживания финального статуса: SUCCESS, ERROR или PREMATURE_CLOSE var finalEvent: StreamOllamaEvent? = null try { client.preparePost("$serverUrl/api/chat") { contentType(ContentType.Application.Json) setBody( OllamaChatRequest( model = modelId, messages = messages, keepAlive = "10m", stream = true ) ) }.execute { response -> val channel = response.bodyAsChannel() while (!channel.isClosedForRead) { val line = channel.readLine() ?: break if (line.isBlank()) continue val chunk = try { json.decodeFromString(line) } catch (e: Exception) { finalEvent = StreamOllamaEvent.Error("Не удалось распарсить чанк: $line", e) break // Просто выходим из цикла, выполнение пойдет ниже } if (chunk.error != null) { finalEvent = StreamOllamaEvent.Error(chunk.error) break } val msg = chunk.message msg?.thinking?.takeIf { it.isNotEmpty() }?.let { emit(StreamOllamaEvent.Thinking(it)) } msg?.content?.takeIf { it.isNotEmpty() }?.let { emit(StreamOllamaEvent.Token(it)) } if (chunk.done) { finalEvent = StreamOllamaEvent.Done(chunk.evalCount) break } } // Если цикл прервался, но finalEvent не выставлен (например, сервер закрыл канал раньше времени) val eventToSend = finalEvent ?: StreamOllamaEvent.Done(null) emit(eventToSend) } } catch (e: ResponseException) { emit(StreamOllamaEvent.Error("HTTP ${e.response.status.value}", e)) } catch (e: Exception) { emit(StreamOllamaEvent.Error(e.message ?: "Unknown error", e)) } }}На экране это выглядит так:
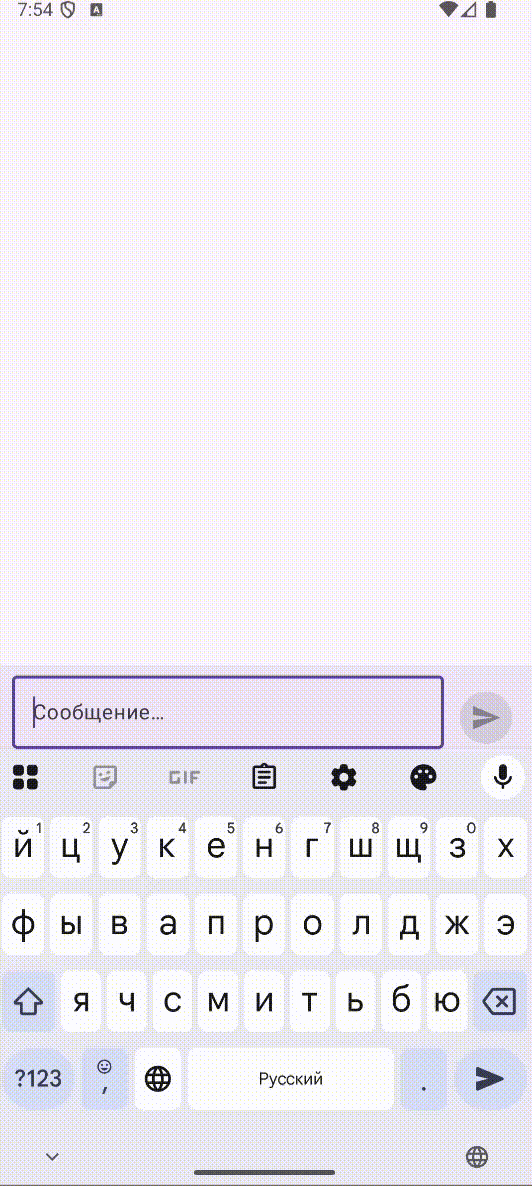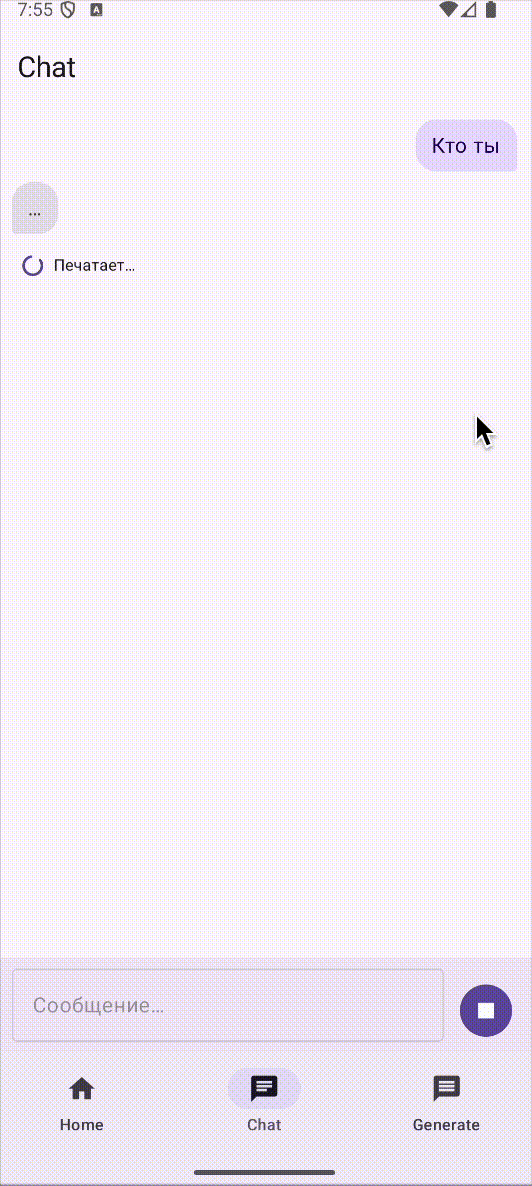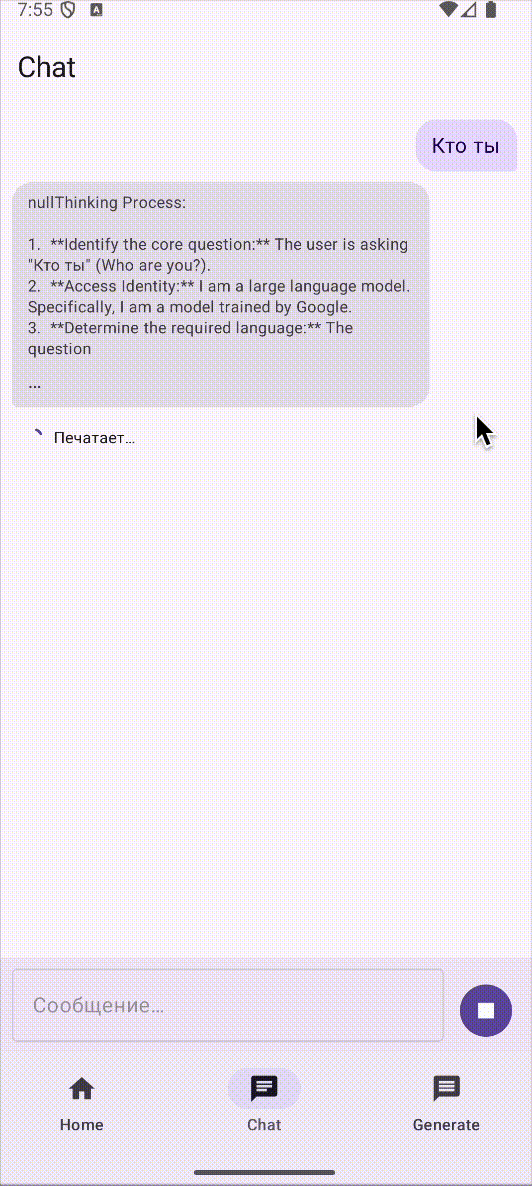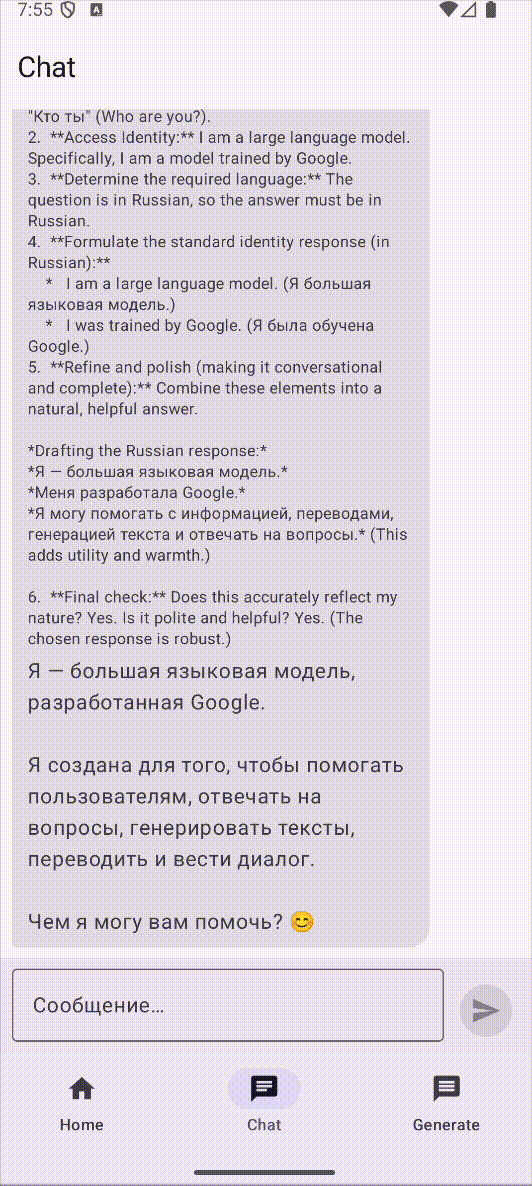 Ответ в потоке
 сразу не заработал. Довольно быстро выяснил, что данные отдаются целиком а не кусками. Все обновляется в самом конце ответа. Решал дооолго. Несколько часов. Сначала думал, что OkHttp буферизирует данные. Вспомнил expect/actual, разнес по платформам. Не помогло.
Оказалось, использовал не тот метод: вместо post() надо preparePost(). Хотя у post() под капотом тоже есть execute().
После замены на preparePost() печать пошла.
Помимо основного ответа, обрабатывается также ответ Thinking.
Посмотреть код на git:
https://github.com/app-z/OllameChatKmp
Требуется немного довести до ума UI и добавить сохранение истории чатов.
Осталось скормить модели документацию компании — и идеальный ИИ-чат-бот поддержки готов. Ну, почти…
Также я написал клиента для облачных моделей cloud.ru (с загрузкой картинок и аудио). Правда, это уже совсем другая история. Главное, что стоит знать: токены в облаке сгорают очень быстро. Но и скорость впечатляет — на задачу по переименованию проекта модель потратила всего 5 минут и около 50 рублей. Конечная цена и скорость напрямую зависят от выбранной модели.
Если статья была полезной — можете угостить меня чашкой кофе. Автор будет пить его, пока пишет продолжение про cloud.ru
 Чашка кофе
Пишите!
Источник: habr.com