
Привет, Хабр!
Меня зовут Андрей Бирюков. Я — независимый эксперт в области ИТ и ИБ, преподаю в учебных центрах и пишу статьи и книги.
Требования к производительности сети в последние годы существенно увеличились, и классический Ethernet уже не всегда справляется с поставленными задачами. Для высокопроизводительных вычислений в качестве альтернативы предлагается использовать InfiniBand (IB).
Будет не совсем верно называть данную технологию ускоренным Ethernet или эволюцией TCP/IP, так как это отдельный стек протоколов, спроектированный с нуля под высокопроизводительные вычисления, где каждый компонент — от физического уровня до API — оптимизирован под одну цель: доставить данные из точки А в точку Б с минимальной и, что ещё важнее, предсказуемой задержкой.
В эпоху обучения больших языковых моделей эта специализация вновь стала критически востребованной, хотя ещё десять лет назад многие предрекали InfiniBand забвение.
В этой статье мы подробно рассмотрим принципы работы и основные компоненты IB.
Что такое InfiniBand на уровне архитектуры
InfiniBand представляет собой коммутируемую фабрику с кредитным управлением потоком на уровне линка.
Это означает, что, в отличие от Ethernet, где потери пакетов при перегрузке являются штатным механизмом сигнализации (TCP воспринимает их как сигнал снизить скорость), InfiniBand физически не допускает потерь на линке.
Передача не начинается, пока на приёмной стороне нет гарантированно свободного буфера для получения данных. Это обеспечивает поведение без потерь и побочных эффектов, характерных для PFC в Ethernet.
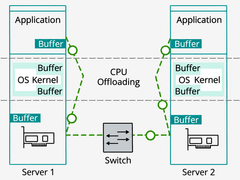
И второй ключевой элемент данной технологии — механизм Remote Direct Memory Access (RDMA).
Приложение помещает данные в буфер на стороне отправителя и даёт команду сетевой карте отправить их в память удалённого приложения, минуя ядро операционной системы и стек TCP/IP.
Благодаря этому CPU не тратит циклы на копирование и обработку сетевых пакетов, а для MPI‑приложений и коллективных операций при обучении моделей это означает, что задержка сети приближается к задержке доступа к локальной памяти.
Адресация в InfiniBand трёхуровневая, то есть в качестве аналога аппаратного MAC‑адреса выступают:
-
GUID;
-
LID — 16-битный локальный идентификатор, назначаемый Subnet Manager для маршрутизации внутри подсети;
-
GID — 128-битный глобальный идентификатор на основе IPv6.
Именно 16-битный LID ограничивает размер одной подсети InfiniBand примерно 49 тысячами unicast‑адресов.
Почему InfiniBand быстрее
Сравнение с RoCEv2 (RDMA over Converged Ethernet) на масштабе 16 384 GPU показывает разрыв, который невозможно объяснить только лишь «лучшей настройкой».
При синхронизированном обмене градиентами в AllReduce Ethernet‑фабрика с PFC и DCQCN сталкивается с:
-
коллапсом буферов на коммутаторах ToR и Spine;
-
каскадными штормами pause‑кадров;
-
падением MFU (Model FLOPs Utilization) с 51,4% до 34,2%.
А InfiniBand NDR с кредитным управлением и аппаратным in‑network computing (SHARPv3) выполняет редукцию прямо на коммутаторе, сокращая объём коллективного трафика вдвое и удерживая MFU на уровне 52,8%.
Для разреженных MoE‑моделей с трафиком All‑to‑All картина ещё жёстче. Так, аппаратная адаптивная маршрутизация InfiniBand достигает 89,4% эффективности бисекции, тогда как ECMP в RoCEv2 страдает от хеш‑поляризации и теряет 38,6% полезной пропускной способности.
Задержка для малых сообщений в InfiniBand составляет около 0,5–0,6 мкс против 1,2 мкс и выше у Ethernet в базовом режиме.
Под нагрузкой Ethernet деградирует значительно сильнее, тогда как InfiniBand сохраняет предсказуемость благодаря кредитному управлению.
Поколения скорости: от EDR до XDR
Технология InfiniBand развивается поколениями, каждое из которых удваивает скорость на порт. На рисунке ниже можно увидеть основные этапы развития этой технологии.
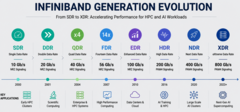
Для современных тренировочных кластеров на базе H100/H200 и коммутаторов Quantum-2 рабочей лошадкой является NDR на 400G.
XDR на 800G ориентирован на системы Blackwell и платформу Quantum‑X800; аналитики прогнозируют среднегодовой рост этого сегмента около 40%.
Помимо представленных поколений, также готовится GDR на 1.6T, которое появится в массовой продаже несколько позже, но планировать оптику с запасом под него стоит уже сейчас.
Топологии Fat‑Tree и Rail‑Optimized
Классической для InfiniBand топологией является Fat‑Tree.
В ней каждый leaf‑коммутатор подключён к каждому spine, что обеспечивает полную бисекционную пропускную способность и множественные пути между любой парой узлов.
Маршрутизация на основе LID‑таблиц (LFT), генерируемых Subnet Manager, равномерно распределяет маршруты по линкам.
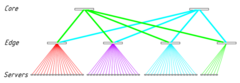
При этом для ИИ‑кластеров всё чаще используется rail‑optimized топология, в которой каждый GPU в узле подключён к выделенному «рельсу» (rail), то есть группе коммутаторов, обслуживающих соответствующие GPU через все узлы.
Например:
-
GPU 0 всех узлов подключены к rail 0;
-
GPU 1 — к rail 1;
-
и так далее.
Коллективные операции, такие как AllReduce, оптимизируются так, чтобы обмен между соответствующими GPU шёл по кратчайшему пути без перегрузки промежуточных уровней.
Это требует тщательного планирования кабельной инфраструктуры и валидации топологии на этапе развёртывания.
Subnet Manager: мозг фабрики
В отличие от Ethernet, где маршрутизация, как правило, распределена между устройствами, InfiniBand использует централизованное управление.
Для реализации этой задачи используется Subnet Manager (SM), представляющий собой специальный программный компонент, который:
-
обнаруживает топологию;
-
назначает LID‑адреса;
-
вычисляет маршруты;
-
распространяет forwarding‑таблицы на все коммутаторы.
Обычно SM работает на одном из узлов или на выделенном сервере управления, а резервный SM находится в режиме ожидания.
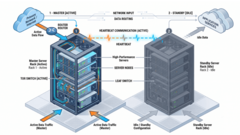
Эта централизация, с одной стороны, даёт предсказуемость, так как маршруты известны и оптимизированы, а не вычисляются распределённо.
Но с другой — она же создаёт требование к компетенции специалистов, так как неправильная конфигурация SM или ошибка в топологии могут привести к неоптимальной маршрутизации, которую трудно диагностировать без специализированных инструментов.
Ограничения, которые нельзя игнорировать
А вот теперь поговорим о бочках дёгтя и ложках мёда, то есть о тех недостатках InfiniBand, которые создают массу проблем.
Прежде всего, это привязка к одному вендору.
Дело в том, что рынок InfiniBand фактически монополизирован NVIDIA (через Mellanox), и при этом адаптеры HDR стоят $2000–3000 за порт против $800–1500 у Ethernet‑аналогов.
Соответственно, 40-портовый коммутатор обойдётся около $50 000 против $25 000, а для кластера на 1000 GPU разница в стоимости оборудования может достигать $8 млн.
Миграция на другого производителя невозможна, а переход на Ethernet в будущем потребует замены всей фабрики. Ну а про сложности с поставкой в Россию лучше лишний раз не вспоминать.
Также InfiniBand представляет собой subnet‑ориентированную технологию, и подключение к внешним сетям требует шлюзов с преобразованием протоколов.
При этом для традиционных веб‑приложений и микросервисов InfiniBand неудобен и избыточен. Поэтому на практике часто строят две параллельные сети:
-
InfiniBand — для вычислений;
-
Ethernet — для управления и внешнего доступа.
Отдельно стоит отметить дефицит экспертизы: инженеров, умеющих проектировать и эксплуатировать InfiniBand‑фабрики, значительно меньше, чем специалистов по Ethernet.
Представленные выше Subnet Manager, LID‑маршрутизация и диагностика через ibdiagnet представляют собой отдельный набор навыков, который нельзя просто перенести с Ethernet‑опыта.
Когда же выбирать InfiniBand
Решение о выборе InfiniBand представляет собой не только техническое, но и экономическое уравнение.
Дело в том, что капитальные затраты на InfiniBand выше на 24,8%, чем на RoCEv2, но при непрерывной работе тренировочного кластера премия амортизируется за 8,4 месяца за счёт более высокой скорости обучения и MFU.
Но в целом InfiniBand будет оправдан в тех случаях, когда:
-
строится выделенный тренировочный кластер на сотни или тысячи GPU, где стоимость простоя ускорителей доминирует над стоимостью сети;
-
требуется предсказуемая задержка и устойчивость к incast‑нагрузкам, которые Ethernet обрабатывает с деградацией.
И, что, возможно, самое важное, — организация готова принять вендорную привязку к NVIDIA и инвестировать в соответствующую экспертизу.
Для смешанных нагрузок и малых кластеров (менее 100 GPU), а также сред с требованием мультивендорности Ethernet остаётся более прагматичным выбором.
Делаем выводы
Мы поговорили о том, что представляет собой протокол InfiniBand и какие преимущества и недостатки он имеет.
Да, его архитектура предполагает более быструю передачу данных, что является несомненным плюсом, но необходимость заново проектировать всю сеть, а также привязка к одному вендору могут свести на нет все преимущества этой технологии.
Важно понимать, что InfiniBand не «лучше» Ethernet в абсолютном смысле. Это просто инструмент с чёткой областью применения, и понимание этой области является первым шагом к правильному архитектурному решению.
В InfiniBand маршруты между узлами рассчитывает Subnet Manager и распределяет таблицы маршрутизации по коммутаторам. Чтобы лучше понимать, как формируются сетевые пути и чем отличаются подходы к управлению ими, полезно разобраться в статической и динамической маршрутизации.
Эту тему разберём на бесплатном открытом уроке курса «Сетевой инженер»:
-
11 ноября в 20:00. «Статическая и динамическая маршрутизация». Записаться
Больше вебинаров ищите в дайджесте мероприятий ноября.
Источник: habr.com