
Собрать по кускам БЯМ и сшить из неё ассистента, отличающегося умом и сообразительностью, выливается в солидную копеечку. Выясняем, сколько в итоге нужно потратить на ChatGPT и прочих флагманов столь непростой индустрии.
ChatGPT
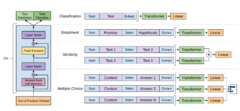
GPT-1, она же «предварительно обученный генеративный трансформер», появилась в 2018 году. Это была модель со 117 миллионами параметров, предварительно обученная на неразмеченных текстах и заложившая основы полууправляемого многоцелевого обучения для обработки естественного языка.
Уже исторический артефакт: архитектура трансформерной модели. Источник.
Самая первая итерация ГПТшной модели была маленькой и скромной, стеснительной пробой пера: её обучение обошлось создателям примерно в $1 000–4 000. Точную стоимость никогда не называли, и это станет доброй традицией OpenAI в будущем.
GPT-2 явила себя миру годом позже. На её обучение в последний “некоронованный год”, по распространённым оценкам, уже ушло около $43 000.
А вот с GPT-3 дела уже принимают серьёзный оборот. Если во второй модели было всего 1,5 миллиарда параметров, то в третьей их количество выросло в астрономические сто раз — до 175 миллиардов.
Такой качественный скачок Тройка удалая совершит в 2020-м, потому что команда OpenAI целенаправленно проверяла гипотезу: качественный скачок в универсальности и способности решать задачи без дообучения достигается за счёт экспоненциального роста параметров и данных. Точные цифры остаются в анналах OpenAI под грифом «совершенно секретно».
Штаб-квартира OpenAI. Источник.
Однако, по этому поводу Lambda Labs отписались, что для модели с таким количеством параметров понадобились бы 3,14×10²³ FLOPS, а их обработка заняла бы 355 лет на одном, самом бюджетном графическом процессоре.
Интересной статьёй расхода, как выяснил журнал Time, стал наём кенийских аннотаторов, воочию просматривавших и вручную фильтровавших контент с маркировкой «жесть» для обучения детектора вредоносного контента. Им приходилось наблюдать тёмные и отвратительные грани интернета, включая фантазии об убийствах и зоосадизм, за что работодатель Sama платил им от $1,32 до $2 в час, хотя в общей сложности OpenAI выделяла $12,50 на час такой работы. Как потом сажет один из аннотаторов: «Это была пытка».
Офис компании Sama. Источник.
Расходы на GPT-4 почти удесятерились, хотя точные цифры вновь неизвестны. Сам Альтман лишь обиняками да экивоками дал понять, что на подготовку четвёртой модели ушло больше ста миллионов долларов.
В свете одной из оценок стало известно, что Четвёрку готовили с помощью примерно 25 000 графических процессоров NVIDIA A100 на протяжении 90–100 дней. В 2022 году одна такая карта с 40 гигабайтами видеопамяти стоила порядка $10 000–12 000. Только на сами ускорители, таким образом, пришлось бы потратить около $250–300 миллионов — не считая инфраструктуры, электричества и, конечно, заоблачных зарплат инженеров-ИИшников.
Наконец, GPT-5, некоторое время носившая кодовый позывной «Орион», потребовала ресурсов уже совершенно иного масштаба. Только на тренировочный марафон, продлившийся около шести месяцев, ушло не меньше полумиллиарда долларов. В ценник вошли арендованные серверные мощности и счета за электричество. Остальные средства ушли на создание орионовской архитектуры, симуляцию тренировочных полигонов, многоагентные симуляции и оплату доступа к качественному контенту в сети.
В общем, за восемь лет любимый всеми «Чатик» скакнул со скромной тыщёнки долларов до фактически триллиона — и это ещё по скромным подсчётам.
Claude
Антропик долго не раскочегаривался и сразу запрыгнул на Олимп, чтобы выковать свою эпохальную модель. Успех во многом объясняется тем, что компания, по сути, плоть от плоти OpenAI: там ранее работали брат и сестра Дарио и Даниэлла Амодеи, а также несколько других талантливых исследователей.
Одно из мест базирования Anthropic. Источник.
Кроме того, тренировку Клода усилили так называемым конституциональным методом — это когда модель уже не нуждается в огромном количестве человеческого фидбека, а продолжает обучение в соответствии с заранее прописанными правилами. С уставом дружить — вечно человечеству служить, так сказать.
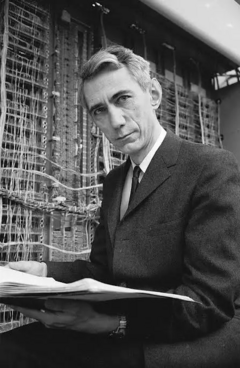
Как и в случае с ChatGPT, трудно выяснить, сколько точно было потрачено на создание Клода. Самая первая модель, названная в честь Клода Шеннона, состояла примерно из 52 миллиардов параметров и также обучалась на гугловских TPU. По приблизительным оценкам, только обучение могло обойтись в $5–15 миллионов.
Клод Элвуд Шеннон, пионер кибернетики, полимат и языковая модель. Источник.
А вот с «учебниками», которые Клод штудировал, было не всё так однозначно. Первая партия досталась Anthropic почти бесплатно: цифровые версии миллионов книг были скачаны с пиратских ресурсов вроде LibGen и Books3.
Но, как водится, бесплатный сыр книг бывает только в мышеловке. В итоге компания стала ответчиком в деле Bartz против Anthropic о нарушении авторских прав. Тяжба вылилась в гигантские $1,5 миллиарда компенсационных выплат для кармана Антропиков. Параллельно компания перешла к “Проекту Панама” — закупке подержанных печатных книг, их сканированию и использованию цифровых копий. Данная операция тоже обошлась в десятки миллионов.
Предположительно, одно из книгохранилищ Anthropic, где держались книги для “Проекта Панама”. Источник.
С более поздними версиями семейства Claude всё ещё менее прозрачно: Anthropic не раскрывает ни точных затрат на обучение, ни деталей контрактов с облачными провайдерами. Известно лишь, что компания заключила многомиллиардные соглашения о вычислительных мощностях с AWS, Google и другими партнерами, которые, по некоторым оценкам, приближаются к $895 миллиардам.
Grok
Грок — птица интересная, так как архитектурные крылья у него устроены немного иначе, чем у других. В основе Грока лежит так называемая «архитектура смеси экспертов», она же MoE.
Принцип устройства архитектуры MoE. Источник.
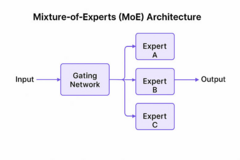
Данная архитектура использует динамическую маршрутизацию, чтобы активировать лишь часть общих экспертных подсетей для каждого запроса. Это позволяет масштабировать параметры модели, не наращивая пропорционально вычисления и энергозатраты на каждый токен.
По данным Epoch AI, на обучение Grok 4 ушло примерно $490 миллионов. Но это, видимо, копейки в сравнении с железом, необходимым для существования гроковской модели. Её мозги туго скомпонованы из 200 000 видеокарточек NVIDIA калибра H100, H200 и GB200. Цифры, кстати, отчасти раскрыл лично Маск, признавшись, что Grok 3 тренировался с помощью 100 000 видеокарт H100 — что в пересчёте на американскую валюту составляет где-то $3-4 миллиарда.
DeepSeek
Талисман китайского Дипсика — голубой кит, тихий гигант глубин, поглащающий тонну криля в сутки. Но, в отличие от своего тотемного животного, модели не нужно съедать слишком много, чтобы успешно функционировать — по крайней мере, так гласят официальные отчёты.
Похожая на автодилерский центр, штаб-квартира Дипсика в китайской “силиконовой долине”, в городе Ханчжоу. Источник.
В частности, заявляется, что на финальный прогон обучения DeepSeek-V3, дающей моментальные ответы, ушло всего $5,6 миллиона. При более чем 600 миллиардах параметров это буквально горстка ломаных грошей. Всего модели на цикл обучения понадобились 2,79 миллиона GPU-часов на процессорах H800 от всё той же Nvidia.
А модель глубокого мышления DeepSeek-R1 и вовсе тренировали 80 часов на 512 картах Nvidia H800, что встало компании в смехотворные $294 000.
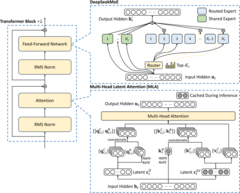
Дипсик также задействует MoE-архитектуру. Источник.
Qwen
Во сколько Alibaba обошёлся Qwen — её флагманская модель тоже построена на MoE-архитектуре, как и Грок — трудно судить. Вполне возможно, что, как и в случае с Дипсиком, один обучающий запуск обходится примерно в $5,6 миллиона.
В распоряжении Alibaba Group — целая армада из 20 000 видеопроцессоров H200, на которых, кстати, обучалась и Kimi от пекинских конкурентов Moonshot.
Зато известно, что для Qwen агрессивно срезают траты за счёт архитектурных усовершенствований. Например, методология ZeroSearch обучает модель эффективному веб-поиску и анализу информации без обращения к реальным поисковикам во время фазы обучения с подкреплением.
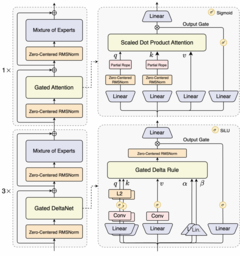
Архитектура Qwen3-Next. Источник.
В результате модель учится качественно отделять достоверные данные от шума, которым интернет обычно забит под завязку. На обучении это сказывается снижением затрат примерно на 88%. Видимо, такие ноу-хау и позволяют Квену до сих пор оставаться бюджетным для меньшинства и бесплатным для остальных.
Что всё это значит?
А значит то, что ИИ, по крайней мере LLM, — это что-то «на богатом». Свой собственный, полноценный, мощный искусственный интеллект смогут позволить себе лишь немногие государства. Россия в число таких пока что не входит, к сожалению. И кто знает, может, в скором времени появится закрытый «ИИ клуб» по аналогии с ядерным?
Источник: habr.com