
Лучшая модель на сегодня решает 12% реальных профессиональных задач. Цифра кажется опечаткой, ведь у вас наверняка завалялся проект, написанный ИИ. Но результаты нового бенчмарка GDPx от SemiAnalysis это доказывают.
SemiAnalysis, компания, известная разборами полупроводникового рынка и экономики ИИ, опубликовала 2 ноября бенчмарк GDPx. Лучший общий результат показала ИИ-модель — Claude Opus 5.5 от Anthropic. Авторы — Макс Кан, Эндрю Мегалаа и основатель SemiAnalysis Дилан Пател — строили его как самый строгий тест агентных способностей в задачах, за которые бизнес готов платить.
Чем GDPx выделяется
GDPx охватывает 11 областей: проектирование чипов и железа, кибербезопасность, биологию, финансы, право, квантовый трейдинг, материаловедение, разработку ПО, а также рекурсивное самоулучшение ИИ и alignment, то есть согласование моделей с «человеческими» целями.
Области выбирали по ожидаемому ускорению от ИИ в ближайшие год-два, доля отрасли в ВВП роли не играла. Задачи писали 14 партнеров, которые делают RL-среды для лабораторий. На каждую задачу дается до восьми часов, а модели работают в родных оболочках: Claude Code для Opus, Codex для Astra, Antigravity для Gemini, остальные в OpenCode.
Параметр
GDPx
GDPval (OpenAI)
SWE-bench Verified
Формат
многочасовые агентные задачи в среде, до восьми часов
неинтерактивные задания по рубрике
патч к репозиторию
Домены
11, от чип-дизайна до права
профессии по классификатору занятости
только код
Оценка
pass@1 из трех попыток, бинарная или частичная
эксперты-оценщики
прохождение тестов
Лучший результат
около 12%
—
—
Отдельный фокус авторы делают на GDPval, бенчмарк OpenAI от сентября 2025 года. Его задачи неинтерактивны, а согласие экспертов-оценщиков на золотом подмножестве составляло всего 71%. Когда контроль качества SemiAnalysis прогнали по Terminal Bench 4.0, он пометил как сломанные почти половину задач.
Кто где лидирует
Общий лидер — Opus 5.5, лучшая модель «на все руки», которая выигрывает квантовый трейдинг, проектирование железа и чип-дизайн. GPT-6 Astra от OpenAI побеждает в самоулучшении и материаловедении. Gemini 4 Carbon от Google стала лучшей в биологии и немного обходит конкурентов в разработке ПО. В кибербезопасности с заметным отрывом лидирует Muse Wonder Full от Meta*. Модели разделили профессии, как в хорошей фирме, и только финансы и право пока никому не достались, так как там никто не справился ни с одной задачей.
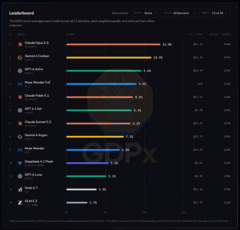 Общий зачет и распределение мест в таблице лидеров ИИ-моделей на бенчмарке GDPx. Источник.
Несколько цифр из разделов показывают, насколько задачи тяжелые. В юридической задаче на редлайн договора ни один из 20 прогонов не дал пригодного результата, средняя частичная оценка у Opus 5.5 составила 44%, у Astra 25%, у GLM-5.3 0,5%. В финансовом анализе качества прибыли за 25 попыток задачу не решила ни одна модель. В квантовом трейдинге 70 из 111 оцененных прогонов оказались хуже эталонной стратегии.
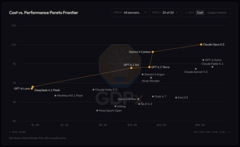 График стоимости и производительности ИИ-моделей (Pareto Frontier) в комплексном тесте GDPx. Источник.
Почему безопасность снижает баллы
Opus 5.5 и GPT-6 Astra теряют баллы из-за собственных классификаторов безопасности: они срабатывают на части задач в кибербезопасности, биологии и alignment. Если эти три области убрать, рейтинг меняется. Самое интересное: Gemini 4 Carbon лидирует в биологии, скорее всего, из-за более слабых ограничений. Так бенчмарк наглядно показывает, что безопасность имеет цену в процентных пунктах.
Как читать эти 12%
Сам по себе низкий балл означает только, что тест еще не насыщен и проживет дольше SWE-bench. Полезнее вывод из разбора ошибок в разработке ПО. 76% провалов фронтирных моделей пришлись на требования за пределами основной просьбы: сохранить существующее поведение, учесть интеграцию, закрыть пограничные случаи. Модели чаще пишут тесты, которые подтверждают их собственный код, и реже проверяют, совпадает ли он с тем, что просили.
Зеленые тесты мало что доказывают, смотреть надо на то, что агент мог молча сломать по соседству. Отдельный вопрос, на который SemiAnalysis пока не ответила, — будут ли задачи открыты для независимой проверки. Большая часть из них приватная, и через пару месяцев станет видно, примут ли лаборатории GDPx как общий ориентир или он останется метрикой одной аналитической компании.
А вы как думаете: нужны ли такие бенчмарки, если их авторы и судьи одна компания? Пишите в комментариях.
ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Запустить ИИ‑роутер →
* Признана в России экстремистской организацией, а ее деятельность запрещена на территории страны решением Тверского районного суда Москвы от 21 марта 2022 года.
Источник: habr.com