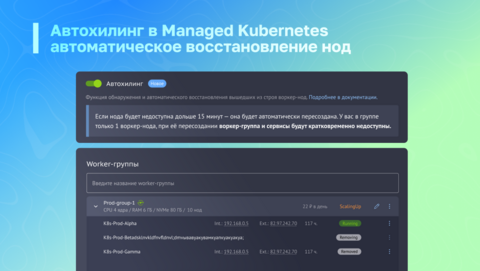
Мы добавили в Managed Kubernetes автохилинг (auto‑healing) worker‑нод. Теперь, если нода перестаёт отвечать, платформа сама это замечает и восстанавливает её, и вам не нужно ничего делать вручную.
Как это работает
Платформа следит за состоянием нод в worker‑группах, где включён автохилинг. Если одна из нод не отвечает больше 15 минут, восстановление идёт в два этапа:
-
Ноде присваивается статус NotReady, а её поды переносятся на другие ноды этой группы.
-
Неисправная нода удаляется, и вместо неё создаётся новая с той же конфигурацией. В группе снова становится столько нод, сколько задано в настройках.
Автохилинг включается отдельно для каждой worker‑группы. Его можно настроить только для тех групп, где автоматическое восстановление действительно нужно, а остальные оставить под ручным управлением.
Ограничения
-
Автохилинг срабатывает, только если из строя вышла одна нода. Если отказали две ноды или больше, их нужно восстанавливать вручную.
-
При замене ноды всё содержимое её локального диска удаляется без возможности восстановления. Важные данные лучше хранить вне локальных дисков нод, например в Persistent Volumes или во внешних хранилищах.
-
Чтобы приложения продолжали работать, пока нода заменяется, в группе должно быть не меньше двух нод.
Как включить
Автохилинг включается в настройках worker‑группы кластера.
Будем рады ответить на ваши вопросы в комментариях или в нашем Telegram‑чате.
Источник: habr.com