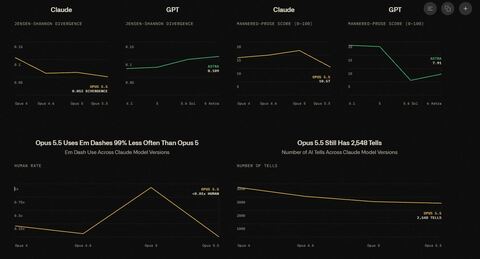
Новое исследование маркетинговой фирмы Graphite изучило привычки письма передовых моделей, выявив любимые слова и фразы каждой из них. Компания обнаружила 13 000 фраз, которые встречались в контенте ИИ как минимум в два раза чаще, чем в созданном людьми.
Авторы отметили успешность борьбы со склонностью к длинным тире, однако заявили, что ИИ всё ещё использует конструкции с противопоставлением, причём каждая версия модели демонстрирует свои уникальные особенности.
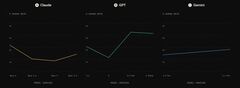
«Оказывается, модели Claude со временем приближаются к распределению слов, характерному для людей. А для моделей GPT — всё дальше», — рассказал TechCrunch главный специалист Graphite по искусственному интеллекту Грег Друк.
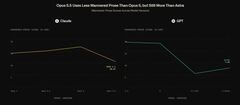
Изучение сгенерированного ИИ текста в больших масштабах потребовало тщательного планирования исследования. Graphite начала с корпуса из 10 000 статей, опубликованных до выпуска ChatGPT, который служил контрольной группой для анализа созданного людьми текста. Затем исследователи попросили разные модели ИИ переписать статьи на основе аннотаций, надеясь максимально исключить предвзятость источника. С помощью сопоставления образцов от людей и каждой модели они смогли сравнить, как часто определённые слова и фразы появлялись в текстах, сгенерированных ИИ, а также более общие закономерности в построении предложений.
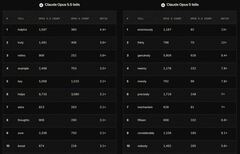
Согласно результатам Graphite, наиболее характерным признаком Claude Opus 5.5 является слово «надёжный», которое встречается в 23 раза чаще, чем в человеческих примерах. Хотя Opus 5.5 теперь избегает конструкции предложений «это не X, это Y», он по‑прежнему склонен говорить, что что‑то «больше, чем X, это Y». Также модель любит объяснять, почему что‑то важно, используя фразу «это важно» в 116 раз чаще, чем в человеческом тексте, в то время как фраза «почему X важно» встречается в 92 раза чаще.
У Astra от OpenAI другой набор признаков. Эта модель любит описывать «другое измерение» того, о чем она говорит, и склонна уклоняться от прямого ответа, говоря, что действие «может обеспечить» определённую выгоду. Самый главный признак — это то, что Graphite называет «корректирующей формулировкой», когда тема определяется как «не просто X» или предлагается в качестве альтернативы, «вместо того чтобы полагаться на X». Согласно исследованиям Graphite, такие конструкции встречались более чем в 100 раз чаще в процессе генерации текста Astra, чем в человеческом письме.
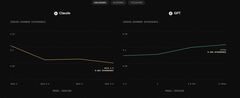
Примечательно, что все передовые лаборатории, похоже, отреагировали на идею о том, что модели чрезмерно используют длинные тире. В образцах Graphite Opus 5.5 использовал этот знак препинания на 99% реже, чем Opus 5. Astra теперь использует его на 88% реже, чем человеческие образцы, в то время как Gemini 3.1 Pro почти полностью исключил длинные тире из текста.
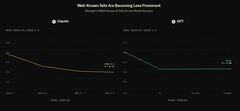
Хотя отдельные признаки меняются, Graphite утверждает, что общее число в основном остается стабильным. «Им удаётся устранить самые известные признаки, но появляются и другие. И у каждой версии модели свои особенности», — сказал Друк.
В релизе Opus 5.5 компания Anthropic хвасталась тем, что модель «общается естественнее, чем предыдущие», заявив, что первые пользователи «нашли её текст более ясным и понятным». OpenAI делала аналогичные заявления при выпуске версий Sol и Luna на основе GPT-6, говоря, что пользователи могут «ожидать большей ясности, меньшего количества жаргона и странных оборотов речи».
Но Друк скептически относится к тому, насколько лаборатории могут полностью исключить характерные конструкции или фразы. «Моя общая гипотеза заключается в том, что лаборатории менее способны контролировать некоторые из этих вещей, чем можно было бы ожидать. Это гигантские модели с миллиардами параметров. У них есть конечное число тестов, которые можно провести, и некоторые вещи всё же проскальзывают», — заключил он.
Между тем эксперты стали замечать, что ИИ‑модели начинают общаться на не вполне понятном наречии. Он описывают как «смесь „Поминок по Финнегану“ Джойса и техжаргона». ИИ‑модели крупных разработчиков стали создавать фразы, сокращения и значения слов, которым их никто не учил. Эксперты отмечают, что из‑за этого непонятного языка ИИ сложнее контролировать, а значит, возникают новые риски при его использовании.
Источник: habr.com