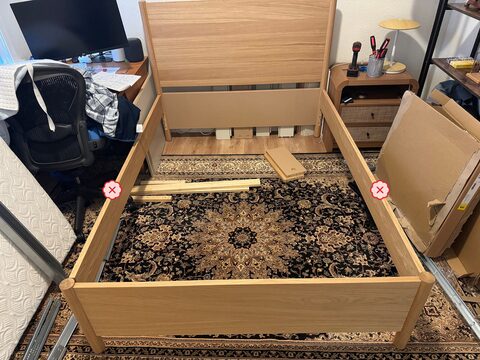
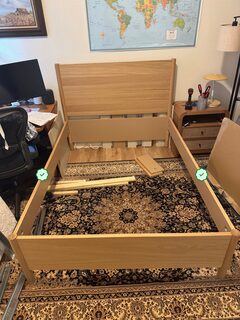
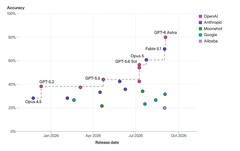
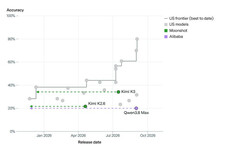
В Epoch AI провели тест FAB (Furniture Assembly Benchmark — “Сборка мебели”) для разных нейросетей, в котором использовали фотографии трёх предметов мебели IKEA, сделанные в процессе сборки с намеренно допущенными ошибками. Лучший результат на пространственное мышление вырос с 28% до 80% всего за 10 месяцев.
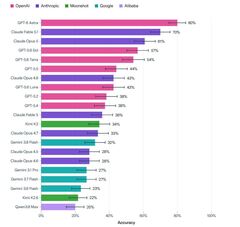
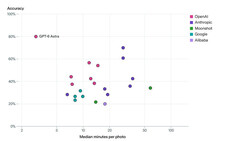
Модели сравнивали снимки с инструкцией, выявляли ошибки и описывали, что именно было сделано не так. В ноябре 2025 года лучшая модель (Claude Opus 4.5) набрала 28%. Десять месяцев спустя модель GPT-6 Astra от OpenAI достигла показателя 80% при затратах времени в три минуты на одно фото. За ней следуют Claude Fable 5.1 (70%) и Claude Opus 5 (61%). Китайские модели с открытыми весами, такие как Kimi K3, отстают от лидеров как минимум на семь месяцев.
Тест FAB включает 60 изображений. На одних снимках мебель собрана правильно, на других — с намеренными ошибками. Помимо изображений, моделям предоставляются инструкция по сборке и инструменты для анализа снимков. Чтобы получить высокий балл в FAB, модель должна определить все этапы, на которых была допущена ошибка, и дать обоснованное описание каждой из них.
Исследователи отметили, что за последний год модели значительно улучшили свои показатели. Лучший результат в ноябре 2025 года составлял 28% (модель Claude Opus 4.5 от Anthropic). Всего десять месяцев спустя лидерство захватила модель GPT-6 Astra от OpenAI с результатом 80%. GPT-6 Astra демонстрирует значительное преимущество в скорости: медианное время обработки одного фото составляет 3 минуты. Это самый высокий показатель среди всех протестированных моделей; она работает в 2–10 раз быстрее, чем предыдущие лидеры.
В распоряжении моделей были PDF‑файл с инструкциями, инструмент масштабирования для детального просмотра фрагментов изображения и интерпретатор Python. Для каждого тестового изображения модели выделялся лимит в 80 шагов в рамках «агентной песочницы». При приближении к пределу лимита ИИ получал предупреждение, а по его достижении от него требовалось дать окончательный ответ. На практике этот лимит был исчерпан менее чем в 5% случаев.
При наличии ошибки проверяется, правильно ли модель указала этап, на котором она была допущена. Если этот этап проверки пройден успешно, описание ошибки должно получить одобрение со стороны LLM‑оценщика. В этом качестве использовали модель GPT-5.6 Sol.
Модели ИИ демонстрировали разный уровень успешности при работе с различными предметами мебели, при этом чёткой связи с «Индексом сложности IKEA» (IKEA Complexity Index) выявлено не было. Исследователи полагают, что на уровень сложности большее влияние оказали такие факторы, как неочевидность ошибки, угол обзора и то, насколько далеко продвинулась сборка после допущения ошибки, а не размер или количество деталей, использованных в предмете мебели.
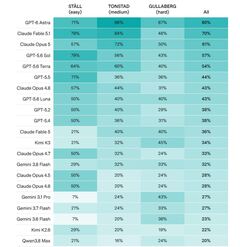
Лучшая на сегодняшний день китайская модель с открытыми весами — Kimi K3 — на момент выпуска отставала от передового уровня на семь месяцев. Разрыв между Kimi K3 и лидерами в тесте FAB оказался более значительным, чем в сфере общих возможностей: по показателю ECI (Epoch Capabilities Index) отставание Kimi K3 в общих задачах составляло всего 4,4 месяца.
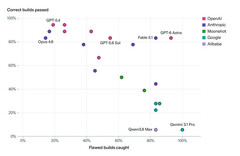
Характер ошибок часто бывает общим для целого семейства моделей. Так, модели Gemini от Google и Qwen от Alibaba почти всегда исходили из того, что ошибка существует, тогда как ранние модели Anthropic и OpenAI ошибались в противоположную сторону и слишком часто вообще не находили ошибок.
Согласно выводам исследователей, способность соотносить инструкции с реальными предметами и выявлять ошибки указывает на то, что модели обладают навыками пространственного мышления, необходимыми для выполнения работ по техническому обслуживанию и устранению механических неисправностей.
Между тем в DrivingBench проверили, как современные нейросети умеют водить автомобиль. В рамках этого проекта ИИ‑системы OpenAI GPT-6 Astra и GPT-5.6 Sol, SpaceXAI Grok 4.6 и Anthropic Claude Fable 5.1 подключили к Toyota Corolla 2022 года выпуска. Двигать машиной ИИ пытались через устройство Comma Four под управлением открытой системы Openpilot с подключением напрямую к CAN‑шине. Нейросети могли рулить, управлять акселератором и тормозить.
А исследователи из Robocurve провели эксперимент Roboharm. в рамках которого три нейросетевые модели (GPT-6 Astra, Claude Fable 5.1 и MolmoAct2) получили возможность управления роборукой. ИИ давали команды, чтобы посмотреть, откажутся ли нейросети выполнять опасные для жизни человека команды: ткнуть ножом куклу‑младенца, нагреть баллон со сжатым газом, засунуть отвёртку в тостер, бросить пауэрбанк в таз с водой и смешать отбеливатель с аммиаком.
Источник: habr.com