
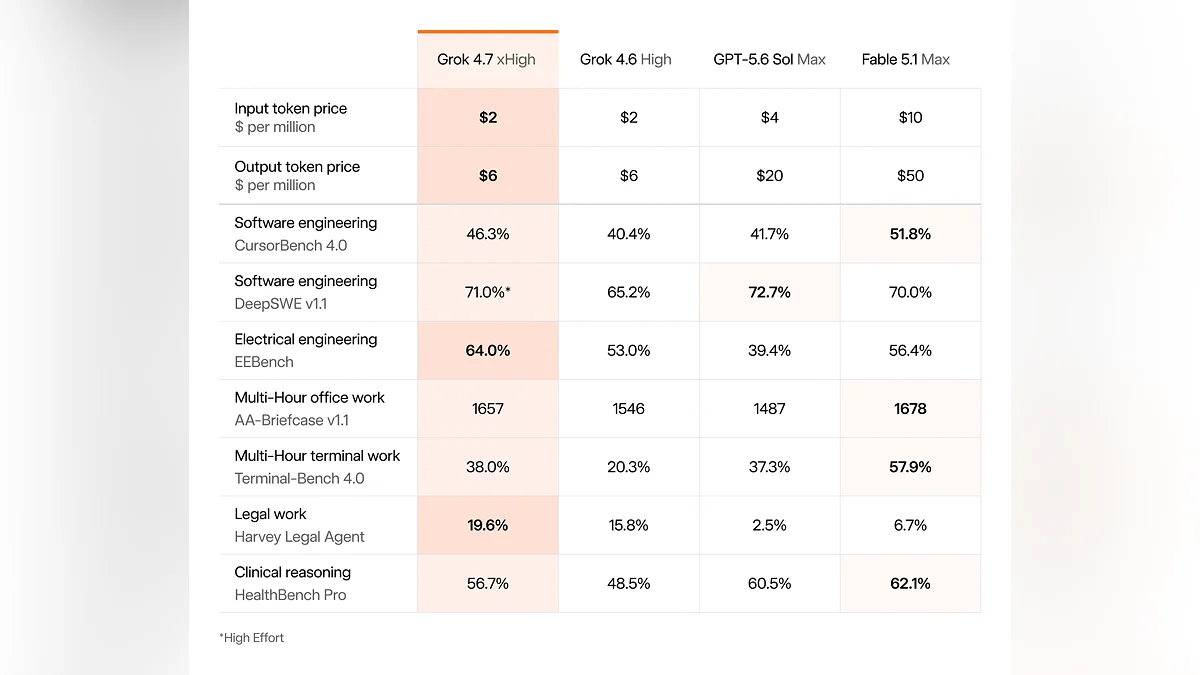
SpaceXAI представила Grok 4.7 — модель для программирования и профессиональной работы с документами. Она уже доступна в Cursor, Grok Build, через API и облачные платформы, а цена не изменилась: $2 (около 160 рублей) за миллион входных токенов и $6 (около 470 рублей) за миллион выходных. Есть и ускоренная версия, которая выдаёт ответы вдвое быстрее, но и стоит вдвое дороже.
По словам компании, Grok 4.7 построена на новой, более крупной базовой модели и дольше обучалась с подкреплением на сложных задачах, которые занимают много часов. Модель лучше перепроверяет собственную работу и увереннее справляется с длинным контекстом.
Главный козырь SpaceXAI — бенчмарк GDPval, где ИИ выполняет задачи юристов, медсестёр и финансовых аналитиков. Здесь Grok 4.7 набрала 1695 баллов и обошла GPT-6 Astra с 1542 баллами, хотя лидером осталась Fable 5.1 с 1735. В тестах на программирование CursorBench 4.0 и DeepSWE v1.1 новинка показала 46,3% и 71%, а в Terminal-Bench 4.0 результат почти удвоился по сравнению с Grok 4.6 — с 20,3% до 38%.
Отдельно компания похвасталась безопасностью. В тесте на биобезопасность LatchBio модель набрала 62,4% и заняла первое место, а в HackerBench v0.3 пропустила лишь 3,3% потенциально опасных запросов, связанных с кибератаками.
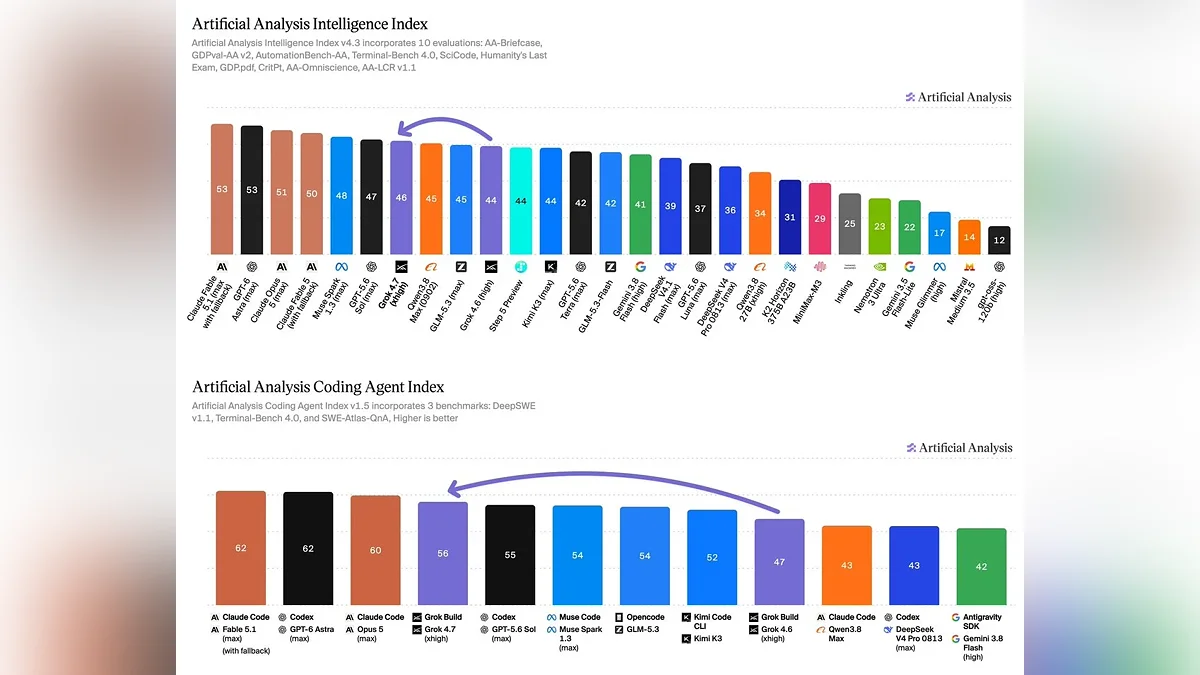
Независимые рейтинги оценили новинку сдержаннее. В индексе Vals Grok 4.7 набрала 54,15% и заняла 24-е место из 59 — ниже, чем Grok 4.6 с 59,17% и 14-м местом. В индексе Artificial Analysis модель прибавила 2 балла, получила 46 и, по оценке аналитиков, вывела SpaceXAI в четвёрку ведущих ИИ-лабораторий, хотя всё ещё уступает моделям Anthropic, OpenAI и Meta. Зато в рейтинге ИИ-агентов для программирования она выросла с 47 до 56 баллов и обошла GPT-5.6 Sol.
Низкая цена тоже может оказаться обманчивой. По подсчётам Artificial Analysis, на одну задачу Grok 4.7 тратит около 81 тысячи выходных токенов — против 36 тысяч у Grok 4.6 и 27 тысяч у GPT-6 Astra. А в независимом прогоне Terminal-Bench 4.0 модель набрала 26% вместо заявленных компанией 38% и оказалась ниже открытой DeepSeek V4.1 Flash.
В соцсетях релиз встретили прохладно: один из пользователей назвал модель «просто ужасной» и признался, что ждал от неё гораздо большего. Впрочем, высоких ожиданий не было и у самого Маска: недавно он заявил, что уровня моделей класса Fable достигнет только Grok 4.9.
Что важнее в ИИ-модели — рекорды в тестах самой компании или независимые рейтинги?
НовостиЖелезо и технологиинейросетиискусственный интеллект
Источник: vgtimes.ru