
15 сентября Google представила две нативные speech-to-speech модели, Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Первая заточена под масштаб и цену, вторая — под многошаговые задачи с рассуждением прямо в диалоге.
Интереснее баллов то, что голосовые агенты наконец получили признаки продакшен-продукта. Асинхронные вызовы функций, предсказуемая цена, интеграции с тем, на чем такие системы реально собирают.
Хочу напомнить, как это делалось раньше. Голосовой бот — конвейер из трех сервисов. Распознавание речи, языковая модель и синтез. Задержки складываются, а вместе с текстом может потеряться все остальное — интонация, скорость речи, эмоция, шум на фоне. Модель получает расшифровку и не знает, что собеседник злится. Проблемным было и перебивание. Пока распознавание не закрыло фразу, система вообще не понимает, что ее прервали. Нативная speech-to-speech модель работает с аудио напрямую и снимает оба ограничения разом.
Цифры
Extended Thinking занял первое место в Speech to Speech Quality Index от Artificial Analysis с результатом 82,6. На агентных задачах τ-Voice у него 68,6%, на банковском срезе τ-Voice-banking от Sierra — 35,1%, на Big Bench Audio — 97,7%.
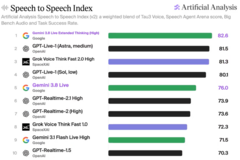 Источник.
Бенчмарки звучат абстрактно, поэтому переведу. Разговаривать и рассуждать вслух модель научилась отлично. А вот довести клиента до конца банковской процедуры, где надо проверить данные, удержать состояние и не ошибиться в сумме, у нее получается в трети случаев.
Обычная Live встала второй в Speech Agent Arena, и здесь акцент сделан на стоимости. Аудио на входе стоит 0,005 $ за минуту, на выходе — 0,018 $. В пересчете на токены получается примерно 3 $ за миллион входных и $12 за миллион выходных.
Что появилось технически
Асинхронный вызов функций — самое практичное изменение. Инструмент выполняется в фоне, пока аудиопоток продолжается, и агент больше не замолкает, уходя в API. Extended Thinking вдобавок проговаривает прогресс вслух, пока думает. В голосовом интерфейсе это заменяет анимированный значок загрузки, который обычно крутится на экране, пока программа выполняет какую-то задачу.
Из остального — обработка визуального контекста почти в реальном времени и 97 языков с переключением посреди разговора. Отдельно Google поработала над точностью распознавания буквенно-цифровых последовательностей, номеров заказов, кодов, счетов. Аудио на выходе помечается водяным знаком SynthID.
Где это живет
Модели доступны через Gemini API и Google AI Studio, в Gemini Enterprise пока приватное превью. Для пользователей обычная Live уехала в Search Live, Extended Thinking — в Gemini Live и Workspace на тарифах AI Pro и Ultra. Из интеграций заявлены LiveKit, Pipecat, LangChain, Vercel, Agora. Из партнерских кейсов — Salesforce, ServiceNow, Genspark и Lumeris.
В релизе не подсвечена одна оговорка. Self-hosting не предусмотрен, обе модели работают только как хостируемый сервис.
Что это значит
Цену полезно перевести в понятные единицы. Час разговора, где модель говорит примерно половину времени, обходится в доллар с небольшим, без учета вызовов инструментов. Час работы живого оператора почти в любой юрисдикции стоит на порядок дороже.
При таких цифрах экономика сценария упирается уже в интеграции с CRM и телефонией, а главное — в цену ошибки. Поэтому 35,1% на банковском бенчмарке для того, кто планирует внедрить, важнее, чем первое место в общем рейтинге.
Ограничение тоже понятное. Голос — персональные данные в самой неудобной форме. Голосовой отпечаток, фоновые звуки, случайные фразы третьих лиц рядом. Отсутствие self-hosted варианта закрывает весь класс сценариев, где аудио не имеет права покидать периметр, а в медицине, финансах и госсекторе таких сценариев довольно много.
Кто-нибудь уже собирал голосового агента на нативной speech-to-speech модели? Пишите в комментарии.
ИИ‑роутер — доступ к 300+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Запустить ИИ‑роутер →
Источник: habr.com