
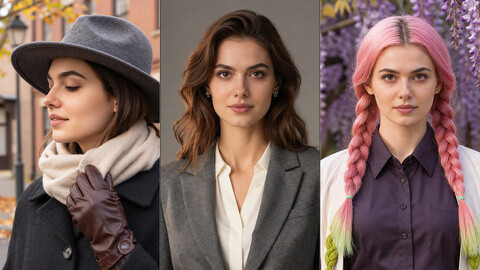
 Ада (Аделаида, нейроперсонаж) — три образа.
В прошлых статьях я рассказывал о локальной генерации изображений, работе моделей с русским текстом и сравнивал их скорость на домашней видеокарте. Теперь добавил недостающий функционал — обучение LoRA на реальных снимках. Тут уточню: в другом своём инструменте — Partcaster (генератор нейротреков) — я придерживался категоричного мнения, что LoRA там не нужны. Инструмент создан для доведения нейротреков, чтобы итоговый звук был похож на реальный: замена гитар и барабанов, эффект сбивки и гитарные провалы. А использование LoRA там я воспринимал как простое копирование чужого. Тут же, кмк, LoRA уместна. Мне хотелось добавить в приложение функционал для генерации фотосессий, подборки одежды и образов в стилисте и примерки реальной одежды с маркетплейсов или даже с обычных фото на смартфон.
Для этого я добавил в Imagecaster обучение LoRA человека и подмену лица, а стилист, который раньше работал только через MCP, теперь работает и в самом приложении, без подключения стороннего ИИ-клиента.
Для статьи создал Аду (Аделаиду) — вымышленного персонажа, на котором удобно показывать возможности приложения, не публикуя реальных людей. Сам же я проверял эту связку на себе и на жене. Фоток жены у меня вообще куча, которые сделаны на мою зеркалку Nikon D5600 (ниже про это чуть подробнее).
Как это устроено
LoRA — дополнительные обученные веса для выбранной модели (для каждой базовой модели нужна своя LoRA). В отличие от простой замены лица на готовом снимке, здесь сначала создаётся новый кадр: с нужной сценой, одеждой, позой и ракурсом. Но в моих экспериментах сама LoRA иногда делала лишь «слегка» похожего человека, поэтому отдельно пришлось включить замену лица.
Для обучения LoRA сервер использует ai-toolkit; генерация идёт через stable-diffusion.cpp. В примерах этой статьи я использую быструю Z-Image, но обучение не привязано только к ней: модель выбирается из поддерживаемых прилолением. При этом LoRA обучается под конкретную модель.
Если нужно примерить вещь с картинки, после генерации кадра подключается Klein: он переносит одежду с изображения. Если включена подмена лица, она выполняется уже после этой примерки. Это отдельные этапы:
-
LoRA создаёт человека в новой сцене,
-
Klein отвечает за вещь с фотографии,
-
а замена лица — за сходство лица.
Стилист в приложении позволяет выбрать человека, модель, стиль или рабочий процесс, выбрать одежду (если надо — это не обязательно), причёску, макияж, фон и позы, составить план и запустить съёмку. MCP даёт другой способ управлять той же системой: агент может предложить несколько образов и отправить кадры в очередь приложения. Про приватность заморачивался отдельно: даже если использовать «умный» ИИ (через Claude или Codex или подобное) исходные фото не попадают в историю: описание исходных фото выполняет локальная vision-модель, а MCP возвращает текст и номера результатов.
Как обучить LoRA: три способа
1. Указать папку с фотографиями
Самый прямой путь — собрать фотографии одного человека в отдельную папку. На странице «Люди» выбрать эту папку, модель для обучения, задать имя LoRA и имя человека, под которым он будет доступен в приложении, и запустить обучение. Поддерживаются JPEG, PNG и WebP; для обучения нужно от 10 до 100 фотографий.
Лучше собирать разные снимки: несколько ракурсов, выражений лица, условий освещения и одежды. Десяток почти одинаковых кадров не даёт того же разнообразия, что десять разных фотографий. Для этого способа нужно заранее отобрать снимки одного человека; групповые фотографии удобнее добавлять через набор, о котором ниже. Длительность обучения зависит от выбранного режима и модели.
2. Постепенно собрать набор в «Моих изображениях»
В приложении есть просмотр фото из файловой системы — «Мои изображения». Там можно выбрать фотографии и добавить их «В набор для обучения», указав человека. Наборы видны на странице «Люди» — там можно посмотреть состав, убрать неудачные снимки и запустить обучение.
В этот набор можно добавлять и групповые фотографии. Приложение ищет лица и сравнивает их с уже выбранным человеком. Если может определить нужного — выбирает его и подготавливает обрезку вокруг человека; если выбор неоднозначен, предлагает указать лицо вручную. Если лицо не найдено, слишком мелкое или размытое, об этом будет сообщение. Если человек не похож на того, чьи фото уже есть в наборе, приложение попросит подтверждение.
Главное удобство — не нужно сразу собирать большой набор фоток. Можно начать с десяти подходящих фотографий и быстрого обучения, посмотреть результат, а затем постепенно добавлять новые снимки и нажимать «Дообучить». Это продолжение обучения имеющейся LoRA на накопленном наборе: старые фото остаются, а новые используются чаще. Если нужно — можно переучить LoRA с нуля или вернуть предыдущую версию.
3. Поручить запуск обучения агенту через MCP
Тот же процесс можно начать из MCP-клиента. Например: «Обучи LoRA Ады по фотографиям из этой папки на Z-Image». Нужно указать папку на машине, где запущен MCP-сервер, и выбрать поддерживаемую модель. Агент может получить список доступных моделей, создать задание обучения и запустить его — или отложить запуск, чтобы не нагружать GPU сразу.
Что получилось
Для примеров использовал Z-Image с LoRA Ады: 8 шагов, Euler, CFG 1. Большинство кадров — 1024×1536; у горизонтального кадра размер 1536×1024. Подмена лица включена, но если лица нет в кадре, этот этап пропускается.
Фотосессия из приложения: осенний город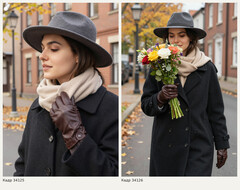 Слева направо: Кадр 34125 · 1024×1536 · seed 3742602377; Кадр 34126 · 1024×1536 · seed 1262145833.
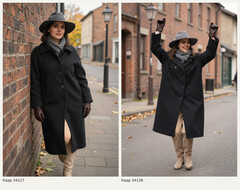 Слева направо: Кадр 34127 · 1024×1536 · seed 4044149147; Кадр 34128 · 1024×1536 · seed 27043358.Своё фото вещи: платье и жакет
Исходное фото содержит две вещи — платье и жакет, сфотканные быстро и не очень качественно на смартфон.
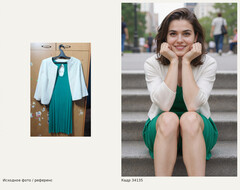 Слева направо: Исходное фото; Кадр 34135 · 1024×1536 · seed 1619770399.
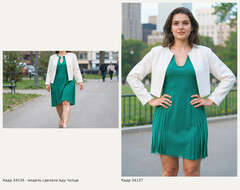 Слева направо: Кадр 34136 · 1536×1024 · seed 570355772 · подмена лица пропущена: лица нет в кадре · модель сделала Аду толще; Кадр 34137 · 1024×1536 · seed 576401647.Примерка в приложении: костюм медсестры
Взял случайное фото костюма медсестры с одного из маркетплейсов и запустил примерку в Стилисте через приложение.
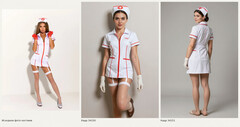 Слева направо: Исходное фото костюма; Кадр 34150 · 1024×1536 · seed 3008633269; Кадр 34151 · 1024×1536 · seed 927815940.
Примерка через MCP: косплей по аниме
В качестве примера взял двух персонажей из аниме «Клинок, рассекающий демонов». Здесь примерка запущена через MCP — в отличие от костюма медсестры, снятого кнопками приложения.
Косплей: розовые и зелёные косы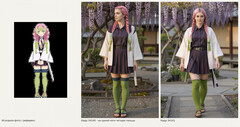 Слева направо: Исходное фото / референс; Кадр 34140 · 1024×1536 · seed 21112710 · на одной ноге четыре пальца; Кадр 34141 · 1024×1536 · seed 21112711.Косплей: кимоно
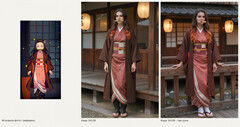 Слева направо: Исходное фото / референс; Кадр 34138 · 1024×1536 · seed 21112720; Кадр 34139 · 1024×1536 · seed 21112721 · три руки.
Агент сам предлагает образы
Для отдельной проверки дал агенту запрос:
Предложи интересные образы, причёску, макияж и одежду для Ады, сделай профессиональную фотосессию с несколькими образами.
Он предложил три серии. Ниже — фрагмент фактического ответа:
Для Ады предлагаю три образа. Узкие плечи подчеркнём жакетом и выразительным воротом, талию — поясом и посадкой одежды. Разные укладки, макияж и свет дадут каждому образу своё настроение.
Студийная редакционная съёмка: графитовый костюм с поясом, молочная блуза и мягкие волны. Собранный силуэт и спокойный макияж для выразительной деловой серии.
Городское кино: бордовый тренч поверх тёмного платья миди, гладкая низкая укладка и приглушённая ягодная помада. Вертикали одежды и вечерний свет создадут кинематографичное настроение.
Сад: платье миди шалфейного цвета с рукавами и поясом, свободно собранные волны и лёгкий макияж. Мягкие ткани и зелень дадут спокойную, воздушную серию.
В каждом образе — два вертикальных кадра: полный рост и поясной портрет.
Агент подготовил три вызова stylist_shoot, по два кадра в каждом. В первой студийной серии модель пропустила жакет. После проверки результата агент получил замечание и уточнил описание одежды. Его ответ:
В студийной серии не появился жакет. Уточняю этот образ: на Аде надет графитовый приталенный жакет с длинными рукавами и лацканами, застёгнутый на талии. Под ним виден ворот молочной блузы; брюки — из той же ткани, что и жакет. Переснимем полный рост и поясной кадр.
После повторной съёмки жакет появился. Показываю и новые кадры, и первые варианты ниже.
MCP-стилист: студия после уточнения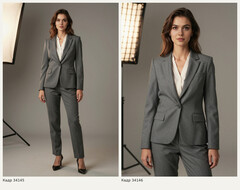 Слева направо: Кадр 34145 · 1024×1536 · seed 21112800; Кадр 34146 · 1024×1536 · seed 21112801.MCP-стилист: вечерний город
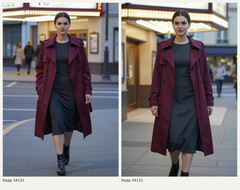 Слева направо: Кадр 34131 · 1024×1536 · seed 21112660; Кадр 34132 · 1024×1536 · seed 21112661.MCP-стилист: сад
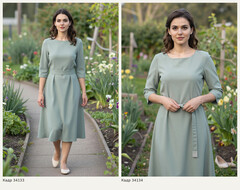 Слева направо: Кадр 34133 · 1024×1536 · seed 21112670; Кадр 34134 · 1024×1536 · seed 21112671.
Как выглядит Стилист в приложении
Это настоящие скриншоты интерфейса: план съёмки и результаты.
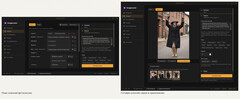 Слева направо: план осенней фотосессии; готовая осенняя серия в приложении.
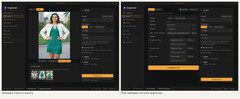 Слева направо: примерка платья и жакета; план примерки костюма медсестры.
Слишком идеальные фотографии — и что с этим делать
Одна из претензий к ИИ-фотографиям — они получаются слишком «правильными», а реальность «грязнее». Гладкая кожа, правильные черты лица, красивый свет. На примере Ады это отчасти справедливо: я не старался сделать её внешность особенной или необычной, поэтому получился довольно типичный образ с правильными чертами. Ада — вымышленный персонаж, и по ней не стоит судить, насколько интересно модель передаёт внешность реальных людей.
Для себя я обучал LoRA на своих фотографиях и фотографиях жены. Эти результаты мне нравятся больше: у реального человека есть свои особенности, и видеть их в новых образах интереснее, чем снимать придуманную модель. По моим ощущениям, узнаваемость получается хорошая. Сама LoRA может менять лицо от кадра к кадру, а замена лица помогает удерживать сходство.
При этом «красивые» фотографии, не слишком похожие на реальность, существовали задолго до генеративного ИИ. У меня есть Nikon D5600 и Samyang 135mm f/2.0. Объектив я первоначально покупал для астрофотографии — снимать ночное небо со штатива. Но оказалось, что людей он тоже снимает прекрасно. Правда, автофокуса у объектива нет, а отходить приходится больше чем на 10 метров 🙂
Ниже — два моих снимка на этот комплект. Оба сняты на 135 мм, f/2 и ISO 100: осенний — с выдержкой 1/1000, лесной — 1/1600. После съёмки была обычная подготовка фотографии в Photoshop: проявка NEF с сохранением в JPEG, коррекция яркости, цвета и геометрии. Я использую Photoshop и не считаю такую обработку чем-то, что делает фотографию ненастоящей.
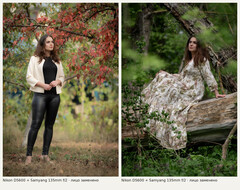 Два реальных снимка на Nikon D5600 и Samyang 135mm f/2.0, с обычной обработкой. Лицо заменено на лицо вымышленной Ады. Кстати, жакет, именно тот, что выше у Ады.
Суть в чём: в этих кадрах есть попытка добиться красивой фотографии, которая немного отличается от реальности. Как раз то, что почему-то ставят в упрёк ИИ.
А вот ошибки в анатомии и потеря деталей — вполне конкретные недостатки. В подборке я оставил заметные примеры и подписал их. В одном кадре модель сделала Аду толще и не показала лицо, поэтому подмена лица была пропущена. В другом на одной ноге получилось четыре пальца, ещё в одном — три руки. А, когда стилист через MCP делал один образ, он сам понял, что не хватает пиджака и «переснял» кадры. Это реальные результаты, а не только лучшие картинки, выбранные так, чтобы скрыть проблемы.
Можно делать много вариантов и сразу отбраковывать неудачные. Это не значит, что фотографии совсем бесплатны: оборудование, электричество и время тоже стоят денег. Но неудачная попытка не списывает оплаченные кредиты, как в облачном сервисе с оплатой за генерации. Для такой домашней фотостудии возможность спокойно экспериментировать и выбирать результат для меня важнее, чем обещание безошибочного первого кадра.
Где попробовать
Исходный код и сборки: Imagecaster и Imagecaster Server. Приложение и сервер можно запустить на одном компьютере или разнести по домашней сети.
Источник: habr.com