
Рядом с рабочим монитором у меня долго стоял ноутбук с открытым окном агентов. Раз в двадцать–тридцать минут я ловил себя на том, что опять туда кошусь: не встал ли кто-нибудь на вопросе, не пошёл ли крутиться по кругу. Я не решал так делать осознанно, привычка выработалась сама, как нервный тик. Пока агент был один, всё выглядело просто: дал задачу, обсудил, посмотрел код. Когда параллельных сессий стало несколько — в разных ветках или разных репозиториях — код они по-прежнему писали быстро, а вот переносить результат от планирования к реализации, пересказывать контекст и объяснять ревьюеру, что проверять, приходилось мне руками. Агенты сняли с меня набор кода и незаметно превратили в диспетчера: этому ответил, за тем присмотрел, этот вообще встал посередине и ждёт.
А если просто отпустить их в свободное плавание без понятных ограничений, случаются совсем комичные вещи. Однажды я заглянул в задачу, которая висела открытой уже шесть часов, а рецензент там спокойно шёл на четырнадцатый круг ревью. Я посмотрел на это и подумал: «Вот молодец, четырнадцатый круг, уж теперь-то точно всё получится», — остановил процесс и отдал задачу архитектору, чтобы сначала разобраться, что мы вообще чиним. Если каждый новый прогон находит свежие замечания, значит, сама постановка сломана и надо сделать шаг назад.
Тут я сам же первым и поймал себя на противоречии. Мы годами боремся с передачами в обычной разработке: продакт описал задачу, инженер уточнил и сделал, тестировщик проверил, продакт посмотрел — и оказалось, что нужно было другое. Пока задача ходит по кругу, на ожидание и восстановление контекста уходит больше времени, чем на саму работу; я называл это налогом на передачу работы в статье про роль продуктового инженера. И тут я собираюсь выстроить из агентов ровно такой же конвейер из аналитика, разработчика и ревьюера. Если гнать каждую задачу через все роли и самому таскать между ними контекст, то это действительно шаг назад — просто ждать теперь приходится собственных ботов вместо коллег.
Разница появляется в тот момент, когда роли разделяются только там, где от этого есть измеримая польза, а контекст между ними ходит без моего участия. Отвечать за итоговый код всё равно мне, но исполнителей может быть несколько. Например, проверку имеет смысл отделять от реализации, когда ошибка дорого стоит: в разборе агентных схем от Anthropic рядом с простыми цепочками описан как раз такой паттерн evaluator-optimizer, где один вызов модели проверяет работу другого.
Зачем второй агент, если контекст уже миллион токенов
Казалось бы, при окне в миллион токенов можно обойтись одним агентом: пусть допишет задачу и в том же диалоге сам себя проверит. Представьте обычную историю — список записей с фильтром по статусу. Где-то в начале длинной сессии агент решил, что без фильтра показываются только активные записи, написал код и тесты под это допущение, и всё у него зелёное. Если отдать результат на проверку отдельному ревьюеру, который получает только критерий «без фильтра показывать все записи» и diff, он про забытое допущение из старой переписки просто не знает и сразу видит расхождение.
Длинное окно само по себе от этого не спасает, потому что модель в нём начинает терять детали. В исследовании «Lost in the Middle» Nelson Liu и соавторов на тесте с двадцатью документами GPT-3.5-Turbo отвечала правильно в 75,8% случаев, когда нужный документ лежал первым, и в 53,8%, когда он оказывался в середине списка. К тому же чем больше нового текста на входе, тем дольше ждать первого токена и тем дороже каждый следующий шаг. По моим ощущениям, когда контекст сильно разрастается, модель начинает забывать договорённости, застревать на своей версии событий и ходить по кругу.
Попросить того же агента просто «перепроверить» тоже работает слабее, чем ожидаешь. В работе Jie Huang и соавторов GPT-4 на выборке из 200 задач GSM8K после самопроверки без внешнего сигнала опустился с 95,5% до 91,5% — модель исправила часть собственных правильных ответов. Поэтому на практике я привязываю проверку либо к воспроизводимому тесту, либо к отдельному ревьюеру, который смотрит на diff и критерии приёмки с пустым контекстом, без всей истории наших обсуждений.
На практике второй агент нужен в трёх разных случаях: когда нужен свежий взгляд на ревью (в идеале другой моделью и другого поставщика), когда есть независимые подзадачи, которые можно развести по разным worktree без общего изменяемого состояния, и когда хочется развести модели по цене и качеству — например, код пишет модель подешевле, а ревью делает более дорогая. С параллельной работой важно не обмануться: если пустить двоих агентов в один фронтенд, они в разных worktree наплодят конфликтов при слиянии, а в одной ветке просто передерутся. И ни один из этих сценариев сам по себе не требует оркестратора — открыть вторую сессию и скопировать туда файл можно руками. Команда с автоматизацией нужна в тот момент, когда эти ручные передачи становятся ежедневной рутиной и хочется, чтобы они шли без тебя.
Как я разбирался в инструментах и почему половина отвалилась
Инструментов под оркестрацию агентов сейчас больше, чем физически успеваешь открывать. В каталоге awesome-agent-orchestrators на 19 ноября было 350 живых проектов и ещё 19 в разделе Resting, причём за десять дней с 8 по 18 ноября туда добавили 36 новых пунктов. Мне почти каждый день присылают очередную новинку, и ловишь себя на мысли: «Да когда ж вы уже закончитесь?» Большинство из того, что я открывал, сделано наспех и сыро, так что сравнивать обещания на лендингах и в README смысла нет.
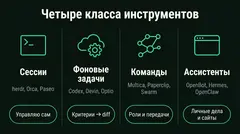
Чтобы не тонуть в названиях, я стал делить инструменты по тому, чем именно собираюсь управлять: сессиями (как в Paseo), фоновыми задачами с diff на выходе (облачный Codex, Devin), командами с ролями и передачами (Multica, Paperclip, Agent Swarm) или личными ассистентами (Hermes Agent, OpenBot). Команда тут не выше сессий, это просто разные задачи, да и границы между классами довольно размытые. Но такой взгляд сразу помогает отсечь лишнее.
Дальше я проверяю любой инструмент на одном живом сценарии: подключил свой рантайм, поставил задачу, дождался уведомления о блокере там, где его жду, и принял результат. Недавно решил попробовать Agent Swarm — мастер настройки бодро сообщил, что всё проверено, а первая же задача упала с ошибкой шлюза. Я полистал логи и так и не понял, где ошибся и что именно настроил криво. В Multica и OpenBot у меня всё завелось с первого раза. Оказалось, что даже когда ты давно возишься с агентами, понятный интерфейс и предсказуемое поведение перевешивают длинный список фич в документации.
Команда в Multica: где она помогает, а где ломается
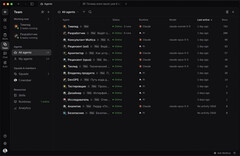
В Multica я сначала насоздавал четырнадцать агентов, просто чтобы разобраться, как устроен инструмент, — звучит так, будто я уже директор небольшого отдела. На практике столько ролей в постоянной работе не нужно, часть из них я заводил ради эксперимента. К 19 ноября накопительный счётчик на доске показывал 763 запуска у тимлида и 208 у разработчика. Такой разрыв получается из-за роли: тимлид у меня работает единой входной точкой, он знает, где какой проект и кто чем занят, забирает результат после исполнителя и решает, куда отправлять задачу дальше. Плюс поначалу я сам постоянно писал ему «как дела?», пока осваивался. Рядом работают два рецензента на разных рантаймах: один через Claude (claude-opus-5-5, 48 запусков), второй через Pi (83 запуска). Задачи живут на настраиваемой канбан-доске, а когда нужно моё решение, тимлид упоминает меня, и вопрос падает в Inbox. Однажды открыл экран днём, а там уже 29 минут висела такая эскалация — я про неё даже не знал, потому что перестал сидеть и караулить вкладку.
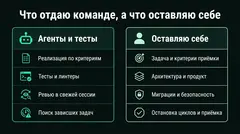
Прежде чем агент начнёт что-то делать, я прошу его пересказать задачу своими словами — точно так же, как у джуна: «Как ты понял задачу?» Часто уже по пересказу видно, что он собирается решать что-то другое, и проще поправить его сразу, чем потом выкидывать готовую ветку. Всё, что можно проверить тестами, линтером и понятным списком критериев, команда крутит сама, а миграции данных, безопасность и продуктовые решения я оставляю себе.
При этом даже с тестами и критериями за агентами всё равно нужен здравый смысл на приёмке. Кроме того случая с четырнадцатью кругами ревью, в другой раз агент пришёл ко мне с идеей поднять таймаут на мутационные тесты: мол, тесты идут 180 минут, надо таймер повысить. Я ему ответил прямо: «Ты офигел, 180 минут на тесты, переделывай тест». И он тут же спохватился: «Ой, и правда, как это я не заметил». Пока носом не ткнёшь, он такую нелепость не видит, поэтому финальная приёмка остаётся за мной.
Киф Моррис, консультант Thoughtworks, в статье на сайте Мартина Фаулера называет такой режим «человек над циклом» (on the loop): человек правит не каждую строчку кода за агентом, а саму обвязку — спецификации, проверки и правила работы. Именно так я и стараюсь действовать: когда результат получается плохим, я иду чинить инструкции, критерии или процесс. А на случай, если агент забудет задать вопрос или задачи тихо встанут после сбоя, у меня крутится регулярная проверка на недорогой модели DeepSeek Flash. Она со свежим контекстом проходит по активным задачам, ищет архитектурные проблемы и зависшие тесты и пишет мне, если что-то пошло не так. Раз в сутки приходит сводка по всем проектам — что сделано и какие решения приняты, а при желании с командой можно переписываться прямо в Telegram.
Для задач вне бэклога разработки я отдельно держу личного ассистента — это другой класс инструментов. Multica отвечает на вопрос, что происходит с кодом и доской, а ассистент (долго я сидел на Hermes Agent от Nous Research, сейчас переехал на OpenBot) закрывает всё, где нужны память между сессиями, встроенный браузер, расписание и доступ к терминалу на своей машине. Смешивать это с оркестратором разработки не стоит: разные контуры, разные права и разные риски.
Деньги, безопасность и привязка к поставщику
На экране расходов в Multica я увидел цифру, которая меня самого удивила: около $1 000 за неделю. На самом деле тысячу я никому не должен — когда делаешь запрос, часть вендоров возвращает цену, и система прикидывает, сколько вышло бы при оплате через API. Фактически я платил подписками: Claude за $100 и OpenCode Go, откуда беру DeepSeek, а неделя вышла пиковой, потому что я активно гонял агентов сразу на нескольких проектах. Но смотреть всё равно стоит именно на расход токенов, потому что подписка маскирует реальный аппетит оркестратора: человек, который попробовал Paperclip сразу после выхода, рассказал, что токены у него улетели моментально.
С безопасностью история ещё серьёзнее. Плагины в таких решениях часто работают вне песочницы с теми же правами, что у вашего пользователя, а проверить весь исходный код чужих интеграций физически невозможно. На корпоративные устройства без проверки я бы всё это точно не ставил. Исходники у Multica и OpenBot открыты — при желании их можно форкнуть, вычитать, провести аудит, собрать свою версию и согласовать для работы. Но до установки стоит заглянуть и в лицензии: у Multica своя лицензия на основе Apache-2.0, которая разрешает внутреннее использование в одной организации, но запрещает хостить сервис для третьих лиц или встраивать в коммерческий продукт без отдельной лицензии; у OpenBot лицензия PolyForm Noncommercial, которая коммерческое использование не разрешает.
Зачем вообще возиться со своими серверами, если у крупных вендоров уже есть OpenAI dots и Claude Managed Agents? Мне тот же dots нравится: персональный постоянный агент в ChatGPT, Slack и Teams со своим облачным компьютером и коннекторами, но модели он подбирает сам, и подключить туда чужого поставщика вроде DeepSeek в анонсе нельзя. У Claude Managed Agents среду запуска можно развернуть у себя и направить инференс через Amazon Bedrock, Google Cloud, Microsoft Foundry или свой шлюз, но модели там всё равно привязаны к идентификаторам Claude. Если завтра одного провайдера заблокируют или изменятся условия, перенести оттуда задачи, роли, память и правила приёмки будет больно. Я хочу менять модель и поставщика, не пересобирая заново всю команду и рабочий процесс, и открытые инструменты, которые живут на моём сервере, эту свободу оставляют у меня.
Что в итоге прижилось
Сейчас у меня сложилась связка из трёх инструментов: Multica для разработки, OpenBot для личных дел и всего, что требует браузера, и Paseo про запас, когда нужно просто поработать с несколькими сессиями. Первые два ещё сыроваты и иногда работают странно, но с ними мне удобно и всё завелось без долгой возни.
Если пробовать такое у себя, я бы начинал с одной задачи, одного исполнителя и одного проверяемого правила приёмки, а второго агента добавлял, когда понятно, зачем именно он нужен. Команда и оркестратор нужны далеко не всегда: они требуют времени на настройку и тратят много токенов, поэтому оправдывают себя, когда ручные передачи между сессиями реально стали узким местом.
Для себя я главный результат почувствовал по одной бытовой мелочи: окно с агентами больше не висит постоянно рядом с рабочим монитором. Я заглядываю туда утром и вечером, днём приходят уведомления, только если без меня никак, а раз в сутки падает сводка. И теперь я стараюсь спрашивать себя не сколько агентов у меня работает, а сколько времени и внимания я себе вернул.
Источники
-
Продуктовый инженер — это не продакт, который научился кодить, 21 сентября 2026 — «И вместе с ним лучше виден налог на передачу работы. Продакт описывает задачу. Инженер уточняет требования и реализует их. Тестировщик проверяет результат, продакт смотрит — и выясняется, что получилось не то.»
-
Building effective agents, Anthropic, 19 декабря 2024 — «In the evaluator-optimizer workflow, one LLM call generates a response while another provides evaluation and feedback in a loop.»
-
Nelson F. Liu и соавторы, Lost in the Middle: How Language Models Use Long Contexts, arXiv:2307.03172, таблица 6 («20 Total Retrieved Documents»): GPT-3.5-Turbo, Index 0 — 75.8%, Index 9 — 53.8%.
-
Latency optimization, OpenAI — «A long prompt can delay the first token, especially when much of the input is new.»
-
Jie Huang и соавторы, Large Language Models Cannot Self-Correct Reasoning Yet, arXiv:2310.01798v2 (ICLR 2024), таблица 3, GPT-4, выборка 200 задач GSM8K: «Standard Prompting» — 95,5%, «Self-Correct (round 1)» — 91,5%.
-
README awesome-agent-orchestrators, коммит
36ac525от 18 ноября 2026, 06:12 UTC: 350 пунктов вне раздела Resting и 19 в разделе Resting; между коммитами1fcc1afи36ac525добавлено 36 новых пунктов. -
Kief Morris, Humans and Agents in Software Engineering Loops, martinfowler.com, 4 марта 2026 — «Let’s call this “on the loop.”» И: «The “on the loop” way is to change the harness that produced the artefact so it produces the results we want.»
-
Multica (LICENSE v0.10.0) — «you may not use the Multica source code to provide a hosted service to third parties, or embed Multica as a component of a product or service that is sold, licensed, or otherwise commercially distributed to third parties.» OpenBot (LICENSE) — «Any noncommercial purpose is a permitted purpose.»
-
Introducing dots, OpenAI, 29 сентября 2026 — «Your dot is always within reach, whether it is through ChatGPT, Slack, or Teams.» И: «Your dot can draw on different models for different parts of its work.»
-
Self-hosted inference, Anthropic — «Agents name models by their Claude API IDs, such as claude-opus-5-5.» Провайдеры в таблице: Claude API, Amazon Bedrock, Claude Models on Google Cloud, Microsoft Foundry, свой gateway.
Впервые опубликовано в моём блоге: shady2k.ru.
Источник: habr.com