
Мне 22 года, я AI/ML-инженер и исследователь: закончил бакалавриат по прикладной информатике и защите информации в СГЭУ (2022–2026), а сейчас учусь в магистратуре Самарского университета им. Королёва (Аэрокос) на программе «Системы искусственного интеллекта». До этого успел поработать и руками (декоратором — собирал каркасы из бруса на площадках), и сисадмином 1С. Параллельно пишу софт для параметрического проектирования каркасов (Deckor), веду научку по гибридным нейросетям в медицине (НИР) и строю локальную инфраструктуру для мультиагентных систем.
В какой-то момент передо мной встала классическая стена: проектов стало много, контекст в голове и в окне чата начал рассыпаться. Стандартный совет из интернета — «просто возьми LangChain, прикрути OpenAI API и залей векторную базу в Pinecone».
Но у меня нет лишних денег, чтобы оплачивать каждый чих через API. Да и тащить в проект раздутые монструозные фреймворки ради банального поиска по своим же файлам дико не хотелось.
Я решил собрать полностью локальное решение. Без внешних платных ключей, без облачных векторных БД, прямо на CPU и обычном SQLite. Ниже — разбор того, как это устроено, с какими граблями я столкнулся в процессе и почему в итоге классический RAG оказался нужен совсем не для того, о чем пишут в туториалах.
Архитектура на пальцах
Главная идея: вынести мозги и генерацию на подписочную модель IDE (Antigravity / Claude Code) через протокол MCP (Model Context Protocol), а всю память, поиск и хранение держать локально на машине через транспорт stdio.
Стек получился минималистичным:
-
Язык: чистый Python 3.12 (без LangChain, LlamaIndex и прочих оберток над обертками).
-
База данных: обычный SQLite с включенным режимом WAL (Write-Ahead Logging).
-
Транспорт: MCP-сервер через стандартные потоки ввода-вывода (stdio). Никаких поднятых веб-серверов или открытых портов.
-
Поиск: гибридный (плотные векторы на
numpy+ разреженный лексическийOkapi BM25), склеенный через Reciprocal Rank Fusion (RRF).
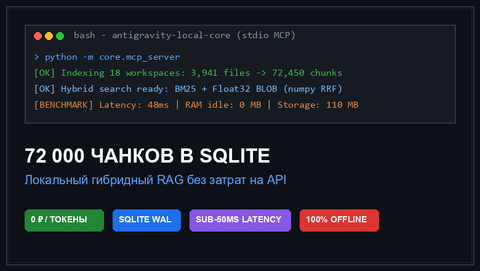
Векторы хранятся прямо в SQLite в виде бинарных BLOB (тип float32). На один чанк уходит 128 чисел с плавающей точкой — это всего около 512 байт. Вся база из 72 450 чанков по 18 моим проектам весит на диске суммарно 110 мегабайт и в простое потребляет ровно 0 мегабайт оперативной памяти.
Три бага, о которых молчат в статьях
Когда читаешь статьи про RAG, там обычно всё запускается в три строки. В реальности я споткнулся о три проблемы, на дебаг которых ушла куча нервов.
1. Несовпадение размерностей на лету (128 vs 384)
При первичной нарезке и индексации я прогнал документы через локальный провайдер с размерностью 128. А в конфиге по умолчанию для фоллбэка FastEmbed стояло 384.
При первом же запросе SQLite швырнул ValueError: Embedding dimension mismatch: stored=128, query=384.
Вместо того чтобы городить жесткие проверки и заставлять переиндексировать терабайты данных при смене модели, я добавил в класс векторного хранилища адаптер размерностей на лету:
# Validate stored embedding dimension against query dimension, adapt gracefullysample_blob = rows[0]["embedding"]stored_dim = len(sample_blob) // 4if stored_dim != dim: if dim > stored_dim: q = q[:stored_dim] else: padded = np.zeros(stored_dim, dtype=np.float32) padded[:dim] = q q = padded q_norm = np.linalg.norm(q) if q_norm < 1e-12: q_norm = 1e-12 dim = stored_dimЕсли размерности расходятся, запрос автоматически либо аккуратно усекается, либо дополняется нулями. Векторный поиск работает всегда и не падает с фатальной ошибкой.
2. Windows-слэши и коварный SQL LIKE
Все мои проекты живут на Windows. Пути к файлам выглядят как C:UsersmrsvoDesktopProjectDeckor....
В SQLite оператор LIKE '%Deckor%' на путях с обратными слэшами внезапно начал возвращать ровно ноль строк. Оказалось, в некоторых конфигурациях движка обратный слэш интерпретируется как escape-символ. Запрос просто ломался в тишине.
Лекарство оказалось элементарным — выкинуть LIKE и взять нативную функцию INSTR:
-- Было (не работало на путях Windows):SELECT id, embedding FROM rag_chunks WHERE doc_id LIKE ?-- Стало (работает стабильно и быстрее):SELECT id, embedding FROM rag_chunks WHERE INSTR(LOWER(doc_id), LOWER(?)) > 0INSTR не использует escape-последовательностей, регистронезависим в паре с LOWER и отрабатывает быстрее шаблонного сопоставления.
3. Проблема «слоновьих репозиториев»
Когда я запустил индексацию сразу по всем рабочим папкам, в базу залетел репозиторий n8n с его 38 тысячами чанков локализаций и тестов.
В итоге обычный поиск по фразе вроде «каркас брус» забирал топ-8 кандидатов из n8n еще до того, как очередь доходила до файлов самого проекта Deckor. Нужные куски кода просто вымывало из выдачи.
Решение: протащить фильтрацию по проекту (project_id) прямо в SQL-запрос выборки векторов, а не фильтровать результаты постфактум в Python. SQLite отсекает 2 300 чанков нужного проекта за 2 миллисекунды, и мусор из соседних папок даже не попадает в расчет косинусного сходства.
Главный вывод: зачем RAG нужен на самом деле
Когда система заработала, я заметил странную вещь: в простом диалоге модель всё равно норовит прочитать файл напрямую через терминал или grep, полностью игнорируя навороченный RAG.
Сначала меня это взбесило. А потом я понял: модель поступает абсолютно логично.
Если задача — узнать, что написано в CLAUDE.md на строке 20, прямое чтение файла дает 100% точности за пару миллисекунд. Векторный RAG здесь — просто лишний шум и риск получить обрезанный кусок кода без импортов.
В итоге я сформулировал для агента протокол маршрутизации (Routing Protocol), который разделил роли:
-
Текущий репозиторий: читается строго напрямую через
read_fileиgrep. -
Внешние проекты и архивы (где 100+ файлов): агент использует
rag_searchкак радар дальнего действия. Он не пытается вытащить из RAG весь код целиком. RAG нужен только чтобы мгновенно понять: «Ага, логика примагничивания узлов лежит вbuilder.pyиcustom.py». -
После этого агент точечно открывает найденные файлы и забирает точные формулы и константы (
NODE_PX=11,AXIS_PX=9).
Такая связка («RAG-навигатор + точечный инструмент») отрабатывает за секунду, не галлюцинирует и экономит десятки тысяч токенов контекста.
Что в сухом остатке
-
Вся база знаний по 18 проектам собрана в одном SQLite-файле на 110 МБ.
-
Время семантического поиска по 72к чанкам на обычном процессоре — в пределах 50 миллисекунд.
-
800 автоматических тестов в pytest подтверждают, что база не течет и держит параллельные запросы.
-
Расходы на сторонние API эмбеддингов и векторных сервисов — 0 рублей.
Если вам интересно поковырять код ядра, адаптеры для Claude Code / Antigravity и реализацию памяти с версионированием — исходники полностью открыты в репозитории antigravity-local-core на GitHub.
А за изнанкой разработки, новыми экспериментами с локальными LLM и созданием софта можно следить в моем Telegram-канале «Живи проще». Буду рад обсудить архитектурные решения в комментариях.
Источник: habr.com