
Наша задача — по истории зарегистрированных преступлений предсказать, в каких частях города на следующий день произойдёт больше событий. Город разбиваем на районы или гексы — ячейки географической сетки H3, преимущественно шестиугольные, — а время на дни. Для каждой территории модель получает прошлые наблюдения и выдаёт прогнозный балл. Затем по этим баллам выбираем территории при заданном пространственном бюджете — доле площади или числа ячеек и проверяем, какая доля событий следующего дня в них попала. Отдельно оцениваем точность прогнозируемого количества: хорошо ранжировать территории и точно предсказывать числа — разные задачи.
 Условный город на гексагональной сетке: локальные связи и группы узлов графа.
Концептуальная иллюстрация городского графа, созданная с помощью ImageGen. Геометрия и связи условные.
Начать можно без нейросети. Для каждой территории заведём счётчик: каждый день немного уменьшаем накопленное значение и прибавляем число событий за прошедший день. Это экспоненциальное сглаживание EWM-30. События вчерашнего дня влияют сильнее давних, а через 30 дней их вес уменьшается вдвое. Старые наблюдения не отбрасываются резко: число 30 означает период полураспада, а не длину окна.
Такой бейзлайн сочетает устойчивую карту горячих точек с реакцией на недавнюю активность. Ему не нужны граф, сведения об объектах городской среды (POI, points of interest: магазинах, школах, остановках) или обучение весов. Поэтому содержательный вопрос для более сложной модели — какую дополнительную информацию она извлекает сверх этой взвешенной истории? Помогает ли порядок дней, история разных категорий, обмен с соседями или информация о городской среде и поездках?
Мы проверяли эти гипотезы на Лиме и Чикаго: от GRU — рекуррентной сети, последовательно обновляющей память по дням, — и TCN, сети со свёртками вдоль временной оси, до графовых моделей, обменивающихся информацией между территориями. Результаты зависели от постановки: выигрыш при выборе районов не обязательно сохранялся на гексах, а улучшение категориального прогноза не всегда улучшало общий. Ниже разберём не только итоговые метрики, но и контрольные сравнения, позволяющие понять источник прибавки.
Это обзор проведённых экспериментов, включая отрицательные результаты и ошибки реализации. Сначала разделим задачи и правила оценки, затем пройдём по архитектурным гипотезам: что добавляли к истории, с чем сравнивали и какой вывод действительно поддерживают данные.
1. Три постановки вместо одной таблицы победителей
Во всех треках прогноз относится к зарегистрированным событиям следующего дня, но обучающие задачи и пространственные единицы различаются.
Чтобы оценить прогноз, каждый день выбираем территории с наибольшими прогнозными баллами, ориентируясь на заданный бюджет — например, 5% площади города. Затем считаем, какая доля фактически зарегистрированных событий попала в этот выбор. Это hit rate, или доля захваченных событий.
PAI (Prediction Accuracy Index) показывает, насколько события сконцентрированы в выбранной территории по сравнению со средним по всей оцениваемой области:
PAI = доля событий в выбранной территории / доля выбранной территорииНапример, если в выбранных 5% площади оказалось 20% событий, то PAI = 0,20 / 0,05 = 4. Концентрация событий там в четыре раза выше средней. PAI = 1 означает захват, пропорциональный площади; больше единицы — повышенную концентрацию. Это не процент правильных прогнозов и не вероятность преступления.
Обозначение PAI@5% указывает на целевой бюджет выбора. Чем выше показатель, тем больше событий удаётся захватить на единицу выбранной территории. При этом важны и сам захват, и фактическая площадь: высокий PAI не обязательно означает большее абсолютное число попаданий, если модели выбрали разные площади.
В протоколах прогноза количества MAE (mean absolute error) — средняя абсолютная ошибка числа событий на территорию и день. Например, для прогнозов 2 и 5 при фактических значениях 1 и 3 она равна (1 + 2) / 2 = 1,5. В бинарных задачах Лимы ошибки вероятностей имеют другой смысл и не сравниваются с count-MAE Чикаго. Таким образом, модель может хорошо выбирать территории и плохо оценивать масштаб событий. Ниже это окажется одним из главных различий между результатами.
Протокол
Пространство и период
Обучающая цель
Основная оценка
Лима
2 120 ячеек H3 разрешения 8; 302 дня 2026 года
Метки 0/1 по пяти категориям и отдельный общий выход any
Захват числа событий в верхних 5% ячеек
Чикаго, районы
77 статистических районов (community areas); 2023/2024/2025
Число событий, иногда с категориальными выходами
Выбор целых районов по бюджету площади
Чикаго, H3
2 848 ячеек H3 разрешения 9; те же годы
Число событий в гексе либо по категориям
Территориальный PAI и MAE на фиксированной сетке
Train — обучающая часть, на которой подбираются веса модели; validation (Val в таблицах) — отдельный период для выбора настроек и лучшего сохранённого состояния; test — последующий период итоговой оценки. В Чикаго это соответственно 2023, 2024 и 2025 годы. Чикагский тестовый период уже просматривался в предыдущих сериях, поэтому остаётся разведочным: результат на нём не заменяет проверку на новом, ещё не использованном периоде. Лимский основной тест — 37 дней, с 23 сентября по 29 октября; часть исторических серий дополнена отдельными временными и географическими проверками.
Каждый прогноз строится из прошлой истории: L28 означает последние 28 дней, [t−28,t) — от дня t−28 включительно до дня t, не включая сам прогнозируемый день. Из прошлого берутся и динамические рёбра мобильности. Однако дата события не равна дате публикации записи. Без отдельного аудита задержек эти эксперименты оценивают ретроспективный прогноз, не готовый онлайн-сервис.
В таблицах ниже hit@5% обозначает долю событий, захваченных при целевом бюджете 5%. Реализация самого бюджета различается между протоколами. В Лиме выбираются 106 из 2 120 ячеек, с номинальным знаменателем 0,05. В районном Чикаго используются неодинаковые полигоны: стандартный алгоритм может превысить 5% площади при добавлении последнего целого района. В чикагском H3-протоколе площадь также входит в процедуру расчёта метрики (evaluator). Поэтому PAI Лимы, районов и гексов Чикаго напрямую не сравниваем.
Как читать сравнения. Seed (сид) — число, задающее начальное состояние генератора случайных чисел; им обозначают соответствующий запуск. Разные сиды меняют инициализацию и другие случайные операции. Ансамбль усредняет прогнозные баллы нескольких запусков до выбора территорий. Среднее готовых метрик по сидам — другая операция; в таблицах отмечено, какая используется.
Запись Δ = +0,10 [−0,02; +0,22] означает разность метрик «модель минус контроль» и её 95%-й доверительный интервал. Здесь интервалы получают парным bootstrap: многократно выбирают с возвращением одни и те же дни или блоки дней для обеих моделей и пересчитывают разность. Если интервал включает ноль, преимущество не установлено этим сравнением; это не доказательство равенства. Такой интервал относится к данным и выбранным прогнозам, а не ко всем будущим периодам или случайным инициализациям.
Разрешение H3 задаёт размер ячеек: у уровня 9 ячейки мельче, чем у уровня 8. Номер уровня не является количеством районов. В Лиме и Чикаго также различаются правила отбора ячеек, поэтому даже одинаковая форма сетки не делает выборки сопоставимыми.
2. Что именно мы добавляли к истории
В графе узел соответствует территории, а ребро задаёт, откуда модель может получить информацию. Физическое ребро соединяет соседей; обучаемое определяется параметрами сети. Гиперребро объединяет сразу группу узлов и позволяет обмениваться общим представлением. Ни один из этих типов связей сам по себе не означает причинного влияния.
Представление, или embedding, — числовой вектор, которым сеть описывает территорию или категорию. Encoder (энкодер) превращает входы в такие векторы, backbone — основная обрабатывающая часть модели, head (голова) — выходной блок, выдающий прогноз. MLP — многослойная полносвязная сеть. Attention — обучаемое взвешивание входных представлений; оно не служит готовым объяснением причин результата.
Дополнительный контекст включает OpenStreetMap (OSM) и мобильность. OD, origin–destination, — число опубликованных поездок между районами старта и назначения. Rideshare здесь означает опубликованные агрегаты поездок сервисов заказа автомобилей, а не совместные поездки нескольких пассажиров.
Теперь сгруппируем модели по проверяемой гипотезе.
Группа
Реализованные варианты
Предполагаемый дополнительный сигнал
Временные модели
GRU, TCN, MLP и обучаемые поправки к EWM
Порядок, недавние изменения и нелинейные сочетания истории
Пространственно-временные графы
DCRNN, STGCN, Graph WaveNet, MTGNN, CrimeForecaster; пилот GraphSAGE
Физические соседи, диффузия или обучаемые связи между территориями
Категории и гиперграфы
ST-SHN, HAGEN, ST-HSL, MiST, DeepCrime, multichannel GRU
История типов событий, смешивание каналов и дальние пространственные зависимости
Региональные представления
HAFusion, AutoST, GraphST, CooKIE
Совместный контекст POI и мобильности, предобучение и объединение источников
Иерархический контекст
Гексы ↔ районы, районные taxi/rideshare, OD-варианты
Дополнительная информация более крупного пространственного уровня
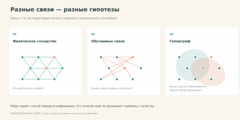 Три способа связать территории: физическое соседство, обучаемые связи и гиперграф.
Одинаковые условные узлы, разные способы обмена информацией. Цвета и связи не показывают результаты обучения.
Это наши адаптации, а не воспроизведение всех опубликованных экспериментов. Районные модели переведены на общий next-day count-контракт, некоторые авторские декодеры и источники данных отсутствуют. У AutoST/GraphST используются дневные адаптации представлений с общим downstream GRU. Лимский a0_paper — sketch ST-SHN, несмотря на имя. Совпадение размеров массивов не устанавливает соответствие авторской реализации; важны нормировка, остаточные (residual) пути, передающие исходное представление в обход блока, функция ошибки обучения (loss) и область оценки.
Схемы по исходным статьям: DCRNN · STGCN · Graph WaveNet · MTGNN · CrimeForecaster · HAGEN · ST-SHN · ST-HSL · MiST · DeepCrime · HAFusion · AutoST · GraphST · CooKIE
Абляция — контролируемое отключение или изменение компонента. При переобучении модель заново учится с изменённой структурой; при вмешательстве на инференсе, то есть во время расчёта прогноза, меняют уже готовое решение без обновления весов. Matched-контроль сохраняет сопоставимые данные, backbone, бюджет и условия обучения, меняя проверяемую часть. Эти два вида экспериментов отвечают на разные вопросы и не заменяют друг друга.
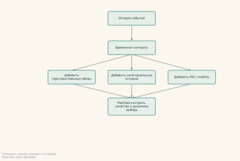 Схема архитектуры: поток блоков
3. Лима: одной сложной сети было недостаточно
Лимский тензор содержит 71 715 событий после исключения violencia_familiar и записей вне итоговой сетки. Окно — 28 дней; пять каналов соответствуют группам hurto (кражи), robo (грабежи/разбой), vehiculo (преступления, связанные с транспортными средствами), estafa_extorsion (мошенничество/вымогательство), otros (остальные включённые категории). Отдельная голова any прогнозирует наличие хотя бы одного события из этих групп. Обучающая метка равна 0 или 1, но при оценке захвата каждое зарегистрированное событие считается отдельно.
Начали со ST-SHN: категориальных векторов, обмена по H3-графу, гиперграфа и временных обновлений. Подробности операций важны для воспроизведения и разобраны в приложении A. В основном сравнении наш sketch — упрощённый вариант авторской конструкции — не установил преимущество над EWM-30. В вариантах с offset дополнительно вводится prior: сглаженная историческая частота положительных дней ячейки до начала входного окна, добавленная к сетевому прогнозу в шкале логарифма шансов (log-odds). Подробная формула приведена в приложении A.
Историческая оценка на полном тесте Лимы
PAI@5%
EWM-30
8,248
ST-SHN sketch, a0_paper
8,170
Sketch с историческим prior, a1_offset
8,130
Offset и все OSM-ветки, a5_all_poi
8,080
Для сетей здесь среднее метрик трёх отдельно калиброванных сидов. Калибровка преобразует выходной балл в вероятность по validation-наблюдениям. Это не PAI ансамбля средних прогнозов.
Источник: habr.com