
Что такое деление целых чисел со знаком с округлением вниз?
Деление целых чисел со знаком с округлением вниз — это когда мы выполняем a/b и получаем результат, округлённый в сторону −∞, в то время как стандартное деление (с усечением) чисел со знаком округляется в сторону 0. Как сказано в книге Hacker’s Delight, «[Я подозреваю, что] деление с округлением вниз чаще даёт нужные нам результаты.»
Эта статья посвящена делению с округлением вниз чисел во всём диапазоне, когда делитель известен во время компиляции.
Несмотря на полезность этой функции, мир деления целых чисел с округлением вниз находится в полном хаосе:
-
В популярных компиляторах и многих языках нет нативной реализации такого деления (например, в C/C++/Go/Swift).
-
Языки и программные библиотеки, которые всё же реализуют его, почти не никогда не применяют самые быстрые алгоритмы.
-
По крайней мере в одной крайне распространённой программной библиотеке уже более четырёх лет присутствует забагованная реализация такого деления с переполнением! (подробности ниже)
-
При онлайн-запросах и промптах к LLM обычно выдаются только самые медленные алгоритмы
-
И, наконец, в Hacker’s Delight (по сути, Библии низкоуровневой компьютерной математики) почти ничего о нём не говорится!
В этом посте я не только расскажу о быстрых алгоритмах, но и приведу новый быстрый алгоритм, который при идеальной компиляции:
-
На ARM для большинства 64-битных делителей обеспечивает в бенчмарках на 10–20% больше пропускной способности, чем предыдущие алгоритмы (иногда результаты оказываются равными) с одинаковыми или меньшими задержками
-
На x86 бенчмарки показывают:
-
на ~5-10% больше пропускной способности для примерно 80% положительных 64-битных делителей (60% для отрицательных)
-
меньшую скорость в оставшихся случаях x86 и обычно худшие (но сравнимые) задержки
-
В разделе «Бенчмарк» приведён подробный обзор, демонстрирующий результаты по пропускной способности и задержкам для разных делителей и на нескольких платформах.
Алгоритм работает для всех битовых длин и может найти свою нишу на некоторых 32-битных или SIMD-платформах, но наибольший выигрыш он даёт на 64 битах. Также его можно использовать для более быстрого деления с остатком положительных чисел, а также для более быстрого евклидова деления (отличается от деления с округлением вниз в случае отрицательных делителей).
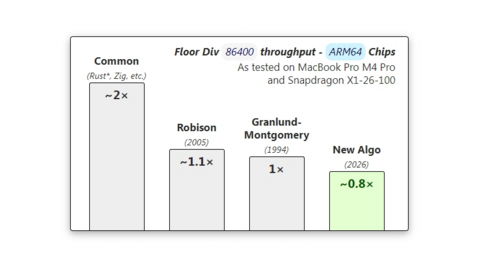
Деление с округлением вниз может быть гораздо быстрее, чем вы представляете. Ниже показан фрагмент бенчмарка пропускной способности для деления на 86400 (количество секунд в одном дне) со сравнением производительности при использовании встроенных в большинство языков методик и более быстрых альтернатив, представленных в этом посте.
Примечание: в столбчатой диаграмме ниже = быстрее.
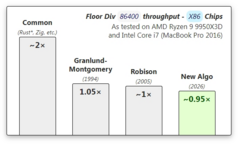 *В Rust есть div_euclid, имеющий схожие с floor-div результаты для положительных делителей. Более подробное сравнение с более чем 40 делителями см. в разделе «Бенчмарк».
Некоторые люди будут приходить на эту страницу, чтобы просто скопипастить код, поэтому я сразу приведу пример алгоритма для разных битовых длин и делителя 86400. В оригинале статьи этот блок интерактивен:
64 бита:
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 86400.// (rounds towards negative infinity).// Accurate over the full signed 64-bit range.// Sign-selected multiplier variant.// Optional ref:// https://www.benjoffe.com/fast-floordiv#fn=i64_86400inline int64_t fast_i64_floordiv_86400(int64_t x) { const int64_t M = ((__int128(1) <> 63); return (__int128) x * m >> 79;}32 бита:
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 86400.// (rounds towards negative infinity).// Accurate over the full signed 32-bit range.// Round-down multiplier (forced).// Optional ref:// https://www.benjoffe.com/fast-floordiv#fn=i32_86400inline int32_t fast_i32_floordiv_86400(int32_t x) { const int32_t M = ((1ll << 47) / 86400); // 1628906115 const int32_t t = x + (uint32_t(x) > 47;}16 бит:
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 86400.// (rounds towards negative infinity).// Accurate over the full signed 16-bit range.// Trivial case.// Optional ref:// https://www.benjoffe.com/fast-floordiv#fn=i16_86400inline int16_t fast_i16_floordiv_86400(int16_t x) { // Divisor exceeds signed bit-width range, // operation is identical to a sign-check. return x >> 15;}8 бит:
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 86400.// (rounds towards negative infinity).// Accurate over the full signed 8-bit range.// Trivial case.// Optional ref:// https://www.benjoffe.com/fast-floordiv#fn=i8_86400inline int8_t fast_i8_floordiv_86400(int8_t x) { // Divisor exceeds signed bit-width range, // operation is identical to a sign-check. return x >> 7;}Во избежание разночтений сообщу, что лицензия применима только при копипастинге комментария и кода. Лицензия не требуется, если вы перепишете ту же логику в своём коде.
Сильные стороны алгоритма лучше всего проявляются при 64 битах. В случае меньших диапазонов стоит подумать об использовании алгоритма Робисона.
Также приведу эталонный алгоритм (универсальный шаблон на C++ с дополнительными улучшениями производительности под микроархитектуру).
Как видите, алгоритм настолько прост, что его как будто должны были придумать давно, но я поискал и нигде не увидел, что его документировали. Если окажется, что его уже публиковали, то, по крайней мере, благодаря этой странице его можно будет найти.
Начнём со стандартного деления
Предположим, что вам нужно преобразовать измеряемую в секундах временную метку Unix в rata-die (количество дней). Также предположим, что вы забыли, как это делается правильно, и используете стандартное деление (с усечением).
Нам нужно поделить на 86400 (60×60×24). Мы будем использовать 64-битную временную метку, потому что в 32-битной метке может храниться всего около ±68 лет.
Нас вполне устроит эта реализация, пока кто-то не передаст временную метку до 1970 года!
Стандартное деление C++.
Дано: x — целое 64-битное число со знаком
const int64_t rd = x / 86400;return rd;Эта функция возвращает неверные результаты для большинства отрицательных значений.
Разумеется, следует использовать деление с округлением вниз; этот тип деления полезен для отслеживания повторяющихся паттернов наподобие временных меток, угловых поворотов, позиций тайлов и так далее. Это тот тип деления, в котором операция % даёт настоящий положительный остаток от деления, а не тот псевдоостаток, который даёт % в C++, JavaScript и других языках.
Тем не менее полезно будет понять, как устроено внутри подобное стандартное деление. Показанный ниже псевдокод демонстрирует поведение скомпилированного ассемблерного кода. По сути, это умножение с последующим сдвигом (mul‑shift) и прибавлением единицы (bump-by-1) для отрицательных чисел.
Этапы скомпилированного стандартного деления (псевдокод)
const i64 M = (i128(1) <> 77 // high64(wide) >> 13const i64 sign = u64(x) >> 63 // ts < 0 ? 1 : 0return tbit + signЭтапы задержек на x86-64
Этап
Вычисление 1
Вычисление 2
1
wide = ts * M
2
задержка при умножении (mul-latency)
sign = u64(ts) >> 63
3
mul-latency
4
high64bits(wide) >> 13
5
... + sign
Если вы не имеете большого опыта работы с битами, то этап u64(ts) >> 63 может показаться странным. На нём мы просто перемещаем самый старший бит в самый низ. Поскольку в компьютерах с представлением чисел в дополнительном коде старший бит — это знак, в результате для отрицательных чисел получается 1, а для положительных — 0.
Примечание о несговорчивых делителях
Если всё это для вас ново, то вы можете подумать: «Отлично, теперь я понимаю, как работает деление со знаком на уровне компилятора!». К сожалению, вынужден вас разочаровать: вот как эта же самая операция выглядит для 64-битного деления на 100:
Деление на 100 (C++).
Дано: x — целое 64-битное число со знаком
return x / 100;Низкоуровневые этапы деления на 100 (псевдокод)
const i64 M = (i128(1) <> 64) + x) >> 6const i64 sign = u64(x) >> 63return tbit + signДолжно быть вы заметили, что теперь здесь есть дополнительный мусор: ((wide >> 64) + x) >> 6. Он необходим, потому что волшебный множитель 100 требует всех 64 бит для M. Из-за этого верхний бит равен 1, поэтому M становится отрицательным числом и при вычислениях значение M оказывается на 2^64 меньше истинного. Так как мы вычисляем x * M, значение wide оказывается на 2^64 * x ниже, чем должно быть. Прибавив x к верхнему регистру широкого двухрегистрового результата, мы полностью исправляем эту ошибку. Делители, требующие таких корректировок, некоторые авторы называют несговорчивыми (uncooperative divisors).
Этапы задержек на x86-64
Этап
Вычисление 1
Вычисление 2
1
wide = x * M
2
mul-latency
sign = u64(x) >> 63
3
mul-latency
4
high64bits(wide) + x
5
... >> 6
6
... + sign
Главный вывод здесь заключается в том, что стандартное деление обычно стоит примерно 1 умножение + 2-3 такта.
Устраняем баг
Что ж, вернёмся к div 86400; мы столкнулись с багом и решили его пропатчить. Довольно очевидно, что баг может возникать при x < 0, но не всегда. Если число отрицательно и при этом делимо на 86400, всё работает без ошибок. Следовательно, устранять его нужно при rem < 0:
C++
const int64_t div = x / 86400;const int64_t rem = x % 86400;return div - (rem < 0);Но вы наверно подумали, что наверняка должен быть более быстрый способ? Вычисление остатка от деления почти так же затратно, как и само деление, а в нашем теоретическом сценарии использования этот остаток после корректировки на единицу всё равно отбрасывается.
C++ (привлекательно, но на самом деле медленнее)
const int64_t div = x / 86400;return div - (div * 86400 > x);Однако на самом деле он медленнее! Можете сходить на Godbolt и убедиться, что он генерирует больше ассемблерных строк.
Ладно, к чёрту эту нелогичную чушь, давайте загуглим «fast floor division in c++» и получим ИИ-сводку (кэшированный экспорт в PDF).
Эта сводка совершенно неверна: в ней ошибочно говорится «Вот самые быстрые способы без ветвления для каждого сценария», а затем приводится процедура деления на константу с округлением вниз, которая не лучше, чем приведённая выше попытка, хотя уже больше тридцати лет известны более быстрые способы (впрочем, она хотя бы обрабатывает отрицательные делители).
ИИ предлагает показанный ниже код:
Общее решение для делителей со знаком.
Дано: x, y — целые числа со знаком
const int64_t div = x / y;const int64_t rem = x % y;return div - (rem != 0 && (x ^ y) < 0);По крайней мере, теперь у нас есть гибкая вспомогательная функция и похоже, что GCC и Clang могут компилировать её в тот же ассемблерный код, что и предыдущую версию, когда делитель был жёстко задан (см. Godbolt).
По сути, это та же функция, которая используется Java Math.floorDiv, numpy Python, Zig, Ruby и многими другими библиотеками.
Что об этом говорится в Hacker’s Delight
В оглавлении второго издания Hacker’s Delight есть раздел «10–12 Applicability to Modulus and Floor Division». Звучит многообещающе!
Он идёт сразу после десятков потрясающих страниц изящных трюков для других типов деления (со знаком, беззнакового и так далее).
Всё содержимое раздела 10–12 выглядит так:
«Может показаться, что преобразовать взятие остатка от деления или целочисленное деление с округлением вниз на константу в умножение проще, поскольку тогда можно было бы обойтись без шага «прибавить 1, если делимое отрицательное». Но это не так. Описанные выше методы не применимы к вычислению остатка от деления и делению с округлением вниз сколько-нибудь очевидным образом. Возможно, решение всё же можно найти; оно может заключаться в небольшом изменении множителя m в зависимости от знака делимого.» — Генри Уоррен, Hacker’s Delight, 2nd Edition
И это весь раздел…
Обычно копирование целого раздела книги считалось бы нарушением авторского права, но он настолько короткий, что это вполне можно считать оправданным использованием.
Хоть Уоррен и не предлагает никаких решений, выделенная полужирным часть идеально точно предсказывает новое решение, о котором я расскажу ниже.
Более быстрые техники
Уже было бы вполне простительно считать, что код сильнее оптимизировать невозможно; возможно, для делителей, известных только в среде исполнения, это и так (я не исследовал этот вопрос, потому что в основном интересовался константными делителями). Поискав ещё, находим первый результат в Google: археологические останки когда-то активного Stack Overflow. Заголовок интересный: Fast floor of a signed integer division in C / C++.
Пост опубликован в 2017 году, под ним шесть ответов. Автор поста и пять верхних по популярности результатов используют разновидности приведённой выше техники.
Если же прокрутить страницу до конца, то можно увидеть, что спустя семь лет пользователь ufoguy наконец-то опубликовал ответ, который существенно быстрее для делителей, известных во время компиляции:
«[Не совсем] понимаю, почему никто об этом не говорит; лишь одно деление, без нахождения остатка и без ветвления:»
C++ — деление с округлением вниз (где b > 0)
int floor_div(int a, int b) { return (a + (a < 0)) / b - (a < 0);}Судя по моим бенчмаркам, этот код улучшает ситуацию: на большинстве устройств его пропускная способность примерно на 50% больше.
Что же ufoguy получил за свой комментарий? Никакой благодарности, никаких лайков, лишь комментарий, в котором говорится, что код не учитывает отрицательные делители. Это действительно недостаток. Если мы хотим написать быструю библиотеку общего назначения, код должен быть гибким.
К счастью, общий случай был решён как минимум в 90-е. Он чётко задокументирован на странице 6 статьи Division by Invariant Integers using Multiplication — Granlund, Montgomery, 1994.
При помощи техники из этой статьи можно написать простую гибкую шаблонную функцию (для ненулевого делителя, известного во время компиляции). Я подготовил пример с использованием этой техники, который на C++ можно вызвать так: floor_div(timestamp);.
Стоит отметить, что в статье показана версия полностью без ветвления, но для деления на константы я предпочитаю приведённый выше: в нём сразу понятно, что происходит, а поскольку ветвление определяется на этапе компиляции, оно гарантированно будет упрощено. Компиляторы без труда распознают повторяющееся сравнение, например (x < 0), и повторно используют его результат. Однако стоит посмотреть на сравнение с версией без ветвления в Godbolt, чтобы понять, почему у MSVC возникают проблемы с её упрощением. Кажется, что мы решили проблему floor-div? На самом деле, мы только начинаем…
#include template constexpr decltype(D) floor_div(decltype(D) x) { static_assert(std::is_integral_v && std::is_signed_v && D != 0, "divisor must be a signed non-zero integer"); if constexpr (D > 0) return (x + (x < 0)) / D - (x 0)) / D - (x > 0);}Трюк с XOR для положительных делителей
Деление в предыдущем разделе в лучшем случае представляло собой умножение со сдвигом (mul-shift) плюс 5-6 тактов.
Почему так много?
-
Один на
x < 0(илиx > 0). -
Один на сложение с числителем.
-
Один на вычитание из результата.
-
Два или три на само деление (помните, выше мы показали, что деление — это mul-shift + 2-3 такта?)
К счастью для нас, у Грэнлунда и Монтгомери есть ещё один туз в рукаве, но он предусмотрен только для положительных делителей:
Floor Div — быстрый положительный путь (v1).
Дано: D — положительный 64-битный integer
Заранее вычислено: M — магический множитель
Заранее вычислено: S — магический сдвиг
i64 s = x >> 63 // x > Si64 c = b ^ sreturn c;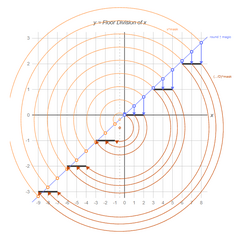
Я попытался визуализировать это на диаграмме. Всё это выглядит немного безумно!
Операция x ^ s перемещает отрицательные входящие значения в неотрицательную область; отрицательные значения превращаются в -1 - x; (теперь >= 0).
Это полностью аналогично отражению относительно -0.5, поскольку опорная точка всех дуг находится на вертикальной пунктирной прямой.
Мы сильно здесь экономим благодаря тому, что a не только не имеет знака, но и находится в диапазоне лишь 0..2^63-1 (половина от обычного диапазона). Из-за этого mul-shift по-прежнему будет работать во всех случаях, даже при несговорчивых делителях.
Я нашёл одну библиотеку, в которой реально применяется такая методика. Это PyPy, но в случае отрицательных делителей она снова использует алгоритм с div/mod.
Как можно понять, теперь у нас есть mul-shift плюс 3 такта, то есть ситуация определённо улучшилась. Теоретически, на ARM можно было бы получить mul-shift плюс 2 такта, поскольку операции сдвига вправо можно объединить с операциями XOR, но на практике, на проверенных мной компьютерах, такое объединение не даёт того прироста скорости, который можно было бы ожидать, исходя из простого подсчёта тактов. .
Техника умножения со сложением Робисона
Я нашёл ещё одну замечательную статью о делении с округлением вниз: N-Bit Unsigned Division Via N-Bit Multiply-Add, 2005 Arch D. Robison. Статья в основном посвящена делению без знака, но в Section 4.3 рассматривается деление с округлением вниз.
В этой статье представлена потрясающая идея, похожая на идеальное решение всех проблем. В ней не используется ветвление или тернарные операции, во многих случаях она представляет собой простое умножение, сложение и сдвиг (mul-add-shift).
Ниже представлены варианты для разных длин данных.
А это пример простоты алгоритма в наилучшем из случаев:
Floor Div 100 (Робинсон).
Дано: x — целое 32-битное число со знаком
i32 A = 1374389535i32 B = 0x28F50000 // 687144960return (i64(x) * A + B) >> 37;Обратите внимание, что в примере выше я использую аддитивное значение 0x28F50000, а в статье применяется A/2. Это тоже шестнадцатеричное значение с обнулёнными младшими двумя байтами, что обеспечивает более компактный ассемблерный код ARM. Эту оптимизацию можно применять не ко всем делителям, это необходимо делать аккуратно.
Примеры функции Робисона
64 бита
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 100.// (rounds towards negative infinity).// Accurate over the full signed 64-bit range.// Robison's N-bit multiply-add method.// Cooperative divisor (`A` fits in bit-width).// Optional ref:// https://www.benjoffe.com/fast-floordiv#robison=i64_100inline int64_t robison_i64_floordiv_100(int64_t x) { int64_t A = ((__int128(1) <> 49) <> 69);}Сильные стороны алгоритма лучше всего проявляются при 8, 16, 32 битах. В случае 64 битов диапазонов стоит подумать об использовании моего нового алгоритма.
32 бита
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 100.// (rounds towards negative infinity).// Accurate over the full signed 32-bit range.// Robison's N-bit multiply-add method.// Cooperative divisor (`A` fits in bit-width).// Optional ref:// https://www.benjoffe.com/fast-floordiv#robison=i32_100inline int32_t robison_i32_floordiv_100(int32_t x) { int32_t A = ((1ll <> 37);}16 бит
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 100.// (rounds towards negative infinity).// Accurate over the full signed 16-bit range.// Robison's N-bit multiply-add method.// Uncooperative divisor. Widened mul-add.// Optional ref:// https://www.benjoffe.com/fast-floordiv#robison=i16_100inline int16_t robison_i16_floordiv_100(int16_t x) { int32_t A = ((1 <> 22);}8 бит
// MIT License // // Copyright (c) 2026 - Ben Joffe // // Permission is hereby granted, free of charge, to any person obtaining a copy// of this software and associated documentation files (the "Software"), to deal// in the Software without restriction, including without limitation the rights// to use, copy, modify, merge, publish, distribute, sublicense, and/or sell// copies of the Software, and to permit persons to whom the Software is// furnished to do so, subject to the following conditions:// // The above copyright notice and this permission notice shall be included in// all copies or substantial portions of the Software.// // THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR// IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,// FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE// AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER// LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,// OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE// SOFTWARE. // Fast floor division by 100.// (rounds towards negative infinity).// Accurate over the full signed 8-bit range.// Robison's N-bit multiply-add method.// Cooperative divisor (`A` fits in bit-width).// Optional ref:// https://www.benjoffe.com/fast-floordiv#robison=i8_100inline int8_t robison_i8_floordiv_100(int8_t x) { int8_t A = ((1 <> 12);}Во избежание разночтений сообщу, что лицензия применима только при копипастинге комментария и кода. Лицензия не требуется, если вы перепишете ту же логику в своём коде.
На устройствах ARM этот код компилируется в одну объединённую операцию «умножение с накоплением» (multiply-accumulate), за которой следует сдвиг вправо. Даже на ARM32 она может использовать операцию smlal для умножения, прибавления константы и получения старшего 32-битного результата без необходимости эмуляции 64 бит.
Разумеется, устройства x86-64 могут выполнять код без проблем: mul, add, shift.
Чуть менее чистым (но не ужасным) становится код на 32-битных x86. На этой платформе сложение выполняется с младшим 32-битным результатом, за которым следует adc со старшим 32-битным результатом (добавляется «флаг переноса», содержащий 1 или 0 в зависимости от того, переполнен ли младший регистр).
Так в чём же проблема этой формулы? На самом деле, проблем целых две…
Floor Div 101 (Робисон). См. Godbolt
Дано: x — целое 32-битное число со знаком
i64 A = 2721563435i32 B = 0x511B0000 // 1360723968return (i64(x) * A + B) >> 38;Проблема №1: часто требуется более широкое умножение.
Выше показано, как всё меняется при делении на 101. Здесь есть большое отличие. Интересно, сможете ли вы его найти…
Обратили внимание, что A теперь не i32, а i64?
Это пример несговорчивого делителя этой формулы; случай, когда количество необходимых в множителе битов на 1 больше, чем нужно.
-
Можно заметить, что
Aпо-прежнему находится между 231 и 232, так почему же ей требуется 64-битный тип? Если бы это число было представлено какi32, то старший бит был бы равен1, что вызвало бы циклический переход к-1573403861. -
Также можно заметить, что если записать его как
u32, то код будет работать правильно. Делает ли это его нативно 32-битным? К сожалению, нет. Я многократно обманывался в подобных случаях. Он по-прежнему работает как 64-битное умножение и на ARM, и на x86, так как у них нет встроенной операцииi32 * u32 ➜ i64(как нетi64 * u64 ➜ i128и так далее).
Проблема №2: умножение с расширением разрядности становится неудобным при работе с 64-битными числами
В предыдущих примерах мы говорили об использовании более широких типов. Это не работает в 64 битах: можно использовать в коде «128-битный» тип, но он будет «имитироваться» парами 64-битных регистров. Ниже показано, как формула Робисона работает в случае делителя 86400:
Floor Div 86400 (Робисон) — «Add Back v1»
Дано: x — целое 64-битное число со знаком
i64 A = -4454547087429121353 // 2^80 / 86400 + 1 - 2^64i64 B = 0x6117 <> 64 // сложение шириной 128 бит + 64 бит// ниже "добавление обратно": коррекция отрицательного A.return (h + x) >> 16По ссылке на Godbolt можно увидеть, что на x86 этот код компилируется вполне разумно. Основное препятствие — операция «добавления обратно» (add back): на x86 для неё требуется всего пара инструкций (adc), а на ARM64 всё гораздо сложнее: нужны две операции умножения (mul и smulh). Это связано с тем, что на ARM64 для получения старшей и младшей 64-битных частей результата требуются отдельные операции умножения.
«Добавление обратно» необходимо по той же причине, что и в разделе «Примечание о несговорчивых делителях».
Эти «проблемы» не так уж серьёзны, а код по-прежнему представляет собой очень быструю функцию деления с округлением вниз. Просто у нас ещё остаются возможности для оптимизации.
Примечание: на случай, если вы этого ещё не поняли, скажу, что проблемы №1 и №2 на самом деле идентичны.
Существует второй способ записи тех же вычислений, при котором перенос разряда прописывается вручную и код не полагается на 128-битное сложение. Пример приведён ниже.
Floor Div 86400 (Робисон) — «Add Back v2». См. Godbolt.
Дано: x — целое 64-битное число со знаком
i64 A = -4454547087429121353 // 2^80 / 86400 + 1 - 2^64u64 B = 0x6117 <> 64) + x // "добавляем обратно" xhi += (lo + B > 16Теоретически, компилятор должен генерировать эквивалентный ассемблерный код для обоих способов; на практике, эти два способа не всегда компилируются одинаково, поэтому полезно знать оба и выбирать тот, с которым компилятор справляется лучше. Идеальным выводом для способа с переносом будет add, за которой следует потребляющая перенос команда (adc на x86, cmp + cinc на ARM64); недостаток этого подхода — более длинная цепочка зависимых операций на критическом пути.
Ассемблерный код обоих способов можно посмотреть на Godbolt. GCC и Clang генерируют более компактный ассемблерный код для разных вариантов. Поскольку компиляторы обрабатывают их по-разному, в бенчмарки включены оба варианта, чтобы провести более полное сравнение.
Есть ещё одна особенность компилятора, о которой стоит знать: когда множитель A — это константа времени компиляции, clang переписывает smulh(x, A) в umulh(x, A) + (x >> 63) * A, добавляя две команды к каждому делению. Чтобы этого избежать, достаточно одной строки с барьером inline-ассемблера, которая помещает A в регистр, но скрывает его значение от оптимизатора. При этом сама константа по-прежнему материализуется один раз и выносится за пределы цикла.
Тем не менее там, где возможно расширение разрядности, подход Робисона отлично работает. Сюда относится целочисленное деление с округлением вниз 32-битных чисел на ARM (в данном случае даже с использованием SIMD). Он идеально подходит для всех сценариев с 8-битными числами, поскольку, судя по всему, все распространённые процессоры в любом случае требуют удвоения разрядности при умножении 8-битных чисел.
Кроме того, этот подход позволяет реализовать несколько действительно интересных частных случаев, например:
fast_i8_floordiv_51 => (x * 5 + 2) >> 8
Приведённая выше функция на x86 может компилироваться всего в две ассемблерные инструкции! (LEA + арифметический сдвиг вправо.)
Наконец, переходим к новому
«В конечном итоге, все эти алгоритмы компьютерного деления — просто усложнённые mul-shift.» — Сунь-цзы, «Искусство войны»
Давайте попробуем спуститься на самый низкий уровень и посмотрим, что получится, если использовать для деления на 3 обычную комбинацию умножения и сдвига.
Никаких коррекций и вообще ничего лишнего.
Мы выбрали 3, поскольку это первый нетривиальный делитель (деление на степени двойки решается простым арифметическим сдвигом вправо).
Сырой 64-битный mul-shift: «псевдоделение на 3» (множитель с округлением вверх)
Дано: x — целое 64-битное число со знаком
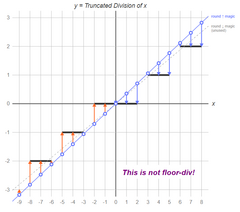
i64 M = u64(-1) / 3 + 1 // u64(-1) = 2^64-1i64 y = (i128) x * M >> 64Множитель с округлением вверх даёт идеальную последовательность троек в положительном направлении и всего один разрыв в отрицательном: набор из −1 и −2 (все отрицательные значения сдвигаются вправо).
Округление вверх:

Примечание: такая визуализация наглядно показывает, почему стандартное деление с усечением для таких удобных делителей реализуется с помощью простого умножения и сдвига, а для отрицательных чисел добавляется поправка +1. В результате получаем пять нулевых значений, расположенных вокруг начала координат.
Но мы здесь не ради деления с усечением… Поэтому забудьте об этом графике!
Как бы то ни было, если мы используем множитель с округлением вниз:
Сырой 64-битный mul-shift: «псевдоделение на 3» (множитель с округлением вниз)
Дано: x — целое 64-битное число со знаком
i64 M = u64(-1) / 3 i64 y = (i128) x * M >> 64…то получим противоположный результат: в отрицательном направлении последовательность идеальна, а в положительном направлении имеется нарушенная группа из четырёх значений — от 0 до 3 (все положительные значения сдвигаются вправо):
Округление вниз:

Оказывается, 3 — очень гибкий делитель. Пока вам придётся просто поверить мне на слово, что в 64-битном варианте удобная половина каждого из этих наборов сохраняет свою закономерность во всём диапазоне знаковых 64-битных чисел.
Решение здесь простое: можно использовать разные множители для положительных и отрицательных чисел:
Деление на 3 с округлением вниз (множитель выбирается по знаку)
Дано: x — целое 64-битное число со знаком
i64 M = MAX_U64 / 3 + 1i64 m = M + (x >> 63) // = x > 64Округление в зависимости от знака:

Теперь всё чётко в обоих направлениях.
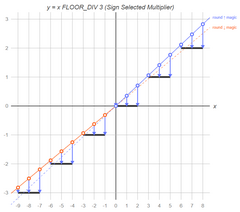
Это идеальный вариант, поскольку значение M + (x >> 63) можно вычислить очень просто и эффективно. Для этого не требуется ни дополнительная материализация константы, ни преобразование флага в регистр. На процессорах ARM64 его можно вычислить одной ассемблерной командой, сочетающей сложение и сдвиг (add x0, x1, x2, asr #63).
GCC хорошо компилирует такой код, однако в моих тестовых циклах Clang, похоже, допускает небольшую ошибку при оптимизации. В C++ можно заставить Clang генерировать более эффективный код, добавив после второй строки конструкцию asm("" : "+r"(m));. Она не позволяет компилятору доказать, что m >= 0, и тем самым исправляет неудачную оптимизацию.
Примечание: чтобы добиться максимальной производительности алгоритма Робисона, в тестах также пришлось прибегнуть к аналогичным трюкам с ассемблером.
Однако это не единственный способ реализации. Для деления на 3 с округлением вниз есть ещё два варианта:
-
Использовать значение
M, округлённое вверх, и увеличиватьxдля всех значений меньше-1. -
Использовать значение
M, округлённое вниз, и увеличиватьxдля всех значений из диапазона0 <= x < MAX_INT64(положительное «инкрементирование с насыщением»).
Деление на 3 с округлением вниз: поправка для отрицательных чисел (x < -1)
Дано: x — целое 64-битное число со знаком
i64 M = MAX_U64 / 3 + 1 // Округление M вверхi64 t = x + (x > 64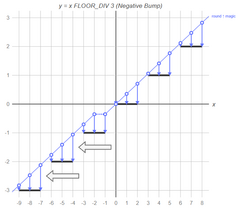
Деление на 3 с округлением вниз: поправка для положительных чисел (0 <= x < MAX_INT64)
Дано: x — целое 64-битное число со знаком
i64 M = MAX_U64 / 3 // Округление M внизi64 t = x + (u64(x) > 64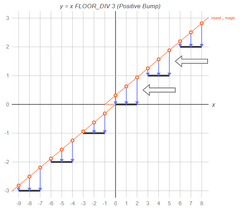
В первом случае не нужно корректировать x = -1, поскольку это приведёт к неправильному результату: y = 0. Во втором случае не нужно корректировать x = MAX_INT64, поскольку это вызовет переполнение. Причина, по которой нам не требуется увеличивать x = MAX_INT64 (x = 2^63-1), заключается в следующем: для любого делителя d, не являющегося степенью двойки, (2^63-1) FLOOR_DIV d=(2^63) FLOOR_DIV d. Эти результаты различались бы только в том случае, если бы 2^63 делилось на d без остатка. Но это очевидным образом невозможно, поскольку все простые множители числа 2^63 — это двойки. Однако это тождество справедливо для точного деления, а множитель с округлением вниз даёт лишь приближённый результат. Если бы d было делителем числа 2^63-1, то пропуск инкремента оставил бы INT_MAX кратным d, но из-за небольшого смещения вниз результат оказался бы на единицу меньше правильного. В данном случае такими делителями можно пренебречь только потому, что проверка INT_MIN (см. раздел «Реализация») уже исключает их при сдвигах на величину, соответствующую разрядности регистра. По той же причине при быстром делении беззнаковых чисел на некоторые делители используется инкрементирование с насыщением (см. ridiculousfish / libdivide).
К счастью, обе границы для второго подхода можно реализовать с помощью приведения типа к знаковому и всего одного сравнения. Обе константы (-1 и 0x7FFFFFFFFFFFFFFF) также можно материализовать одной командой ARM благодаря повторяющемуся битовому шаблону. В плотном цикле такие константы обычно загружаются один раз, за его пределами.
Но зачем вообще обо всём этом говорить, если случай с 3 мы уже разобрали? Дело в том, что не все делители настолько гибкие, как 3.
Все целочисленные делители, не являющиеся степенями двойки, делятся на два частично пересекающихся множества:
-
те, для которых можно использовать округление вверх + поправку для отрицательных чисел;
-
те, для которых можно использовать округление вниз + поправку для положительных чисел.
Делители, подходящие для обоих вариантов, позволяют использовать реализацию с выбором множителя по знаку числа.
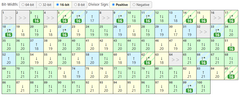
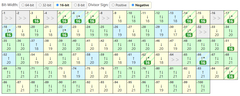
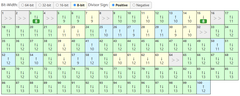
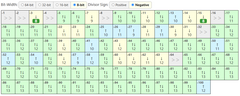
Под спойлером показаны первые 100 делителей и выбранный для каждого из них метод. Паттерн выглядит довольно хаотичным, но его легко вычислить на этапе компиляции:
-
«>>» — тривиальный случай деления на степень двойки.
-
«↑» — множитель с округлением вверх (с поправкой для отрицательных чисел).
-
«↓» — множитель с округлением вниз (с поправкой для положительных чисел).
-
«↑↓» — множитель, выбираемый в зависимости от знака числа.
-
«↑*» и «↓*» — вариант с выбором множителя работает при большей величине сдвига, но определённое направление округления позволяет обойтись сдвигом на величину, соответствующую разрядности регистра (для 8-битных чисел этот вариант отключён).
Число под обозначением указывает величину сдвига. Если она соответствует разрядности регистра, число выделено цветом.
Скрытый текст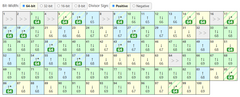
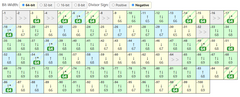
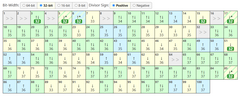
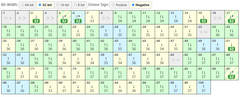
Ой, у нас появились отрицательные делители, о которых мы пока ничего не говорили…
Отрицательные делители
Всё, что мы рассмотрели, точно так же работает и с отрицательными делителями. Просто нужно внимательно следить за знаками, условиями сравнения и прочими подобными вещами.
Далее я буду называть множителями с «округлением вниз» те, которые округляют результат в сторону нуля, а множителями с «округлением вверх» — те, которые округляют его от нуля.
Делитель -3 оказался негибким: для него требуется «округление вниз». А вот -5 допускает оба варианта при сдвиге на 65 бит:
Деление на -5 с округлением вниз: множитель выбирается по знаку числа
Дано: x — целое 64-битное число со знаком
i64 M = -((i128(1) <> 63) // = x > 65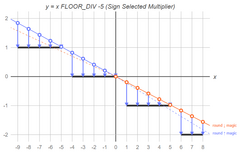
Ниже представлены два альтернативных решения для -5:
Деление на -5 с округлением вниз: положительный декремент (x > 1)
Дано: x — целое 64-битное число со знаком
i64 M = -((i128(1) < 1)i64 y = (i128)t * M >> 65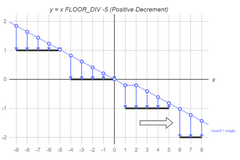
Деление на -5 с округлением вниз: отрицательный декремент (MIN_INT64 < x < 0)
Дано: x — целое 64-битное число со знаком
i64 M = -(MAX_U64 / 5) // Округление M "вниз"i64 t = x - (u64(x) > (1 <> 64Примечание: этот вариант работает с чистым 64-битным сдвигом
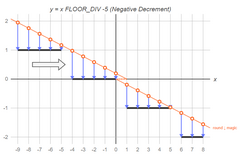
Член (1 << 63) можно также записать как 0x8000000000000000.
Быстрое вычисление остатка от деления с округлением вниз и евклидово деление
Остаток от деления с округлением вниз естественным образом получается из деления с округлением вниз и для положительных делителей всегда даёт неотрицательный остаток:
Общее тождество для остатка от деления с округлением вниз
const int64_t pos_mod = x - fast_floor_div(x) * DivisorДля делителей вида  у меня есть более быстрая альтернатива, в которой применяется сложение со сдвигом и маскированием (add-shift-mask):
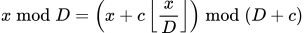
Подробнее об этом тождестве см. в статьях о днях недели и времени суток.
Евклидово деление совпадает с делением с округлением вниз для положительных делителей.
Для делителей меньше -1 можно использовать следующее тождество. Оно требует всего одного дополнительного такта для последующего изменения знака (первое изменение знака при вызове floor_div выполняется на этапе компиляции).
В некоторых случаях второе изменение знака во время выполнения можно «бесплатно» совместить с последующими операциями, например при вычислении евклидова остатка:
Евклидово деление и вычисление остатка при отрицательных делителях
const i64 floor_div = fast_floor_div(x) // Изменение знака делителяconst i64 euc_div = -floor_divconst u64 euc_mod = x + floor_div * DivisorРеализация
Простота приведённых выше функций достигается за счёт дополнительной сложности вычислений на этапе компиляции: необходимо подобрать константы и вариант реализации. Однако компиляция при этом проходит быстро.
По сути, алгоритм сводится к последовательной проверке наихудшего случая для вариантов с округлением вверх и вниз, начиная с идеального сдвига на величину, соответствующую размеру регистра  . Решение считается допустимым, если оно проходит проверку для числителя, соответствующего наихудшему случаю. Например:
-
для варианта с округлением вверх — наибольший числитель, равный
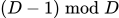
-
для варианта с округлением вниз — наибольший числитель, равный

Здесь важна одна деталь: наихудший случай для варианта с округлением вниз — это INT_MIN. Произведение при этом не должно быть целым числом, иначе результат окажется на единицу больше правильного. Это происходит ровно в тех случаях, когда  делит
 (для 64-битных чисел: 7, 49, 73, 127, 337, 511, …).
Для таких делителей, если записать 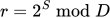 , то
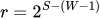 при любом сдвиге на величину, соответствующую размеру регистра. Поэтому вариант с округлением вниз никогда не проходит проверку, и приходится использовать округление вверх. (Для отрицательных делителей всё наоборот: произведение при округлении вверх может оказаться целым числом, если |D| делит
 . Для 64-битных чисел: 3, 9, 19, 27, 43, 57, …)
Если решения найдены для обоих вариантов, то будет работать и вариант с выбором множителя по знаку числа. При этом величина сдвига должна быть равна большему из двух найденных значений.
Мои бенчмарки (для 64-битных чисел) показывают, что в большинстве случаев быстрее всего выбирать вариант с учётом знака числа. Однако есть несколько редких исключений:
-
Если для варианта с округлением вниз найден идеальный сдвиг на 64 бита, а для варианта с выбором множителя по знаку нет, то вариант с округлением вниз быстрее во всех случаях.
-
Если для варианта с округлением вверх найден идеальный сдвиг на 64 бита, а для варианта с выбором множителя по знаку нет, то на ARM быстрее вариант с округлением вверх, а на x86 он либо работает с той же скоростью, либо медленнее.
На x86 вариант с округлением вверх уступает варианту с выбором множителя по знаку, поскольку для вычисления поправки в нём используется знаковое сравнение (x < -1). Результат знакового сравнения не сохраняется во флаге переноса, поэтому компилятору приходится генерировать последовательность cmp → setl → add. Это на одну команду больше, чем в варианте с округлением вниз (cmp → adc), и дополнительный такт нивелирует выигрыш от отсутствия лишнего сдвига. На Mac с процессором Intel оба варианта показали одинаковую производительность, но на процессоре AMD вариант с выбором множителя по знаку числа оказался быстрее. Поэтому в моих бенчмарках и эталонной реализации для x86 выбор варианта изменён с учётом этого обстоятельства.
Упомянутые выше исключения (сдвиги на величину, соответствующую разрядности регистра) встречаются довольно часто среди небольших делителей, например 5, 6, 9, 14 и т. д. Однако среди всех возможных 64-битных делителей их доля ничтожно мала. На приведённой ниже диаграмме Венна показано распределение делителей. Эта небольшая группа отмечена в правом нижнем углу.
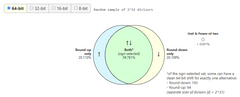
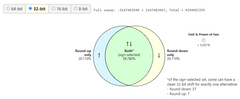
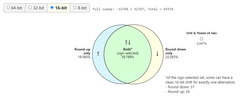
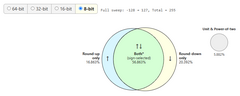
Задача определения того, какой вариант подходит для заданного делителя, сводится к той же задаче, что и поиск беззнакового делителя для разрядности на один бит меньше обычной, то есть 63, 31, 15 или 7. Об этой задаче уже достаточно подробно писали другие авторы, поэтому я не хотел бы задерживаться на ней. Гораздо важнее доказать, что решение, работающее для положительных чисел, будет работать и для отрицательных. Эта тема хорошо изучена (см. Приложение A — Доказательство).
«Когда дело касается знакового деления с округлением вниз, нет ни сговорчивых, ни несговорчивых делителей, лишь эти единые делители.» — Барак Обама, 2004 год, Национальный съезд Демократической партии
Никогда не пишите собственный алгоритм быстрого деления с округлением вниз
Впрочем, никто не запрещает вам это сделать, но обязательно тщательно протестируйте свой алгоритм. Иначе вы рискуете получить ошибку, подобную той, что была допущена в Google TensorFlow.
Если вам интересно, можете посмотреть исходный код и самостоятельно попытаться разобраться, что в нём было не так.
В исходном коде используются шаблоны, но ниже я привёл более простой вариант псевдокода для 64-битных чисел.
У этой реализации есть два недостатка, если использовать её для деления на константы, известные на этапе компиляции. Один связан с ошибкой, другой — с производительностью.
1. Производительность. Поскольку ветвление if/else зависит и от x, и от y, а формулы в обеих ветвях существенно различаются, компилятор обычно не сможет преобразовать этот код в реализацию без ветвления для делителя с заданным знаком.
2. Но что гораздо важнее — здесь есть ошибка, связанная с переполнением! Выражение abs_x + abs_y - 1 может выйти за пределы диапазона знаковых 64-битных чисел при многих входных значениях, близких к предельным.
Версия TensorFlow 2021 года (эквивалент в псевдокоде)
Дано: x, y — целые 64-битные числа со знаком
if ((x < 0) != (y < 0)) { const i64 abs_x = abs(x) const i64 abs_y = abs(y) return -(abs_x + abs_y - 1) / abs_y} else { return x / y}Ошибочная реализация функции деления с округлением вниз присутствовала в версии 1.0, выпущенной в феврале 2017 года. Этот баг оставался в коде более четырёх лет и был устранён только в мае 2021 года.
Я ни в коем случае не хочу критиковать автора: здесь действительно легко допустить ошибку. Главная причина, по которой я решил обратить на это внимание, — показать, насколько просто ошибиться даже в зрелом проекте с большой кодовой базой, прошедшей множество проверок. И это ещё один веский довод в пользу того, чтобы языки программирования и стандартные библиотеки предоставляли такую функцию изначально.
Один из способов избежать переполнения — поступать так же, как в CPython: использовать беззнаковые целые числа и выносить слагаемое abs_y за скобки. Впрочем, даже это решение может создавать проблемы при INT_MIN.
Такой подход в основном устраняет ошибку, но, раз уж вы дочитали до этого места, то, вероятно, уже знаете несколько более быстрых способов реализации.
Деление с округлением вниз в CPython (эквивалент в псевдокоде)
Дано: x, y — целые числа со знаком
// Примечание: в CPython эта функция вызывается только тогда,// когда x и y оба не равны нулю.// Для данного примера добавлена дополнительная проверка x != 0.if (x != 0 && (x < 0) != (y < 0)) { const u64 abs_x = abs(x) const u64 abs_y = abs(y) return -1 - (abs_x - 1) / abs_y} else { return x / y}Бенчмарки
Тесты, использованные для проверки функций, рассмотренных в этой статье, можно найти в коде тестовых примеров: https://github.com/benjoffe/fastdiv.
В том же репозитории находятся бенчмарки. Самостоятельно их можно запустить следующим образом:
git clone https://github.com/benjoffe/fast-floordiv.gitcd fast-floordivcmake -B build -DCMAKE_BUILD_TYPE=Releasecmake --build build -j./build/bin/div_bench -batch=8./build/bin/div_bench -latencyБенчмарки выполняются для всех делителей, не являющихся степенями двойки, в диапазоне от -2^4 до 2^5, а также для нескольких специально отобранных больших положительных делителей: 100, 360, 86400, 105, 107, 86400000 и 108. Причина такого выбора подробно объясняется ниже, в разделе, посвящённом x86.
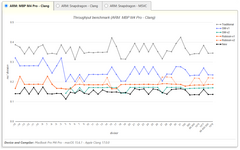
На графиках по оси X отложены различные делители, а по оси Y — время одного деления в наносекундах (чем меньше значение, тем выше скорость).
Все результаты получены при запуске бенчмарков с параметром -repeat=10 и записью медианных значений.
Команда -batch=8 заставляет процессор выполнять деление на каждый делитель восемь раз, прежде чем загружать из памяти следующую запись. Это позволяет избежать ситуации, когда производительность ограничивается скоростью доступа к памяти.
Для измерения задержки (latency) используется та же команда, но параметр -batch заменяется на -latency. В этом режиме результат каждого вычисления передаётся в качестве входных данных для следующего деления, поэтому распараллеливание невозможно.
Чтобы не делать эту статью слишком большой, я сгруппировал результаты бенчмарков по типу процессора (ARM, x86) и типу измерений (пропускная способность, задержки).
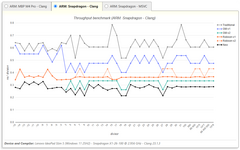
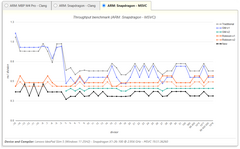
Пропускная способность на ARM
В Clang алгоритм New обеспечивает наибольшую пропускную способность для всех делителей и в отдельных случаях делит первое место с gm-v2. Самые быстрые альтернативы — gm-v2 для положительных делителей и Robison для отрицательных. Похоже, MSVC генерирует неоптимальный ассемблерный код для отрицательных делителей при использовании некоторых алгоритмов.
 Задержки на ARM
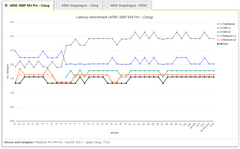
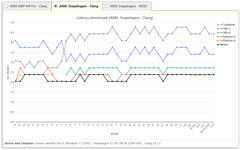
Для задержек мы получаем схожие результаты: алгоритм New имеет наилучшие показатели или делит первое место.
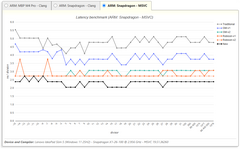 Пропускная способность на x86
С процессорами x86 ситуация более неоднозначная.
По пропускной способности лидирующий алгоритм меняется между Robison и New.
Иногда наравне с ними по скорости оказывается gm-v2 (например, при делении на 6 и 9).
Наверно, теперь понятно, зачем были специально отобраны некоторые большие делители: они показывают, что для ряда практически полезных делителей алгоритм New обеспечивает хорошую производительность.
В случаях, когда алгоритм New не оказывается самым быстрым, прослеживается чёткая закономерность:
-
Положительные делители:
7, 11, 13, 22, 26, 29. Все они допускают только округление вверх (таких делителей около 20% от всех возможных положительных 64-битных делителей). -
Отрицательные делители:
-3, -5, -9, -11, -13, -15. Для этих делителей не используется выбор множителя по знаку числа, хотя алгоритм Робисона хорошо с ними работает (таких делителей около 40% от всех возможных отрицательных 64-битных делителей).
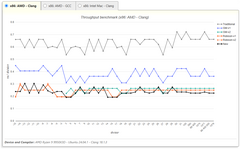
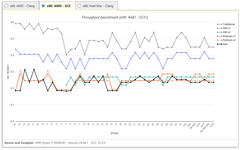
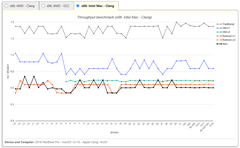 Задержки на x86
Именно при измерении задержек на x86 начинает проявляться явный лидер. Если раньше результаты сильно колебались, то теперь Robison оказывается быстрее практически для всех делителей. В редких случаях алгоритм New, похоже, выигрывает и по пропускной способности, и по задержке. Так происходит, например, при делении на 14, -7 и -14 (округление вниз со сдвигом на 64 бита).
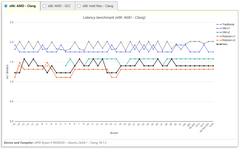
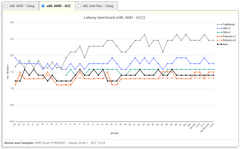
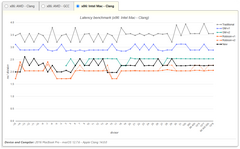
В заключение отмечу, что если вам требуется вычислять остаток от деления, разрыв в производительности между «традиционными» и более быстрыми алгоритмами сократится, но последние всё равно останутся быстрее. Я бы хотел когда-нибудь всё-таки закончить эту статью, поэтому пропущу эти бенчмарки.
Какой алгоритм стоит использовать?
Следующие рекомендации могут быть полезны тем, кто собирается создавать быструю библиотеку для деления с округлением вниз или добавлять такую фичу в язык программирования/компилятор:
-
В целом я бы рекомендовал использовать алгоритм
Robisonдля 8-, 16- и 32-битных чисел. -
Если вы не стремитесь выжать из реализации абсолютно максимум производительности,
Robisonтакже отлично подходит для 64-битных чисел. Кроме того, использование единственной реализации позволит сделать код проще. -
Если же вас интересует оптимизация, то для всех 64-битных случаев на ARM идеальным выбором будет алгоритм
New: по всем показателям он либо превосходит остальные, либо не уступает им. -
Для 64-битных чисел на x86 выбор несколько сложнее:
-
Вполне разумно будет продолжать использовать алгоритм
New: большую часть времени он выигрывает по пропускной способности, а результаты тестов остаются воспроизводимыми на разных платформах. -
Стоит рассмотреть и использование
Robisonна x86: он по-прежнему довольно часто оказывается быстрее и обеспечивает меньшую задержку. -
Наконец, библиотека с агрессивной оптимизацией, нацеленная на максимальную пропускную способность, может использовать
Newна x86 только в тех случаях, когда он показал преимущество по этому показателю: для положительных делителей — с выбором множителя по знаку числа и с округлением вниз, а для отрицательных делителей — по аналогичному принципу. Впрочем, это уже довольно агрессивный уровень оптимизации, и вам решать, оправдан ли он.
-
-
Я не тестировал реализацию на 32-битных процессорах, но полагаю, что
Robisonсохранит преимущество на 32-битных ARM благодаря инструкции умножения с накоплением (именно наличие инструкций такого типа послужило одной из причин появления исходной научной работы). Для 32-битных x86, возможно, стоит принять решение по аналогии с 64-битными x86, хотя сегодня эта платформа, вероятно, уже не так важна.
Стоит также отметить ещё два момента:
-
Мне не удалось легко добиться оптимальной работы алгоритма
Robisonна C++ для всех 64-битных делителей на разных платформах. Именно поэтому в бенчмарках используются две разные реализации. Чтобы получить идеальный результат, возможно, потребуется писать ассемблерный код напрямую или применять отдельную логику для каждой платформы. -
Выигрыш в производительности от автоматической векторизации кода с использованием алгоритма
Newна ARM-процессорах с поддержкой SIMD SVE2 может оказаться выше, чем показывают бенчмарки. Дело в том, что в этом наборе SIMD-инструкций есть встроенная команда, которая позволяет получить старшие 64 бита результата умножения двух 64-битных чисел без расширения разрядности. В таких случаях алгоритмRobisonможет потребовать расширения разрядности элементов вектора или помешать компилятору выполнить автоматическую векторизацию. К сожалению, у меня нет возможности регулярно пользоваться таким компьютером, поэтому проверить это самостоятельно мне не удалось. В общем, оптимизацию SIMD я оставляю читателю в качестве упражнения.
Опенсорсная реализация
Представленный в этом посте алгоритм New использован в следующих опенсорсных проектах:
Проект
Ссылка на пул-реквест и имя автора
Цитаты из пул-реквеста
Modular (компилятор Mojo)
abduld
«Среднее геометрическое ускорение операции x // d с постоянным делителем составляет от 1,26 до 2,46 раза в зависимости от процессора или графического ускорителя. При этом для отдельных делителей ускорение может варьироваться от отсутствующего до значительно превышающего эти значения».
«Точный результат во всём диапазоне знаковых чисел разрядностью от 8 до 64 бит».
Если вам показалась интересной эта статья, возможно, вам понравятся и две следующие недавние публикации в блоге. В обеих рассматривается новый приём для ускорения вычисления неотрицательного остатка от деления на делители вида 2^A - 2^B (например, 12, 24, 60 и т. д.). Его стоит рассмотреть для включения в любую библиотеку, которая поддерживает и деление с округлением вниз, и вычисление неотрицательного остатка от деления.
Также см. другие статьи об оптимизации:
-
Faster day-of-week functions
-
Faster time-of-day functions
Приложение A — Доказательство
Положительный делитель, неотрицательный х.
При  значение
 — это просто беззнаковое
 -битное число, поэтому беззнаковые результаты (Granlund–Montgomery, ridiculousfish) применяются непосредственно с
 . Либо множитель с округлением вверх
 работает напрямую, либо множитель с округлением вниз
 работает с инкрементированием. По крайней мере один из этих двух вариантов всегда подходит при использовании
 -битного множителя и величине сдвига не более:
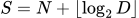
При записи  для беззнакового
 -битного входного
n оба варианта оказываются строго между  и
 при
0″ alt=»n>0″ src=»https://habrastorage.org/extt/66/7a/5d/667a5de5b020699ad7baa6ef79700a8a.svg» width=»46″ height=»13″ data-width=»5.506″ data-height=»1.597″ data-vertical-align=»-0.09″ style=»width: 5.506ex; height: 1.597ex; vertical-align: -0.09ex» sizes=»(max-width: 780px) 100vw, 50vw» srcset=»https://habrastorage.org/extt/66/7a/5d/667a5de5b020699ad7baa6ef79700a8a.svg 780w, https://habrastorage.org/extt/66/7a/5d/667a5de5b020699ad7baa6ef79700a8a.svg 781w» loading=»lazy» decode=»async»>:
<img class="formula" source="q ;<; frac{n cdot M}{2^S} ;<; q+1, qquad q ;<; frac{(n+1) cdot M'}{2^S} ; 0)» alt=»q ;<; frac{n cdot M}{2^S} ;<; q+1, qquad q ;<; frac{(n+1) cdot M'}{2^S} ; 0)» src=»https://habrastorage.org/getpro/habr/formulas/7/79/79f/79f00d82083a5e5c37214ee77b9577b8.svg» width=»524″ height=»40″ data-width=»65.516″ data-height=»5.015″ data-vertical-align=»-1.942″ style=»width: 65.516ex; height: 5.015ex; vertical-align: -1.942ex» sizes=»(max-width: 780px) 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/7/79/79f/79f00d82083a5e5c37214ee77b9577b8.svg 780w, https://habrastorage.org/getpro/habr/formulas/7/79/79f/79f00d82083a5e5c37214ee77b9577b8.svg 781w» loading=»lazy» decode=»async»>
Эти неравенства строгие (не ≤), и это обязательное требование. То, что  не является степенью двойки, говорит лишь о том, что ни один из множителей не равен в точности
 . Для округления вверх строгое неравенство в таком случае следует из ограничения. Для округления вниз произведение при
 становится в точности равным
 , когда выполняется
 , поскольку для таких делителей
 при любом сдвиге на величину, соответствующую разрядности регистра. Алгоритм подбора отвергает для них округление вниз, что вынуждает использовать округление вверх.
Если говорить проще, при таких умножениях со сдвигом (mul-shift) результат постепенно «отклоняется» от истинного отношения. За исключением случая x=0, слагаемые без округления никогда не бывают целыми числами (это гарантирует приведённая выше проверка).
Я обращаю на это внимание потому, что далее мы воспользуемся следующим тождеством, которое опирается именно на это свойство:

Отрицательный х.
Пусть 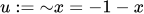 . Побитовое НЕ взаимно однозначно отображает отрицательные числа в диапазон
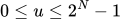 , то есть именно в тот диапазон, в котором выше изменяется
 . Кроме того, выполняется следующее равенство:
0)» alt=»leftlfloor frac{x}{D} rightrfloor = -1 — leftlfloor frac{u}{D} rightrfloor qquad (D > 0)» src=»https://habrastorage.org/getpro/habr/formulas/a/a6/a60/a603d64d193b0c9fa9215f5c0903570d.svg» width=»252″ height=»33″ data-width=»31.497″ data-height=»4.153″ data-vertical-align=»-1.511″ style=»width: 31.497ex; height: 4.153ex; vertical-align: -1.511ex» sizes=»(max-width: 780px) 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/a/a6/a60/a603d64d193b0c9fa9215f5c0903570d.svg 780w, https://habrastorage.org/getpro/habr/formulas/a/a6/a60/a603d64d193b0c9fa9215f5c0903570d.svg 781w» loading=»lazy» decode=»async»>
В сочетании со стандартным свойством округления вниз и смены знака (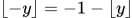 для нецелого
 ) это позволяет обосновать каждый из вариантов поправки:
-
Округление вверх,
 . Здесь
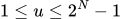 , то есть значения полностью попадают в рассмотренный выше диапазон строгого неравенства. Кроме того,
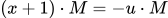 , поэтому:
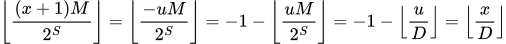
-
Округление вверх,
 . Этот случай не подпадает под рассмотренное выше условие (здесь
 , что выходит за пределы диапазона строгого неравенства). Именно поэтому для него пропускается поправка и вместо этого используется обычное умножение без поправки
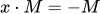 . Поскольку
 : <img class="formula inline" source="M = lceil 2^S/D rceil le 2^S/3 + 1 < 2^S" alt="M = lceil 2^S/D rceil le 2^S/3 + 1 , следовательно,
 строго лежит в интервале
 , откуда
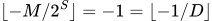 .
-
Округление вниз,
 . Здесь
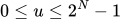 — это весь диапазон беззнаковых значений, никаких исключений не требуется, поскольку для варианта с инкрементированием приведённое выше ограничение требует лишь, чтобы
 , а это выполняется для любого
 . Поскольку
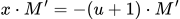 :
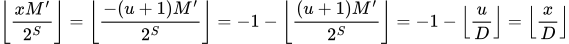
При
x = INT_MINтребуется выполнить инкрементирование при без насыщения, а для применения тождества смены знака необходимо, чтобы
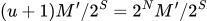 не было целым числом. С учётом ограничения для беззнакового варианта с округлением вниз,
 , это число может быть целым только в случае, когда
 и
 . Тогда произведение в точности равно
 , поэтому для таких делителей округление вниз использовать нельзя. Именно это же исключение позволяет безопасно пропускать инкрементирование при
INT_MAXв варианте с насыщением.
Таким образом, какой бы вариант округления ни подходил для беззнакового (W-1)-битного деления, он будет работать и во всём диапазоне знаковых  -битных чисел — с теми же множителем и величиной сдвига.
Выбор множителя по знаку числа. Этот вариант использует половину диапазона без поправки для округления вверх и половину без поправки для округления вниз. Поэтому он работает при любой величине сдвига, для которой подходят оба варианта округления. Если вариант округления работает при некоторой величине сдвига, то он будет работать и при больших значениях сдвига. Следовательно, достаточно, чтобы каждый из двух вариантов подходил хотя бы при одном значении сдвига в пределах разрядности  -битного множителя.
Отрицательные делители.
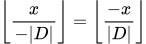
Таким образом, это та же задача, что и для положительных делителей, только применённая к  . Разница лишь в диапазоне значений:
 изменяется от
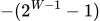 до
 . В неотрицательной части на одно значение больше, чем допускает разрядность
 бит (это значение соответствует
INT_MIN), а в отрицательной — на одно меньше. Именно это дополнительное значение позволяет произведению при округлении вверх оказаться целым числом. Так происходит для  , поэтому для таких делителей округление вверх использовать нельзя. Недостающее значение с другой стороны диапазона — то самое, из-за которого округление вниз было запрещено для
 . Для отрицательных делителей это ограничение исчезает. Именно поэтому в эталонной реализации границы диапазона корректируются в зависимости от знака делителя.
Источник: habr.com