
Цикл «Docs-as-code на максималках»:
Фундамент: Архитектура и видение проекта
Публикация: Пайплайн Markdown → Confluence ← вы здесь
Рабочее место: Obsidian как IDE для аналитика
Правила игры: Workflow и обратная совместимость
AI-агент: На пути к вайбаналитингу
В прошлой части мы договорились о распределении ответственности: Git — мастер-система для хранения документации, Confluence — витрина для чтения. Теперь собираем движок, который перенесет md-файлы в страницы Confluence.
Постановка задачи
На первый взгляд интеграция выглядит простой: аналитик пушит .md в репозиторий и страница сама появляется в Confluence, без дополнительных приседаний.
Между этими двумя точками стоит CI-пайплайн, который:
-
поднимает окружение с Node.js
-
находит все добавленные/измененные md-файлы
-
рендерит их в нативный ADF-формат Confluence
-
публикует через Confluence API
-
Проставляет ограничения на редактирование созданных страниц
Звучит просто, но дьявол, как обычно, в деталях.
Поиск решений
Ремарка: поиск производился в начале 2024го года, возможно за это время появились какие-нибудь новые качественные проекты. Если кто-то подскажет альтернативы, буду только рад.
Первое, что мы подумали: нет смысла изобретать велосипед и пошли искать готовое решение на просторах GitHub.
И ничего полностью готового не нашли.
-
Есть неплохой конвертер на базе markdown-it, но он умеет переносить одну отдельно взятую Markdown-страницу в ADF-формат Confluence
-
Есть движки типа MkDocs, которые предназначены для генерации html-сайтов. В Confluence они публиковать не умеют, и все дерево страниц нужно описывать вручную в yml-файле, что для docs-as-code не очень удобно (легко что-то забыть, и каждое изменение гарантированно приводит к конфликтам при мерже веток)
-
В GitHub нашелся один отдаленно похожий на то, что нам нужно проект
Workable/confluence-docs-as-code. Он как раз работал на базе markdown-it и MkDocs, но требовал глубоких доработок. Поэтому стратегия стала такой: берем его за основу и доводим до готовности
Главное, что пришлось доделать:
-
вынести логику за пределы GitHub Actions в универсальный pipeline (у нас Bitbucket)
-
механизм поиска измененного контента по репозиторию — вместо ручного перечисления страниц в yml
-
ограничение на редактирование созданных в Confluence страниц + обратные ссылки на исходник
-
проверку дубликатов названий страниц
-
режим публикации постановок задач (Task Publishing) — об этом дальше будет рассказано подробнее
-
визуальный diff на отрендеренных в Confluence страницах, чтобы видеть изменения, сделанные в рамках Pull Request
Модель публикации документации
Между Confluence и Bitbucket существует некоторая разница, которую необходимо учитывать.
Git-репозиторий это не просто хранилище документов, это работа с ветками, pull requests, логика работы с ними.
В Confluence всего этого нет, и надо придумать принципы отображения из одной системы в другую.
Есть одна зацепка, которая может помочь: обычно для работы используют определенную модель ветвления (у нас немного модифицированный GitHub Flow), что накладывает существенные ограничения на работу с ветками (одна master-ветка и отдельная ветка на каждую задачу и PR на их слияние).
Если немного абстрагироваться, Pull Request это дельта между текущим состоянием системы (AS IS) и целевым (TO BE). А если мы говорим про спецификации, то эта дельта и есть постановка задачи на разработку. То есть одни и те же .md-файлы (с некоторыми допущениями) могут одновременно являться и документацией и техническим заданием.
Таким образом:
-
Аналитика по задаче начинается раньше разработки — PR открывается в начале жизненного цикла задачи
-
PR — это постановка задачи на разработку
-
Мерж в master происходит после релиза — PR получается долгоживущим
-
master-ветка с документацией соответствует состоянию системы в production
Поскольку нам из всего этого нужны документация и постановка задачи, то пайплайнов нужно два:
Pipeline 1. Merge в master → полная документация
Логически самый простой. При любом изменении в master делаем lookup всех Markdown-файлов в репозитории, строим из них дерево и переносим это же дерево в основное пространство Confluence:
-
создаем страницы, которых не было
-
обновляем изменившиеся
-
не трогаем нетронутые
Таким образом получаем проекцию master-ветки в основное пространство с документацией в Confluence.
Pipeline 2. Pull Request → постановка задачи
Допуская, что названия веток строго соответствуют задачам, каждый PR можно спроецировать в задачу в Jira.
Однако в Jira довольно сложно публиковать документацию напрямую:
-
Размерность полей ограничена 32 767 символами. Зачастую не хватает
-
Внутренний формат для Jira сильно отличается от Confluence. Не в лучшую сторону.
-
Разметка в Confluence богаче. Публикуя в Jira мы лишаемся части функциональности.
Решение, которое мы имплементировали:
-
В Confluence заводим отдельное пространство, которое назовем Task Descriptions.
-
Ограничиваем в нем глубину вложенности двумя уровнями:
-
первый уровень: страница, связанная 1-к-1 с задачей в Jira (ее название = ключу задачи);
-
второй уровень: все измененные в рамках этой задачи страницы спецификации.
-
-
По Pull Request пайплайн отображает все содержимое PR в эту «плоскую» структуру, с визуальным diff. Прямо на отрендеренной странице цветом подсвечивается, что добавилось и что удалилось. При этом:
-
Каждая страница получает префикс в виде ключа задачи — для того чтобы название страницы оставалось уникальным в пределах пространства
-
Относительные ссылки резолвятся исходя из того, была затронута страница по ссылке в данной ветке. Если да, то ссылка ведет на соседнюю страницу в том же пространстве, относящуюся к той же задаче. Если нет, то в основное пространство с документацией.
-
-
Группирующую страницу первого уровня тоже храним в репозитории (в отдельном каталоге
tasks/), туда складываем дополнительный контекст задачи. -
Финально связываем группирующую страницу с задачей в Jira через фрейм, так что постановка видна прямо в интерфейсе работы с задачей.
«Плоский вид» это как в самом PR: исходно .md-файлы образуют дерево большой глубины, а в рамках одной задачи такая глубина избыточна. Поэтому мы раскладываем все измененные страницы на одном уровне под страницей задачи.
В итоге мы получаем проекцию Pull Request из Bitbucket в Confluence и Jira. Она слегка усеченная, но вполне достаточная для чтения и ревью. И все артефакты появляются в Confluence и Jira сами, без ручной публикации.
Отдельно про lookup страниц в репозитории
Как оказалось, это тоже не такая простая задача.
-
В файловой системе вы обычно оперируете файлами и каталогами для их группировки. В репозитории все то же самое, а вот с Confluence есть проблема — там нет каталогов (точнее есть, но появились совсем недавно и только в новых версиях, которые не всем доступны).
-
В Confluence имя страницы — это уникальный ключ в рамках пространства, чего нет в файловой системе.
-
В файловых системах есть ограничения по используемым символам в названии файла (весьма противные ограничения).
Динамически отобразить каталоги+файлы в дерево страниц Confluence можно несколькими способами (режимы публикации):
-
HTML_LIKE — в каждой папке страница index.md заменяет собой каталог, в котором она находится
-
SAME_DIR_FILE_NAME — md-файл, совпадающий с названием каталога на том же уровне, заменяет его при публикации
-
USE_FOLDERS — использовать новые возможности Confluence (cloud версия) и публиковать файлы+каталоги в том же виде, в котором они хранятся в файловой системе
Уникальность названий страниц несложно проверять внутри пайплайнов.
А вот со спецсимволами иногда бывает тяжело. Например, слэши почти во всех популярных файловых системах запрещены и файл с названием «GET /users.md» создать не получится.
Чтобы решить эту проблему, мы добавили поддержку YAML Frontmatter. После этого у каждой страницы в шапке можно указать дополнительные метаданные файла, где указать имя страницы, куда будет публиковаться данный .md-файл.
---title: GET /users---Параметр при этом опциональный, и если он не указан, то страница будет создана по имени самого файла (без расширения .md). Кириллические названия использовать также допускается.
По мере эволюции мы также реализовали поддержку следующих параметров:
-
titleпереопределить заголовок страницы в Confluence (по умолчанию берется имя файла) -
pageWidthширина страницы -
tablesWidthширина таблиц на странице -
enableDiffвключать ли визуальный diff при отображении PR в Confluence (по умолчаниюtrue). При включенном параметре страницы в ветке задачи сравниваются со страницами в master (или параметреbranchTo), и все изменения подсвечиваются в Confluence цветами (красным и зеленым). -
branchTo: ветка, с которой строить diff (по умолчаниюmaster)
Имплементация CI-конвейера
Минимальный каркас bitbucket-pipelines.yml выглядит примерно так (образ с Node.js, внутри запускается приложение-интегратор):
image: node:24pipelines: branches: master: - step: name: Publish full documentation script: - node integration-app.js --mode=DOCS pull-requests: '**': - step: name: Publish task description script: - node integration-app.js --mode=TASKSВся предметная конфигурация выносится в application.yml: пространство, родительская страница, префикс заголовков, ограничения на редактирование, настройки для каждой ветки и правила публикации постановок:
application: branches: default: auth: host: ${CI_CONFLUENCE_HOST} user: ${CI_CONFLUENCE_USER} token: ${CI_CONFLUENCE_TOKEN} space: spaceKey: "SADOCS" parentPage: "Документация Системы" titlePrefix: "" forceUpdate: false jira: serverId: "..." projectKeys: [ "CRM" ] restrictions: enabled: true allowedUsers: [ "" ] taskPublishing: space: spaceKey: "SADESCRIPTION" parentPage: "Task Descriptions"Чувствительные данные прокидываются через переменные окружения Bitbucket: CI_CONFLUENCE_HOST, CI_CONFLUENCE_USER, CI_CONFLUENCE_TOKEN.
Это сокращенный пример, чтобы показать базовый принцип. В реальности конфиги куда больше и учитывают куда большее количество вещей, которыми конвейер оброс за время эксплуатации.
Например у нас сюда же была встроена интеграция с DeepL и автоматическое создание страниц на нескольких языках (специфика работы в мультиязычной команде).
Как выглядит флоу для пользователя
Проиллюстрируем подход на примере с картинками (для наглядности).
Для работы со спецификациями используется Obsidian, его рассмотрим подробно в следующей части.
1. Создание ветки
Создать ветку docs/CRM-XXXX (с номером задачи)
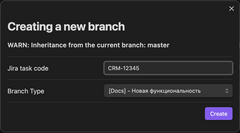 1. Создание ветки2. Создание необходимых страниц в формате Markdown в директории /docs
В папке docs добавить/скорректировать все, что нужно. Описать поведение системы в целевом формате.
 2. Создание спецификаций3. Создание файла c описанием задачи
В рамках модели в папке tasks необходимо создать файл tasks/CRM-XXXX.md с дополнительной информацией, необходимой для постановки задачи.
В Obsidian был сделан небольшой скрипт, который делает это в полуавтоматическом режиме — собирает в кучу все измененные в рамках ветки страницы и по шаблону создает черновик этого файла в один клик.
 3. Создание файла с описанием задач4. Push в репозиторий
Отправляем изменения в репозиторий
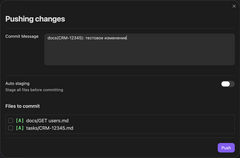 4. Push в репозиторий
5. Запуск пайплайна 1
После того, как аналитик создает Pull Request, автоматически запускается пайплайн, который создает проекцию Pull Request в Confluence:
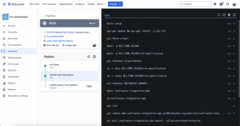 5. Pipeline 16. Проекция в Confluence
По завершению работы пайплайна в Confluence отобразится проекция Pull Request: страница tasks/CRM-XXXX.md и все измененные в рамках ветки файлы. Для этого используется специальное пространство «Task descriptions»
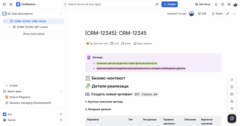 6.1. Проекция в Confluence
Опубликованную страницу нельзя редактировать из UI Confluence напрямую, на страницу автоматически накладывается ограничение на изменение.
Но при этом в footer страниц добавляется ссылка «Edit on BitBucket ✍️«, ведущая в репозиторий, где хранится оригинал в Markdown.
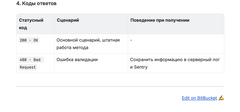 6.2. Edit on Bitbucket
Тем самым достигается консистентность, поскольку изменения допускаются только в одну сторону: из Confluence в Bitbucket ничего не нужно переносить обратно.
7. Проекция в Jira
В Jira эти же страницы автоматически добавляются в виде фрейма.
В итоге внешний читатель может даже не догадываться (у нас многие об этом правда не знают) как это все работает под капотом. Он как открывал задачу и видел описание, так и продолжает это делать после внедрения docs-as-code. Особенно это имеет ценность для бизнес-пользователей.
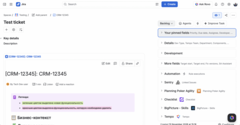 7. Проекция в Jira8. После релиза
После релиза PR можно смержить в master и обновить базу знаний по системе.
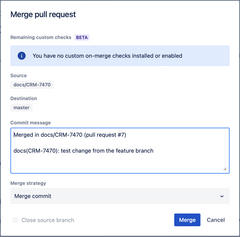 8. Merge PR9. Запуск пайплайна 2
После мержа запустится пайплайн и перенесет все изменения в Confluence в пространство с документацией системы.
Созданные страницы отображаются в Confluence в том же виде, в котором они создавались в Obsidian.
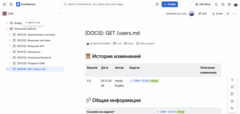 9. Опубликованная документация
Что дальше
На картинках выше уже немного засветили работу с Obsidian. Он позволяет не писать спеки в сыром .md и автоматизировать значительную часть действий аналитиков. В следующей части рассмотрим работу с ним более подробно.
Источник: habr.com