
Цикл «Docs-as-code на максималках»:
Фундамент: архитектура и видение проекта
Публикация: пайплайн Markdown → Confluence
Рабочее место: Obsidian как IDE для аналитика
Правила игры: Workflow и обратная совместимость
AI-агент: На пути к вайбаналитингу ← вы здесь
Последняя статья цикла. У нас есть CI-движок, допиленный Obsidian и выстроенный процесс. Попробуем сделать то, без чего не обходится ни один проект в 2k26м — создадим AI-агента на базе подготовленного ранее фундамента. Разберем, как использовать его по максимуму, чтобы не получить «еще один чат с MCP».
Причем тут вообще AI-агент
Внедрение нового процесса — это всегда про преодоление инерции и сопротивления. Как это сопротивление преодолевать каждый руководитель решает сам. Самый простой способ — директивно заставить всех пользоваться новым инструментом. Просто, быстро и вполне в духе российской культуры менеджмента, но вы сразу же лишаете себя полезной обратной связи, а среди сотрудников большого энтузиазма и лояльности добиться будет тяжелее.
Другой вариант — постараться сделать продукт максимально удобным и эффективным, чтобы выгода от его использования была более очевидна, и чтобы люди сами захотели им пользоваться. Такой, более либеральный, но и более требовательный к качеству решения подход.
В какой-то момент закралась мысль, что встраиваемый в рабочую среду AI-агент претендует на роль той фичи, которая позволит этого добиться, ведь идея внедрения LLM в IAE очень хорошо вписывается в подготовленную ранее архитектуру:
-
Все работает на markdown, родном для LLM языке
-
Все хранится в файловой системе, AI-агентам с этим заметно проще работать, чем с внешним MCP, который де-факто превращается в пачку тяжелых вызовов API
-
Модульность Obsidian и его архитектура позволяют глубоко интегрировать агента прямо в редактор, а не просто пользоваться чатиком. Если проводить аналогии с разработкой, то это как разница между написанием кода с помощью cursor и web-версией chatgpt
-
За счет shared-конфигурации работу агента также можно централизовать и поставлять изменения быстро и на всех клиентов
-
Написанные спецификации по конвейеру доезжают до Confluence и линкуются с задачами в Jira. По сути в один клик (или в один промпт)
Выглядит как хороший задел, который можно попытаться использовать.
1. Бизнес-контекст
От бизнес-контекста никуда не деться — агент должен знать, что уже было создано в базе знаний. И просто доступа к файловой системе недостаточно: из-за плавного перехода на момент внедрения большая часть документов еще в Confluence. Поэтому нужны внешние источники.
Первым делом мы, как все, подключили MCP к Confluence. И почти сразу уткнулись в две проблемы:
-
Слабый поиск. Он идет по обычному Atlassian API, по ключевым словам на странице. Качество низкое.
-
Расход токенов. Каждый поисковый запрос — это вызов API и по сути перебор страниц, найденных по ключевым словам.
Вместо MCP мы внедрили свою RAG-систему: она каждые 15 минут индексирует нужные пространства в Jira и Confluence и дает векторный поиск по смыслу, а не по ключевым словам. Эффект двойной: расход токенов сократился на порядок, а качество поиска выросло.
Сама реализация RAG это отдельная большая тема и отдельный проект, который остается за скобками данной статьи
По мере использования, спецификации постепенно накапливаются прямо в репозитории, и доступ агента к ним появляется также через файловую систему.
2. Технический контекст
Чтобы агент писал осмысленно, он должен видеть не только документацию, но и реальный код. Мы подключили исходники как git-submodule, только на чтение. Что это дает:
-
Безопасность. Submodule открыт на чтение и закрыт на запись. Даже если агент заглючит и захочет что-то снести, то не сможет.
-
Актуальность. Git-клиент в Obsidian сконфигурирован так, что вместе с pull документации подтягивается и обновляется код. В файловой системе всегда свежие исходники.
-
Дешево и быстро. Работает через файловую систему, токены почти не ест.
3. Связь кода и бизнес-языка
По очевидным причинам, первичный источник знаний о системе для агента — это исходный код. Его AI анализирует довольно хорошо, но у LLM есть склонность переводить артефакты «в лоб» и получается вроде правдоподобно, но неестественным языком.
Например он всегда писал «заем» вместо принятого у нас «loan», пытаясь извлекать и переводить термины из исходников.
Чтобы это подлечить, мы завели файл-глоссарий, и зашили агенту две инструкции:
-
При написании спек сверяться с глоссарием;
-
При появлении новых терминов спрашивать аналитика, как правильно назвать, и тоже добавлять в глоссарий.
Таким образом получаем самоподдерживающийся процесс. Глоссарий становится хорошим связующим слоем между кодом и спеками; он небольшой и целиком влезает в контекстное окно.
Побочный эффект: глоссарий это тоже md-файл и тоже часть репозитория, которая переносится в Confluence. А живой, своевременно обновляемый словарь терминов это артефакт, который сам по себе имеет огромную бизнес-ценность.
4. Регламенты и конвенции
Чтобы агент был полезен, он должен говорить на нашем языке. Все гайдлайны, правила написания спек, классификация и структура страниц, шаблоны уже зафиксированы в репозитории. Агент их активно использует и генерирует не абстрактный текст, а готовый набор страниц по нашим стандартам.
И снова выручает shared-конфигурация из третьей части: настройки агента это тоже часть репозитория, поэтому правки в его конфигурацию я вношу и раскатываю на всю команду так же легко, одним пушем. Это сильно упрощает отладку и дальнейшее развитие.
5. Интеграция в рабочую среду
За счет глубокой интеграции в Obsidian это уже не чатик, а полноценный агент. Мы встраивали разные обертки (или harness, как модно сейчас говорить).
Пробовали Infio Copilot (китайский аналог Cursor, или как пишут сами авторы «Cursor-inspired AI assistant for Obsidian») и Claudian (работает поверх claude code, но вообще поддерживаются и другие LLM). Последний показал себя гораздо лучше.
В чем идея на практике:
-
Агент работает сразу со всем хранилищем и генерирует набор страниц по структуре и стандартам, а не один ответ в чате
-
Как в Cursor, он видит контекст рабочего пространства: какая страница открыта, есть ли выделенные фрагменты, предлагает автодополнение
-
Поддерживаются скиллы, субагенты и прочие надстройки
-
На выходе результат, «почти» готовый к публикации (да да, это чистая правда): не нужно копипастить из чата, артефакты уже созданы, остается провести ревью и запушить
-
Workspace агента ограничен vault-ом Obsidian, который одновременно является локальным репозиторием. Поэтому в случае «неожиданных» результатов работы агента, можно легко отследить, какие именно файлы он менял и в любой момент сделать rollback
6. Конфигурация окружения
Claudian является оберткой над claude code, поэтому все функции последнего ему доступны. Других популярных вендоров он вроде тоже поддерживает, но мы не тестировали.
Все описанное выше остается упаковать во входную инструкцию, создать скиллы и команды и, само собой, непрерывно улучшать. От качества всего этого зависит конечный результат.
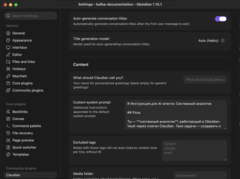 Конфигурация Claudian
Для своих задач мы создали 4 режима работы:
-
Чтение — если необходимо разобраться с определенной частью системы или процессом.
-
Запись — создание нового контента по описанию. Его можно использовать, например, для переноса ранее созданного контента из Confluence.
Пример: даем промпт «перенеси статью из Confluence по нашим шаблонам + ссылка». Агент прошелся по связанной информации, нашел похожие задачи, завел термины в глоссарий, создал артефакты по шаблонам и заполнил их по реальному коду. Более того, он восстановил историю изменений, найдя связанные задачи, и подсветил расхождения спеки с кодом, предложив исправить. То есть не просто перенес, а еще и актуализировал.
-
Ревью — проверка того, что было сделано в рамках задачи. Очень хорошо отлавливает несоответствия документации и кода.
Пример: Открыли страницу, попросили «проведи review». Агент нашел реальные пробелы: сбитую нумерацию после ручных правок, неверно переименованный атрибут (копипаст), незакрытый md-блок, подсветил различия между документацией и кодом, архитектурные несоответствия.
-
Постановка задач — на вход дается одна ссылка на задачу в Jira, агент собирает контекст из RAG, создает новую ветку, задает вопросы по реализации, сверяется с исходным кодом и готовит драфт спеки.
Все создаваемые артефакты работают по структуре и шаблонам, которые были подготовлены ранее. Отдельно в инструкцию указано как работать с расширениями Markdown, которые были созданы в 3й части цикла. Таким образом агент пишет документы, пригодные для публикации в Confluence со всеми дополнениями и визуализациями.
Пример работы агента над задачей
Возьмем какой-нибудь известный open-source и покажем как работает агент на нем.
1. Как выглядит задача в Jira 1. Задача в Jira2. Вызов агента в режиме постановки задачи
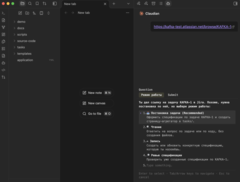 2. Запуск агента3. Уточняющие вопросы
Агент проинструктирован не принимать архитектурных решений самостоятельно, а задавать вопросы и предлагать на выбор.
Также он задает вопросы по входным требованиям, уточняет corner cases и при появлении новых терминов предлагает добавить их в глоссарий.
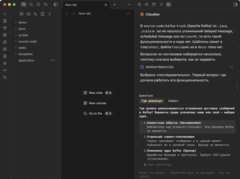 3. Ответы на вопросы4. Результат работы
Созданные артефакты в полном соответствии с нашей структурой и шаблонами. Отдельно в папке /tasks создан md-файл с ключом задачи и содержимым постановки задачи.
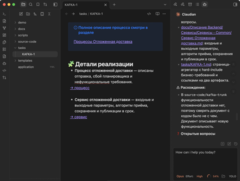 4. Файл с постановкой задачи5. Ревью и правки
Аналитик проводит ревью спецификации перед публикацией.
Можно выделить кусок созданной спецификации и попросить агента доработать его.
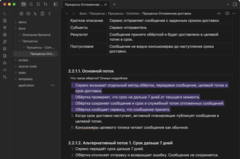 5.1. Работа над частью документа
Также доступен автокомплишн по tab, что ускоряет рукописный ввод:
 5.2. Автокомплишн6. Публикация в репозиторий
После проведения ревью и внесения правок аналитику остается только запушить изменения в репозиторий.
Реализованный во 2й части цикла пайплайн автоматически перенесет это в Jira и Confluence.
Опыт использования
Как легко догадаться, качество результата сильно зависит от используемой модели.
Наш агент работает на базе Claude и с его линейкой моделей примерно следующая картина:
-
Haiku — Слабо годится для решения подобных задач. Помогает только в режиме «Чтение», когда нужно быстро разобраться, как работает определенная часть системы или процесс.
-
Sonnet — Работает средне, просто делает свою работу, следует постановке в лоб, не задавая лишних вопросов создает спецификацию строго по шаблонам.
-
Opus — Лучше всего подходит для решения подобного класса задач. Вопросы по постановке задает достаточно глубокие, видит сложные зависимости и корнер кейсы, архитектурные проблемы. Шаблоны использует по-умному, видя больше, чем просто каркас. Например у нас в шаблонах фигурирует блок «История изменений». Opus воссоздает всю хронологию изменений по истории изменения задач в Jira и Confluence и истории коммитов в репозитории. На практике для задач простой и умеренной сложности с достаточным количеством добавленного ранее бизнес-контекста (прямо коррелирует со зрелостью проекта), созданные спецификации нередко могут даже не нуждаться в ручных правках, и их можно сразу отправлять в разработку. Отсюда и название для описанного подхода, который я обозвал вайбаналитингом
-
Fable — выглядит избыточно для подобных задач, расход токенов слишком велик.
Вместо итогов
Собрав все элементы в общий конвейер, мы получили модификацию docs-as-code, которая сохраняет плюсы классического подхода и снимает часть барьеров по переходу на него.
Но только часть. Сложности docs-as-code никуда не делись: мы их сгладили и растянули во времени. Долгоживущие ветки по-прежнему приносят конфликты при мерже, и тут простым Git-клиентом уже не обойтись. Поправить опечатку в Confluence теперь может только аналитик через репозиторий, а переходный период, когда старые и новые страницы живут рядом, может сильно растянуться во времени (у нас именно так и произошло).
Так что это точно не панацея, скорее одна из идей, как сделать переход достаточно плавным, чтобы команда вообще на него решилась, а с остальным разбираться уже по ходу.
Источник: habr.com