
Привет, Хабр! Меня зовут Илья Лысенко, я работаю в команде платформы данных Lamoda и занимаюсь пайплайнами продуктовой аналитики и качеством данных.
Полтора года назад мы открыли дашборд и увидели график отклоненных строк, идущий отвесно вверх: больше миллиона событий в день перестали проходить валидацию. Источник событий молча поменял формат критического поля, а downstream-потребители, аналитики и дата-сайентисты, об этом даже не подозревали.
Вариантов действий в такой ситуации обычно два. Остановить пайплайн и разбираться – значит терять данные, пока чиним. Ехать дальше – значит отдавать потребителям некачественные данные. Оба ведут к просадкам в качестве анализа и моделей, которые зависят от данных источника. К счастью, нам выбирать не пришлось: третий вариант мы к тому моменту строили уже несколько лет.
Если у вашего пайплайна есть DLQ (Dead Letter Queue, очередь недоставленных сообщений), вспомните, когда вы в последний раз оттуда что-то доставали. Часто записи падают в DLQ, и на этом их история заканчивается. У нас процесс устроен по-другому. Запись, не прошедшая проверку качества, не удаляется: она паркуется в отдельном хранилище, откуда ее можно вернуть – целиком и без дублей.
Расскажу, как такой пайплайн устроен, и разберу тот самый кейс: с февраля 2025 года в reject ушло порядка 500 миллионов строк, и каждая в итоге доехала до потребителей.
Почему «просто выкинуть» не вариант
Сначала о том, что стоит на кону. Основной поток, о котором пойдет речь – события пользователей – просмотры, клики, изменения корзины, заказы. Из них считаются витрины Action Storage (коллеги подробно писали, как он устроен), а на витринах живут рекомендации, персонализация, A/B-эксперименты и продуктовая аналитика.
Один потерянный день таких событий – это деградировавшие рекомендации и искаженные метрики экспериментов. И это дыра в исторических датасетах для ML, которую потом нечем закрыть. Последнее – не теоретический риск: у нас был инцидент, когда баг iOS-приложения молча терял клики в поисковой выдаче, тянулось это больше месяца, и пробел пришлось заполнять из альтернативного источника. Самое неприятное в тихих потерях именно это: последствия прилетают через недели, когда уже непонятно, где всё началось.
Стандартный ответ стриминговой архитектуры на «плохие» записи – Dead Letter Queue. Сама концепция правильная. Но на практике DLQ часто превращается в место, куда данные только падают: отложили, забыли, а через месяц никто не помнит, что там лежит и зачем.
Мы стремимся к тому, чтобы не выкидывать ни одной записи из процессов полезного использования. Любые данные приземляются, непрошедшие проверки изолируются, но остаются доступными, а когда становится понятно, что с ними делать, – возвращаются в общий поток.
Архитектура
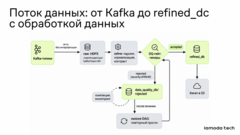
В архитектуре четыре слоя: лендинг «как есть», refine с контрактами, DQ-гейт и reject-хранилище с инструментами восстановления.
1. Лендинг: приземляем как есть
Главный принцип: сырые данные пишутся в HDFS без какой-либо интерпретации. Spark-стриминг читает Kafka и складывает каждое сообщение в партиции по дате потребления, в ORC:
(topic, partition, offset, timestamp, key, value)
value – сырая строка, ровно в том виде, в котором пришла. Схема одна на все топики: к содержимому добавляются только служебные поля Kafka. Никаких трансформаций и валидаций на этой стадии не происходит.
Два свойства этого слоя делают возможным всё остальное. Мы сохраняем topic/partition/offset – уникальный адрес каждого сообщения. Позже именно по нему работает дедупликация при восстановлении, гарантирующая, что одна и та же запись не запишется дважды. И мы храним оригинал: источник может выкинуть что угодно – новые поля, смену формата, странные значения, – а у нас останется исходное сообщение, которое можно перечитать с новыми правилами. Запись, признанную «битой» и выброшенную на входе, потом не вернет никакой инструмент, поэтому на входе мы не выбрасываем ничего.
2. Refine: контракт и нормализация
Если приземлить данные без трансформации относительно просто, то для их валидации и преобразования уже нужен полет инженерной мысли. У нас оба этих процесса, код которых разведен по разным проектам, объединены в запуск одного приложения, чтобы не перекладывать данные дважды.
Refine – отдельное Spark-приложение на каждый топик, в проде таких джоб около полусотни: refine_kafka_. Стартует оно раз в полчаса и читает сырые данные, которые еще не были обработаны, парсит JSON по контракту источника, проверяет соответствие строки требованиям качества, нормализует данные и пишет результат в базу данных в Hive.
Вся работа refine и масштабирование процессов на новые топики построена на трех объектах:
-
контракт источника (структура сообщения Kafka),
-
обработчик с переопределенным методом transform,
-
контракт таблицы-приемника.
Контракт источника описан case-классом, из которого автоматически выводится ожидаемая JSON-схема:
class KafkaSomeTopicRaw(field1: String,field2: Int,field3: Map[String, String],...)Логика преобразования живет в лоадере топика и может переопределять трансформации:
class KafkaSomeTopicLoader {override def transform(df: DataFrame): DataFrame = // нормализация к контракту таргет таблицы}И отдельный case-класс для описания схемы поля на выходе, по аналогии с *Raw.
Обратите внимание на метод
transform: это то место, где можно преобразовать и старый и новый формат одного поля с источника и привести к старому контракту, так что downstream-потребители изменений просто не видят. В кейсе ниже он сыграет главную роль.
Обработанные сырые файлы переезжают в поддиректорию processed/ – так пайплайн отличает обработанное от необработанного, а raw-слой остается нетронутым архивом первоисточника.
3. DQ-гейт: проверяем, не блокируя пайплайн
Проверки качества выполняются прямо внутри refine-джобы с помощью библиотеки чекеров. Чекеры есть двух видов:
● column-чекеры смотрят на колонки целиком (наличие данных, последовательность оффсетов),
● value-чекеры – на значения конкретной записи.
Базовая проверка для raw-слоя – соответствие JSON-схеме, выведенной из case-класса контракта, дальше подключаются чекеры из конфига топика. Проверки проводятся после чтения строки (соответствие JSON-схемы сообщения и raw-контракта из refine уже проведено), но перед трансформацией. То есть обмануть DQ и нормализовать поле так, чтобы оно соответствовало проверке, не выйдет. Конфиг декларативный, вот фрагмент реального:
"data.country" = [{ checker = "NotNullChecker" },{ checker = "EnumChecker", params.values = ["RU", "UA", "KZ", "BY"] }]У каждой проверки есть степень серьезности (severity):
● ERROR – запись отклоняется и физически не доходит до потребителей: она уходит в reject-хранилище в сыром виде.
● WARN – данные проходят в refined, а в сервисный чат уходит алерт.
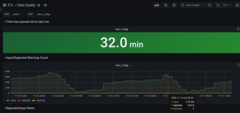
Вердикты пишутся в таблицу отчетов: имя чекера, severity, число отклоненных строк, группа записи и JSON-пример отклоненной строки – при диагностике этот пример экономит больше всего времени. Алерты уходят при превышении трешхолда, чаще всего это 1% (да, требования к качеству достаточно строгие 😉 ). Отдельно стоят проверки количества строк, резкое сокращение объема в refined-таблицах – это тоже сигнализатор проблемы, либо на источнике либо в обработке.
4. Reject: хранилище, из которого читают
Отклоненные записи складываются в data_quality_db/rejected/raw/kafka//dt=... – в том же сыром виде, в котором приземлились из Kafka.
Главное отличие от типичного DLQ в том, что reject у нас изначально спроектирован с расчетом на чтение, причем большими объемами:
-
Ежедневный компактор собирает мелочь в файлы по ~5 ГБ – иначе за месяцы там накопились бы миллионы мелких файлов, которые невозможно нормально прочесть.
-
TTL здесь нет: данные не удаляются, пока мы не решили их судьбу.
-
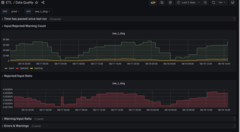
Счетчики строк и отчеты по отклонениям выведены на дашборд:
А теперь от сухой техники перейдем к захватывающему сюжету: как все описанные механизмы помогли нам сначала не испортить данные для аналитики, а затем не просесть из-за нехватки данных.
Кейс: источник поменял формат SKU
Февраль 2025 года. Платформа продуктовой аналитики поменяла формат поля params.sku в потоке пользовательских событий (zlog). Раньше в списке SKU был один индекс и разделитель ;. Теперь стало два индекса, а местами перечисление через запятую:
● Было: 1:RTLAEA717102:7990.0:9399.0:15
● Стало: 1:1:RTLAEA717102:7990.0:9399.0:15;1:2:RTLAEH260601:10725.0:14299.0:25
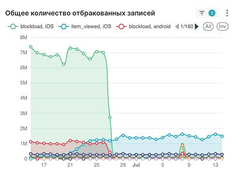
Потребители такого не ожидали. Чекеры, проверявшие списки SKU, начали массово отклонять события просмотра товара и модификации корзины в рекомендациях. На фоне всего потока объемы были значительными, но не выглядели критичными, до 3% записей в день. Однако аналитики быстро заметили, что просадка идет конкретно по двум событиям с фронта, и они теряли больше половины записей, что не могло не отразиться на качестве витрин и моделей.
Почему мы не пошли чинить источник? Процитирую постановку задачи того времени:
«Исправление логики на стороне бэкенда, генерирующего события, – сложный и длительный процесс. Корректировка DQ-чекеров и правил refine – оперативный способ восстановить корректную обработку критически важных событий и обеспечить полноту данных».
Так что спасать ситуацию пришлось инженерам данных. Логично было разделить процесс на два этапа: сначала починить обработку строк, продолжающих прилетать в новом формате, а уже затем восстанавливать то, что было признано негодным.
Этап первый. Чиним строки
Первый шаг – привести данные к старому контракту. Если новый формат – просто другой способ записать то же самое, приводим его к прежнему виду в transform. Потребители изменений не видят, контракт сохраняется.
Типичный пример из той же серии: источник сменил формат времени в сообщениях об изменениях корзины с yyyy-MM-dd HH:mm:ss на ISO-вариант с буквами T и Z. Лоадер на переходный период научился понимать оба:
private val oldBodyTimestampFormatter = ofPattern(“yyyy-MM-dd HH:mm:ss”) private val bodyTimestampFormatter = ofPattern(“yyyy-MM-dd’T’HH:mm:ss’Z’”)
val formatter = if (ts.endsWith("Z")) bodyTimestampFormatter else oldBodyTimestampFormatter
Когда источник окончательно переехал на новый формат, второй парсер удалили. Тем же приемом закрывали отсутствующие поля: приложения одной из версий не присылали timestamp, и refine достраивал его из уже имеющегося времени события. Контракт не менялся, потребители ничего не заметили.
Второй шаг – расширить whitelist допустимых форматов в чекере. Когда формат действительно новый и приводить к старому нечего, добавляем его в список допустимых. Чекер списков SKU в итоге поддерживал пять форматов: строку, строку с индексами, JSON-массивы и URL-encoded вариант. Добавление нового формата – это доработка чекера плюс строчка в конфиге.
Этап первый с половиной. Что-то пошло не так
Обновленный чекер уехал в прод, и следом прилетел алерт уже по соседнему потоку: посыпались события создания заказа. Правила, написанные под новые форматы SKU-списка, оказались слишком строгими для старых.
Решили радикально: откатились на прежнюю версию чекера, а доработанную выпустили отдельным универсальным чекером и подключили в конфиге только к item_viewed – событию, ради которого всё и затевалось.
Правило, которое мы из этого вынесли: никаких ложных отклонений и никаких регрессий. Если ужесточение проверки ломает соседний поток – оно неправильное, даже если целевой поток теперь идеально чистый. DQ-гейт, который сам создает потери данных, хуже, чем отсутствие гейта.
Этап второй. Восстановление строк
Чекеры починили, но данные всё еще лежат в reject. Возвращал я их стандартным DAG восстановления: он перечитывает накопленные rejected-партиции через обновленные проверки. Идемпотентность зашита внутрь:
● По accepted-записям работает дедупликация по уникальным колонкам против уже лежащего в refined – дописываются только недостающие записи, повторный прогон не создает дублей.
● Записи, не прошедшие проверки и в этот раз, остаются в reject.
● Сырые reject-файлы удаляются только после успешной обработки.
Для zlog был еще один обязательный шаг: после восстановления пересчитать зависимые витрины Action Storage за весь восстановленный период и обновить бэкап в S3. Бэкап обновляется пайплайном с атомарным свапом – промежуточная таблица, merge с основной, компакция, копирование в S3 во временную директорию и атомарный перенос со сверкой контрольных сумм. На объемах zlog, а это сотни гигабайт в день, без такой аккуратности легко превратить восстановление в новый инцидент.
В итоге счетчики отклоненных строк в отчетах сошлись с объемом восстановленного, события доехали до витрин и рекомендаций, история пересчитана. Все 500 миллионов, просто позже обычного.
Инструментарий восстановления
Кейс с SKU – самый масштабный, но не единственный сценарий. Со временем ситуаций накопилось несколько типов, и под каждый появился свой инструмент. Все они – режимы работы того же refine-приложения, и это осознанное решение: восстановление выполняет тот же код, что работает в основном потоке, просто запущенный иначе. Отдельных «восстановительных» скриптов со своим собственным поведением у нас нет.
Все вариации настройки процессов восстановления привели к такому дереву решений, покрывающему все потребности, которые возникали при работе с нашим DLQ.
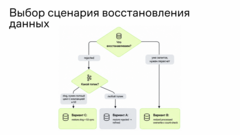
Вариант A – восстановление из rejected, основной. Перечитывает накопленные rejected-партиции по всем топикам и дописывает то, что проходит по новым правилам. Именно этим путем вернулись данные из кейса выше.
Вариант B – пересчет уже залитого. Нужен, когда поменялась логика трансформации или чекеров и надо пересчитать данные, которые уже лежат в refined, из ранее обработанных сырых данных (они складываются в поддиректорию processed). Перезапись партиции происходит только при совпадении счетчиков перезаписываемого и обработанного, иначе задача падает. Это защита от сценария «перезаписали хорошее плохим»: если партиция сырых данных потеряна, перезагрузка честно упадет с ошибкой, а не молча обнулит таблицу. Позже сюда добавили точечный запуск на одну партицию, чтобы не перечитывать весь топик ради одного дня.
Вариант C – полный цикл для zlog. Rejected → промежуточная таблица → merge с основной → компакция → синхронизация с S3-бэкапом: временная директория, атомарный перенос, сверка по размеру и контрольным суммам. Для других критичных топиков такой же пайплайн собирается по этому же шаблону.
Общее требование ко всем режимам – идемпотентность. Восстановление запускается руками, нередко после ошибок, и обязано переживать повторный старт без дублей и без потерь: append защищен фильтром дублей, overwrite – проверкой счетчиков.
Когда кейсов стало много, процесс стандартизировали: дерево решений и сравнение вариантов задокументированы и лежат рядом с кодом дагов восстановления.
Так восстановление из квеста для посвященных превратилось в штатную операцию, которую дежурный выполняет по гайду.
Не всё нужно восстанавливать
Важная оговорка: не каждое отклонение это повод править чекер. Иногда гейт ловит реальный дефект источника, и правильная реакция – оставить данные в reject и требовать починки у владельца.
Показательный случай из недавней волны алертов: часть событий публикации заказа приходила вообще без параметра SKU. Формально можно было ослабить чекер и залить эти данные «как есть», но SKU в этих событиях нужен потребителям, запись без него бесполезна для расчетов. Так что проверку мы не тронули, задача ушла владельцу источника, а события лежат в reject. Починится источник, и мы вернем их тем же DAG восстановления.
Побочный эффект такой дисциплины: по дашборду отклонений видно, какой топик и какой бэкенд шумит, и к владельцам источников можно приходить с конкретными цифрами.
Выводы
За время развития такой архитектуры главные уроки утряслись до короткого списка.
1. Сырые данные надо приземлять как есть: любая обработка на входе – необратимое решение, принятое вслепую, а оффсеты и оригиналы сообщений – то, что вообще делает восстановление возможным. Ошибка валидации означает «не пускать к потребителям», и это не то же самое, что «удалить», – пайплайн обязан различать эти две операции.
2. Восстановление должно выполняться тем же кодом, что и основной поток, иначе появляется вилка поведения и оно навсегда останется рискованным приключением.
3. Идемпотентность в восстановлении не опция: первый же повторный запуск без нее принесет больше проблем, чем исходная потеря.
4. И последнее, чему нас научила история с order_submit: не трогайте чекеры в панике – гейт, который сам портит данные, хуже отсутствия гейта.
А если у вас уже есть DLQ, посмотрите, что там. Если ответ на вопрос «как отсюда достать данные» – «никак», то у вас не парковка, а кладбище. Перестроить можно, мы проверяли.
Расскажите в комментариях: доводилось доставать данные из своего Dead Letter Queue, и получилось ли?
Источник: habr.com