
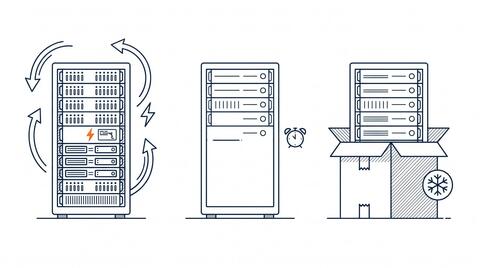
Резервные копии есть почти у всех, но в реальной аварии срабатывают единицы из них. В октябре 2026-го у крупного облачного провайдера один за другим вставали дата-центры, и у части компаний копии были, а развернуть их оказалось негде. Разбираем, чем холодный, теплый и горячий резерв отличаются по деньгам и времени восстановления и как выбрать схему под допустимый простой. Разницу между схемами объясняем простым языком, без инженерных глубин.
На связи Авдей Мартынович, руководитель направления по работе с малым и средним бизнесом ALP ITSM. Наша команда работает с ИТ-инфраструктурой компаний с 1996 года, и последние месяцы «какой резерв нужен именно нам» — один из самых частых вопросов от наших клиентов. Расскажем, чем схемы отличаются, сколько стоят и где спотыкаются на практике.
От чего зависит выбор резерва
Основной запрос любого бизнеса к ИТ — сохранность данных и доступность главных сервисов: почты, 1С, CRM и складских систем. Когда вы переносите резерв в облако, выбор режима упирается в то, как быстро систему нужно вернуть в работу и сколько изменений допустимо потерять при сбое.
Чтобы сравнить варианты без лишней теории, руководителю достаточно согласовать два показателя:
-
RPO (допустимая потеря данных) — за какой период перед сбоем бизнес готов потерять свежие изменения;
-
RTO (допустимое время простоя) — за сколько систему нужно вернуть в работу.
Эти значения определяют для каждой критичной системы отдельно и обязательно проверяют тестом восстановления. Именно от пары RPO и RTO зависит, какой режим резервирования подойдет компании — холодный, теплый или горячий. Они отличаются тем, насколько резервная площадка готова принять нагрузку в момент аварии и сколько бизнес платит за эту готовность.
Холодный резерв
Это базовый вариант для систем с высоким допустимым временем простоя (RTO измеряется часами и днями). Компания сама обеспечивает доступность сервисов, не строя избыточную инфраструктуру, а используя облако как страховку. Классика — минимальный контракт с ЦОД и VPN-тоннель. При форс-мажоре арендуются мощности, на них разворачиваются копии, трафик переводится на новые адреса. Время переключения зависит от того, есть ли у провайдера свободные мощности. При заранее оплаченных ресурсах укладываются в часы, при поиске площадки после аварии речь уже о днях.
Распространенный вариант — Backup as a Service (BaaS). Платят не за ресурсы, а за резервирование, хранение и восстановление копий в облаке поставщика услуги. У услуги есть граница. BaaS возвращает данные, но сам не запускает сервисы, разворачивать копии при форс-мажоре придется на подготовленных мощностях, и это снова часы или дни.
Теплый резерв
В облаке хранятся копии данных и все программы, рабочие данные периодически обновляются. Инфраструктура готова к работе, но пока «на консервации». При форс-мажоре арендуются дополнительные ресурсы, виртуальные машины запускаются по готовому сценарию, запросы пользователей маршрутизируются на резервную площадку. У нас по договору переключение на теплый резерв выполняется не более чем за 12 рабочих часов, на протестированной схеме — обычно 1–2 часа. Данные теряются только за короткий отрезок непосредственно перед аварией. Точное время переключения определяют при проектировании решения под конкретный бизнес — исходя из того, какой простой и какую глубину потери данных компания готова пережить без критичного ущерба.
Это быстрее холодного резерва, но дороже, ведь платить приходится не за хранение, а за виртуальные серверы резервной инфраструктуры. Часть работ нужна заранее — где-то провести миграцию сервиса в облако, где-то обновить ПО до поддерживающего отказоустойчивый режим.
Горячий резерв
Все копии данных и программ работают параллельно с боевыми. При синхронной репликации (а без нее, пожалуй, и не стоит затевать этот способ) они точно такие же, в крайнем случае — почти не отстающие. Сервисы настроены, запущены и готовы принять пользователей, переключение происходит автоматически, без участия человека: при холодном и теплом резерве человек в переключении участвует по умолчанию, при горячем — не участвует вовсе. Время простоя при переключении измеряется минутами, практически без остановки.
Далеко не каждой компании это нужно. Сервисов, которым требуется немедленное восстановление при сбое, в организации обычно немного, не более 20% от общего числа: IP-телефония колл-центра, платежные системы, складская логистика транспортных и производственных компаний.
Для сравнения — типовые параметры трех схем.
Схема
Восстановление (RTO)
Стоимость
Типовое применение
Холодный резерв (в т.ч. BaaS)
часы, сутки и больше
самая низкая
архивы, тестовые среды, некритичные системы
Теплый резерв
по договору не дольше 12 рабочих часов; на протестированной схеме — обычно 1–2 часа
средняя
бизнес-приложения (1С, склад, CRM)
Горячий резерв
минуты, практически без простоя
самая высокая
платежные системы, колл-центры, критичное ядро
Горячее и холодное резервирование решают разные задачи. Первое сокращает перерыв в работе, второе позволяет сохранить данные с меньшими затратами. Теплое занимает промежуточное положение.
Как выбрать вариант резервирования
Выбор начинается не с цены, а с двух чисел для каждой системы: допустимого простоя и допустимой потери данных. Если система может стоять днями — хватит холодного резерва с проверенным восстановлением. Если остановка учетной системы или склада дольше рабочего дня бьет по выручке — нужен теплый резерв, причем в другом регионе у другого провайдера. Если нельзя остановиться даже на час — горячее резервирование, но, как правило, только для нескольких самых критичных систем.
Заранее проверьте, что резервная площадка выдержит рабочую нагрузку. После переключения все пользователи работают с резервом в обычном режиме, и мощностей должно хватать.
Как теплый резерв выглядит на практике — по шагам, с разнесением площадок и первым тестом переключения, — мы разобрали в статье «Теплый резерв: как бизнесу пережить отключение дата-центра без переезда в другое облако».
При выборе варианта руководителю стоит оценить:
-
сколько стоит час простоя каждой критичной системы;
-
какой ущерб накопится за ожидаемое время восстановления;
-
во сколько резервирование обойдется за год вместе с настройкой, хранением, мощностями и тестами;
-
насколько сокращение простоя оправдывает разницу в затратах между вариантами.
Необязательно выбирать одну схему для всей компании, ведь требования склада, продаж и архива различаются.
Кому и что интересно в первую очередь?
Определяющую роль играет масштаб организации — как контекст бюджета и компетенций, а не как главный критерий. Рекомендации строятся вокруг допустимого простоя и ущерба.
Крупная компания — теплый или горячий «дубль»
Если у компании уже есть отказоустойчивые системы, но все сервисы живут в одной локации, облако добавляет защиту от выхода из строя всей площадки. Отказы серверов, коммутаторов, падения интернет-каналов при распределенной структуре перестают пугать и головной офис, и региональные отделения. Исключение — момент, когда вся площадка уходит в офлайн: длительное отключение электричества, обрыв кабеля, ошибочное удаление данных из хранилища. Здесь нужен именно сценарий при полной недоступности локации — и трезвый расчет, сколько ресурсов и в каком резерве действительно выгодно.
Резервирование оборудования внутри одной площадки и резерв данных на другой площадке решают разные задачи, и второй надо проверять отдельно. Плюс современная инфраструктура и все нужные ИТ-компетенции — в штате или на аутсорсинге.
Средняя компания — и тепло, и горячо, и холодно
Среднему бизнесу стоит просчитывать все три варианта. Если сервисов десять и больше, держать их все горячими накладно. Если ключевых сервисов до пяти — почта, файловый сервис, 1С, CRM, складская логистика — горячий резерв и траты на него вполне оправданы. Но чаще всего оптимальным оказывается теплый. Он дороже холодного, зато заметно дешевле горячего. Специалисты настраивают схему и готовят детальный план переключения, поэтому проектная часть проработана досконально. При этом теплый резерв приемлем для большинства сервисов, ведь выгода от разницы в цене обычно перевешивает ущерб от чуть большего времени переключения.
Малый бизнес — холодный, максимум теплый
Небольшой компании в 10–50 человек невыгодно дублировать всю инфраструктуру: представьте двух интернет-провайдеров и по два комплекта сетевого и серверного оборудования. Проще арендовать ресурсы или настроить резервное копирование в облако к провайдеру, который позволяет восстановить инфраструктуру там же. Холодный резерв стоит недорого, а закрывает сразу массу проблем — от сбоев электропитания до атак шифровальщиков, что особенно важно, если компания не может позволить себе потерю данных. Такой вариант подходит, если бизнес выдержит время восстановления из копий; если критична даже короткая остановка, смотрите в сторону теплого или горячего резерва независимо от размера компании.
Как избежать ловушек при хранении копий у провайдера
Неважно, переносите вы в облако всю инфраструктуру или разворачиваете там только резервный контур — при выборе провайдера и обсуждении договора стоит проверить четыре критичных момента.
1. Гарантии в договоре вместо красивых шильдиков. Международная сертификация Tier от Uptime Institute в России сейчас недоступна, поэтому надпись «уровень Tier III» на сайте провайдера остаётся на его совести. Вместо маркетинговых буклетов проверьте реальный SLA: за что именно отвечает провайдер, как фиксируется простой и какую ответственность он несёт, если площадка встанет.
2. Резерв у другого провайдера и в другом регионе. Разнести сервисы по двум дата-центрам одного провайдера недостаточно: в октябре 2026 года запасная копия в соседнем ЦОД спасла не всех. Кроме того, само по себе наличие второй площадки не работает, если под ваш резерв там заранее не заложен нужный объем мощностей. Критичные системы стоит дублировать в другой регион и к независимому провайдеру.
3. Доступность мощностей при массовой аварии («риск плохого соседа»). В публичном облаке ресурсы делятся между клиентами. Когда случается крупный сбой, десятки компаний одновременно начинают разворачивать свои копии — и свободных серверов или пропускной способности на всех может не хватить. Выясните до договора: какие мощности закреплены именно за вами, а за какие придётся конкурировать с соседями в момент аварии.
4. Защита каналов от чужих DDoS-атак. Если вы делите интернет-канал с популярным ресурсом, на который идет DDoS-атака, канал забивается и синхронизация ваших данных встает. Пока связь лежит, изменения копятся, а после восстановления канал не успевает прокачать накопившийся объем. Выбирать IaaS-провайдера только по минимальной цене — прямой путь в такой сценарий.
Что проверить вместе с ИТ-специалистом до первой аварии
Даже правильно выбранный и оплаченный резерв может не сработать в час Х из-за организационных мелочей. Вот три вопроса, которые руководителю стоит закрыть со своим системным администратором или ИТ-подрядчиком заранее.
Провести полноценный тест переключения, а не просто «проверить бэкапы». Классическая ловушка: копия виртуальной машины есть, но в момент аварии развернуть ее у провайдера не получается — не хватает зарезервированной памяти, процессоров или нужной конфигурации. Сценарий «нажмем кнопку — и все поднимется за пять минут» особенно опасен для холодного резерва. Если реальное восстановление занимает сутки вместо пары часов, узнать об этом лучше на плановых учениях, а не когда встали продажи и склад.
Продумать, как в резерве будут работать обычные сотрудники. Успех резервирования измеряется не зелеными галочками в консоли админа, а тем, могут ли люди открыть 1С, почту и CRM. Заранее подготовьте резервные параметры доступа, понятные памятки для сотрудников и терминальный сервер для удаленной работы. Отдельно проверьте периферию и связь: локальные принтеры, кассы, гарнитуры и задержки сети — если резервный ЦОД находится далеко, видеозвонки и телефония могут работать с перебоями.
Хранить аварийный план и пароли вне основной инфраструктуры. Самая обидная ошибка — положить инструкции и доступы от резервной площадки на тот самый сервер или внутренний портал, который упал при сбое. Проводите учения максимально честно: с имитацией полного отключения офиса, когда у сотрудников на руках распечатанный порядок действий, а у администраторов — офлайн-копия инструкций или доступ через независимое облако. Иначе можно вложить миллионы в резервирование и потерять полдня просто потому, что нужный файл остался на отключенном сервере.
Итого
Облако — такой же инструмент, и оно тоже ломается. Полагаться только на инфраструктуру одного провайдера, пусть даже с репликацией между его дата-центрами, слишком рискованно. Если данные пропадут, провайдер в лучшем случае вернет плату за период простоя. Потерянные данные и остановленные сервисы этим не вернешь, поэтому пункт о форс-мажорах стоит прочитать до аварии. Мы рекомендуем клиентам хранить резервные копии еще и на другой площадке, у другого провайдера и в другом регионе: это ответственный подход к важным данным, и он себя полностью оправдывает.
Короткие разборы про ИТ в малом и среднем бизнесе — в Telegram-канале ALP ITSM.
Источник: habr.com