
Представим тест-кейс: пользователь входит в систему, создаёт задачу и проверяет, что она появилась в списке. Чтобы автоматизировать его в Selenium или Playwright, инженер обычно пишет код: находит элементы страницы, задаёт действия, добавляет проверки и настраивает запуск.
Теперь часть этой работы можно поручить инструментам с ИИ.
Есть несколько вариантов: написать автотест самостоятельно, записать действия в браузере, попросить языковую модель сгенерировать код или передать готовый тест-кейс системе, которая исследует приложение и попробует пройти сценарий без ручного управления браузером.
На последнем подходе построена Test AI. На вход система получает уже описанный сценарий с шагами и ожидаемыми результатами. Это особенно полезно командам, у которых тест-кейсов много, а автоматизирована лишь часть.
Разберём различия на одном примере, а затем посмотрим, как работает Test AI.
Способ 1. Написать автотест вручную
Сначала рассмотрим написание автотеста с нуля.
Проверка создания задачи состоит из нескольких шагов:
-
авторизоваться;
-
открыть список задач;
-
создать задачу;
-
заполнить обязательные поля;
-
сохранить;
-
убедиться, что новая задача появилась в списке.
Инженер реализует эти шаги в коде и добавляет проверки результата.
У такого способа есть преимущество: инженер сам выбирает, что делать через интерфейс, а что подготовить через API или фикстуры, где разместить проверки и как устроить тестовую инфраструктуру.
Цена контроля — время на разработку и поддержку. Нужны знания языка и фреймворка; при изменениях интерфейса приходится обновлять локаторы, а при падениях разбираться, проблема в продукте, данных, окружении или самом тесте.
Часть работы можно ускорить, не отказываясь от кода.
Способ 2. Записать действия пользователя
У Playwright есть Codegen — инструмент записи действий. Тестировщик открывает браузер, проходит сценарий, а Codegen записывает клики, ввод данных и переходы в виде кода. Он подбирает локаторы и позволяет добавить проверки видимости элемента, текста или значения поля.
Так можно быстро получить заготовку автотеста.
Но маршрут по приложению по-прежнему задаёт человек: Codegen не читает тест-кейс и не решает, какое действие должно быть следующим.
Для проверки создания задачи QA самостоятельно откроет форму, заполнит поля и нажмёт «Сохранить».
Затем полученный код нужно прочитать и доработать: запись действий сама по себе ещё не гарантирует осмысленных проверок.
Следующий шаг — поручить интерпретацию сценария языковой модели.
Способ 3. Создать автотест с помощью ИИ
Например, дать модели такой запрос:
Авторизуйся в системе, создай новую задачу типа «Стандарт» и проверь, что она появилась в списке.
Модель может написать тест на Playwright, используя описание вместо записи действий.
У этого подхода два слабых места. Без доступа к приложению модель может неверно угадать его интерфейс. А даже рабочий код не обязательно проверяет то, что требовалось по тест-кейсу.
Допустим, тест проверяет только появление уведомления «Задача создана». Он пройдёт, даже если запись не сохранилась и задачи нет в списке. Зелёный результат здесь не доказывает, что бизнес-сценарий работает.
Поэтому QA проверяет не только запуск теста, но и его смысл: какие условия проверяются, где возможны ложноположительные результаты и соответствует ли сценарий требованиям.
Без доступа к странице модель способна сослаться на несуществующую кнопку или выбрать неподходящий локатор. Такой код придётся исправлять вручную.
Есть и другой вариант: дать агенту доступ к браузеру, чтобы он мог исследовать интерфейс и проверять предположения на работающем приложении.
В Playwright Test Agents для этого предусмотрены три роли. Planner исследует приложение и составляет план, Generator превращает план в тесты и проверяет локаторы и утверждения при прохождении сценария, а Healer пытается исправить упавшие тесты. Это отдельный набор средств, не тот же инструмент, что Codegen.
Запрос → исследование приложения → план → создание и проверка теста.
Похожую задачу решают специализированные агентные системы, но их сценарии работы и результаты могут отличаться.
Способ 4. Передать системе готовый тест-кейс
В реальном проекте часто не нужно придумывать сценарий заново. В системе управления тестированием уже лежат тест-кейсы с предусловиями, шагами и ожидаемыми результатами. Проблема в том, что многие из них до сих пор выполняют вручную.
Вместо свободного запроса к модели можно взять конкретный тест-кейс и поручить агенту выполнить именно его.
Так работает Test AI: исходным материалом служит готовый тест-кейс. Сценарии можно получать из Test IT или импортировать из XLSX. Система автоматически распознаёт выгрузки Zephyr Scale, DoQA и Allure TestOps. Для других TMS предусмотрен импорт по шаблону Test AI.
Агент читает шаги, взаимодействует с приложением в браузере и сопоставляет полученное состояние с ожидаемым. На основе пройденных действий система формирует автотест.
Как устроена работа с тестами в Test AI
В Test AI работа начинается со списка тест-кейсов, а не с диалога с чат-ботом. Можно открыть сценарий, посмотреть его шаги и ожидаемые результаты.
Тест-кейсы распределены по разделам. Рядом указан статус автоматизации: «Новый», «В процессе», «Требует доработки» или «Готов».
 Скриншот 1. Список тест-кейсов в Test AI
Таким образом, у тест-кейса появляется отдельный статус автоматизации.
По нему видно, какие сценарии уже обработаны, какие выполняются сейчас и где нужен QA.
Это позволяет работать с имеющейся тестовой документацией, не начиная каждый раз с пустого файла автотеста.
От ручного сценария к действиям в браузере
Откроем тест-кейс: система показывает последовательность шагов и ожидаемый результат для каждого из них.
Первый шаг может выглядеть так:
Авторизоваться в системе, используя логин и пароль.
После запуска Test AI открывает приложение во встроенном браузере. По описанию системы, работу распределяют несколько агентов: один разбирает сценарий и планирует шаги, другой выполняет действия в интерфейсе, третий оценивает результаты, а ещё один собирает автотест из пройденной последовательности. Для QA важен прежде всего видимый результат: что агент сделал и что проверил.
При этом тестировщик может сопоставить действия агента с исходным тест-кейсом и заметить, если тот отклонился от нужного маршрута.
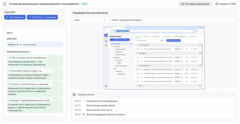 Скриншот 2. Генерация сценария во встроенном браузере
Отличие от Codegen здесь принципиальное: QA задаёт цель и ожидаемый результат, а путь по интерфейсу ищет агент.
Ожидаемый результат превращается в конкретные проверки
В тест-кейсе может быть написано «Задача успешно создана». Для автоматизированной проверки этого мало: нужно определить, по каким признакам понять, что задача действительно существует.
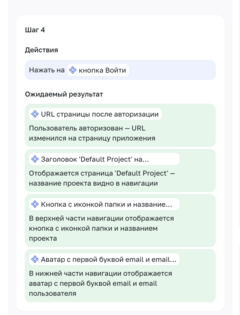 Скриншот 3. Шаги
Чем конкретнее ожидаемый результат, тем меньше агенту приходится додумывать.
Например, можно оставить короткую формулировку: «Задача успешно создана».
Или описать наблюдаемое поведение:
После сохранения открывается карточка новой задачи, в ней отображается введенное название, а задача появляется в списке задач текущего пространства.
Во втором варианте указаны проверяемые признаки: открылась карточка, совпало название, запись появилась в списке. Но даже такую проверку QA должен сверить с требованиями.
Если исходный тест-кейс расплывчатый, агент может выбрать недостаточную проверку. Автоматизация не исправляет ошибки тест-дизайна сама по себе.
Тестовые данные тоже нужно подготовить
Чтобы агент мог пройти сценарий, ему нужны подходящие тестовые данные.
В Test AI предусмотрены переменные: вместо логина и пароля прямо в шагах можно указать их имена, а значения задать отдельно.
Для чувствительных значений предусмотрено хранение в виде секретов. При подготовке скриншотов такие значения и данные клиентов не должны попадать в публикацию.
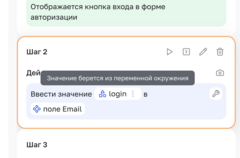 Скриншот 4. Настройка тестовых переменных
Но переменные не решают вопрос с состоянием окружения.
Для повторяемого запуска нужны доступный стенд, подходящая учётная запись, подготовленные данные и понятные предусловия. Иначе тест может падать по причинам, не связанным с проверяемой функцией.
Агент берёт на себя выполнение шагов, но подготовка условий остаётся задачей команды.
А если Test AI не смог пройти сценарий?
Не каждый сценарий агент сможет пройти с первой попытки. Например, элемент интерфейса может оказаться перекрыт модальным окном или выпадающим меню.
Так произошло в одном из показанных сценариев: выполнение остановилось на четвёртом шаге.
Агент должен был выбрать значение Password в списке Data Type, но не смог нажать на нужный элемент. В интерфейсе появилось объяснение:
Кнопка заблокирована полупрозрачным слоем, который не позволяет на неё нажать. Закройте открытое диалоговое окно или меню перед выполнением этого шага.
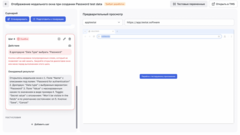 Скриншот 5. Test AI не смог выполнить действие из-за перекрывающего элемента интерфейса
Test AI не продолжил выполнять следующие шаги: проблемное действие отмечено ошибкой, а сценарий получил статус «Требует доработки».
QA видит исходный шаг и текущее состояние приложения рядом друг с другом. Поэтому можно проверить, действительно ли элемент был перекрыт, и понять, что мешало выполнению.
Действие «выбрать Password» выглядит простым, но его успех зависит от состояния страницы: не открыто ли другое меню, не перекрыт ли список и доступен ли нужный элемент для клика.
Остановка ещё не означает дефект продукта. Агент мог выбрать неверную последовательность действий или не закрыть меню. Но возможна и ошибка интерфейса, если обычный пользователь также не смог бы выполнить шаг. Чтобы различить эти случаи, QA нужно воспроизвести ситуацию и посмотреть на поведение приложения.
После разбора причины QA может уточнить шаг тест-кейса, исправить предусловия или завести дефект на продукт. Затем сценарий можно запустить повторно.
Что происходит с готовым тестом
Сформированный автотест можно выгрузить и добавить в репозиторий команды. Дальше его можно включить в привычный процесс запуска и поддержки тестов.
Возможность экспорта важна, если команда хочет хранить тесты и управлять их изменениями в своём проекте.
Получается следующая цепочка:
тест-кейс → Test AI → прохождение приложения → проверки → готовый автотест → репозиторий команды.
Чем способы генерации отличаются друг от друга
Способы отличаются тем, кто проходит сценарий, кто создаёт код и кто отвечает за проверку результата.
Способ
Что делает QA
Что делает инструмент
Ручное написание автотестов
Проектирует сценарий и полностью реализует его программно
Выполняет готовый тест
Запись действий
Сам проходит сценарий в браузере
Превращает действия в код
Универсальный ИИ
Описывает задачу и проверяет получившийся код
Генерирует программную реализацию
Test AI
Подготавливает тест-кейс, тестовые данные и контекст продукта. Проверяет корректность прохождения бизнес-сценария в интерфейсе приложения и соответствие результата ожидаемому поведению.
Анализирует тест-кейс, определяет последовательность действий, выполняет их в браузере и проверяет результат. На основе фактически выполненных действий формирует автоматизированный тест.
Выбор зависит от того, что уже есть у команды: кодовая база автотестов, ручные сценарии, инфраструктура и специалисты для поддержки.
Ручное написание подходит, когда важно управлять архитектурой тестов и нестандартной подготовкой данных.
Codegen быстро создаёт заготовку из действий, которые тестировщик выполняет сам.
ИИ-помощники ускоряют работу с кодом, но результат требует проверки.
Test AI ориентирован на команды с готовыми тест-кейсами: агент использует их как основу для прохождения сценария и подготовки автотеста.
Что остаётся за QA
В Test AI тестировщику не нужно вручную повторять каждое действие в браузере, чтобы получить основу автотеста.
Однако сценарий всё равно должен быть проверяемым: шаги — однозначными, данные — воспроизводимыми, а ожидаемый результат — наблюдаемым.
Распределение работы меняется:
QA готовит сценарий и данные → агент проходит приложение → QA проверяет бизнес-логику и ожидаемые результаты → команда получает автотест.
Критерий успеха — не зелёный статус и не сам факт появления кода. Тест должен обнаруживать нарушение бизнес-требования, ради которого его создавали. Проверить это по-прежнему должен человек.
Браузерные автотесты и раньше умели нажимать кнопки и проверять интерфейс. Новое здесь — способ построения сценария из человеческого описания.
Инженер может написать тест сам, записать действия через Codegen или использовать ИИ для генерации кода. Test AI предлагает ещё один путь: взять готовый тест-кейс вместе с контекстом продукта и поручить агенту прохождение сценария в браузере.
В конечном счёте качество проверки зависит от тест-дизайна: что именно проверяется, на каких данных и какое наблюдаемое поведение подтверждает, что функция работает правильно.
Источник: habr.com