
Способ обогатить языковую модель фактологией без модификации механизма внимания, потери глобального контекста и квадратичной сложности инференса
Трансформеры отлично улавливают контекст, но не обладают фактологическими знаниями: они не знают явно, что «метод опорных векторов» — это алгоритм классификации. Существующие способы прямой интеграции графа знаний в механизм внимания трансформера (такие как K‑BERT или ERNIE) требуют значительных вычислительных ресурсов со сложностью  , вносят семантический шум и жестко упираются в лимит в 512 токенов, что критично для объемных научных статей. В данном материале предлагается альтернативный, вычислительно эффективный путь. Идея состоит в том, чтобы заранее вычислить эмбеддинги узлов графа с помощью алгоритмов вроде TransE, RotatE или node2vec, а на этапе инференса извлекать их по ключу за время
 и объединять с вектором RuBERT перед итоговым классификатором. Ниже мы разберем специфику предметной области, сравним существующие архитектуры и опишем математику гибридного метода слияния модальностей.
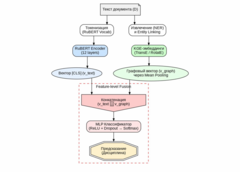 Рис.1 Блок‑схема предложенного метода: интеграция контекстных представлений RuBERT и графа знаний перед итоговым MLP‑классификатором.
Зачем всё это
Научных публикаций становится экспоненциально больше. Вручную рубрицировать и индексировать их уже невозможно, поэтому острая потребность в автоматической классификации очевидна. Казалось бы, можно взять классический BERT, дообучить его на размеченных статьях и получить отличный результат. Для текстов общей тематики так и есть. Но научно‑технические тексты устроены иначе: они содержат узкоспециализированную терминологию, редкие сущности и сложные концептуальные связи, которые слабо отражаются в базовой статистике совместной встречаемости слов.
Трансформер учится на распределении токенов. Он может «знать», что «градиентный спуск» и «оптимизация» часто стоят рядом, но явного понимания того, что первое является разновидностью второго, у него нет. При столкновении с междисциплинарными терминами или текстами с дефицитом контекста одних статистических паттернов не хватает. Граф знаний, напротив, хранит такие связи явно в виде семантических триплетов, состоящих из субъекта, отношения и объекта. Интеграция этой верифицируемой онтологии в процесс дообучения языковых моделей позволяет преодолеть слепоту трансформеров к фактам. Вопрос заключается лишь в том, как передать эти знания модели, не потеряв скорость инференса и не обрезав половину статьи из‑за лимитов памяти.
Часть 1. Что уже есть (и почему это не подходит)
1.1. SciBERT и проблема сдвига предметной области
Оригинальный BERT обучался на Википедии и BookCorpus, что охватывает преимущественно общую лексику. Попытка применить его к науке вызывает так называемый сдвиг предметной области (domain shift). Стандартный алгоритм токенизации WordPiece разбивает сложные термины на бессмысленные фрагменты, теряя их семантику. В качестве решения был предложен SciBERT, предобученный на 1,14 млн полных текстов научных статей. Его главное отличие — специализированный словарь SciVocab, построенный с нуля на научном корпусе. Он сохраняет целостность терминов, давая заметный прирост метрик в научных задачах.
Однако у SciBERT есть существенные ограничения. Во‑первых, это проблема языка и морфологии: для русскоязычных научно‑технических текстов эффективнее использовать RuBERT, который заметно превосходит мультиязычные аналоги на локальных задачах. Во‑вторых, сохраняется проблема отсутствия фактологии. Модель по‑прежнему опирается только на контекстную статистику и не имеет доступа к структурированным онтологиям.
1.2. K‑BERT: знания прямо в механизм внимания
Архитектура K‑BERT осуществляет инжекцию знаний непосредственно в процесс обработки последовательности. Алгоритм находит в тексте сущности, извлекает их триплеты из графа и подшивает к предложению, превращая его в дерево. Это достигается за счет внедрения soft‑position embedding, где токены знаний получают позиционные индексы, продолжающие индекс базового слова, и матрицы видимости (visible matrix), которая ограничивает вычисление весов внимания только рамками своего предложения и своей ветви знаний, предотвращая семантический шум.
Несмотря на элегантность, для длинных научных текстов этот подход скрывает критические минусы. Рост последовательности за счет триплетов делает квадратичную сложность self‑attention неподъемной. Стандартный лимит в 512 токенов исчерпывается мгновенно, вынуждая обрезать глобальный контекст статьи. Кроме того, возникает проблема Entity Linking: если составной термин привязывается к неверному узлу графа, эта ошибка через механизм внимания напрямую отравляет векторное представление всего текста.
Источник: habr.com