
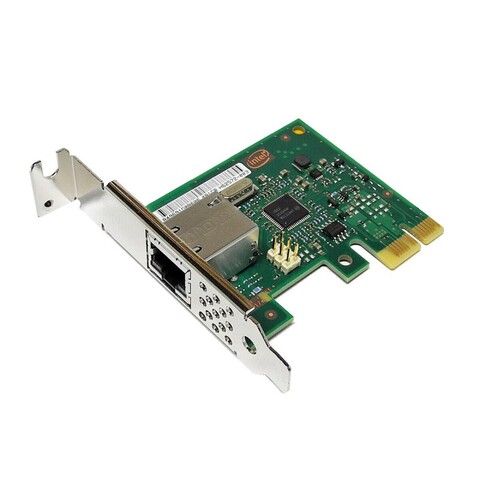
В этой статье разработаем драйвер сетевой карты Intel I210 под Linux.
Разрабатывать данный драйвер я решил в учебных целях, чтобы чуть глубже погрузиться в сетевой стек ядра Linux. Так что если будут замечания, то пишите в комментариях.
В качестве подопытного сетевого устройства я выбрал гигабитный сетевой контроллер Intel I210 с интерфейсом PCI Express (PCIe). Выбор пал именно на Intel I210 по причине его доступности и открытой документации.
 Вот такую сетевух будем прогать
Рассмотрим архитектуру Intel I210, разберём теорию по MAC, PHY, DMA и PCI. Поймём как устроен механизм обнаружения PCI устройства в Linux, доступ к аппаратным регистрам через MMIO. После этого перейдём к передаче и приёму Ethernet пакетов. Рассмотрим sk_buff, DMA API ядра Linux, TX/RX дескрипторы и очереди. Разберём аппаратные прерывания, MSI/MSI‑X, интеграцию NAPI с обработкой пакетов.
Содержание
-
1. Теория по MAC, PHY, DMA и PCIe
-
1.1. Путь сетевого пакета от приложения до сетевой карты
-
-
2. Немного про Vendor ID, Device ID, BAR
-
2.1. Адрес PCI устройства и его идентификаторы
-
2.2. Что такое PCI функция?
-
2.3. Конфигурационное пространство PCI
-
2.4. Обнаружение PCI устройств в Linux
-
2.5. Связывание PCI устройств с драйверами
-
2.6. BAR и MMIO
-
-
3. Обработка прерываний и механизм NAPI
-
3.1. Классическая обработка через аппаратные прерывания
-
3.2. NAPI: гибридный подход
-
3.2.1. Чем NAPI отличается от модели до его появления
-
-
3.3. Polling и Busy Polling
-
3.4. Что используется в нашем драйвере
-
-
4. От теории к практике
-
4.1. Регистрация в подсистеме PCI
-
4.2. Инициализация устройства в probe()
-
4.3. Отображение области MMIO
-
4.4. Регистрация сетевого интерфейса
-
4.5. Операции сетевого интерфейса
-
-
5. Выполнение i210_open()
-
5.1. Сброс Intel I210
-
5.2. Инициализация MAC фильтра
-
5.3. Инициализация PHY
-
5.4. Автосогласование скорости
-
5.5. Настройка TX буферов
-
5.6. Выделение памяти TX буферов
-
5.7. Выделение памяти RX буферов
-
5.8. Настройка RX буферов
-
5.9. Настройка MAC для передачи и приёма
-
5.10. Настройка прерываний MSI
-
5.11. Включение NAPI и настройка источников прерываний
-
5.12. Проверка физического соединения и запуск сетевой очереди
-
-
6. Передача и приём данных
-
6.1. Передача данных: i210_xmit()
-
6.1.1. Проверка доступности TX кольца
-
6.1.2. Подготовка DMA буфера
-
6.1.3. Заполнение TX дескриптора
-
6.1.4. Передача дескриптора сетевой карте
-
-
6.2. Очистка TX кольца: i210_clean_tx()
-
6.3. Приём пакетов: RX descriptor ring
-
6.4. Обработка RX пакетов: i210_clean_rx()
-
6.4.1. Повторное заполнение RX дескриптора
-
-
6.5. Как RX и TX объединены в NAPI
-
-
7. Компиляция и запуск некоторых тестов
-
7.1. Компиляция и загрузка драйвера
-
7.2. Проверка передачи и приёма пакетов
-
7.3. Измерение пропускной способности
-
-
8. Вывод
В ядре Linux уже есть драйвер igb, поддерживающий Intel I210. Его код можно найти в исходниках Linux. Повторюсь, что моя цель всё‑таки больше учебная, хочется написать базовый функционал драйвера, разобраться во взаимодействии сетевого контроллера с ядром Linux, а не полностью повторить имеющийся драйвер от Intel.
Параметры системы на которой я буду запускать драйвер:
~ > cat /etc/os-release PRETTY_NAME="Ubuntu 24.04 LTS"NAME="Ubuntu"VERSION_ID="24.04"VERSION="24.04 LTS (Noble Numbat)"~ > uname -r 7.0.0-34-generic~ > gcc --version gcc (Ubuntu 13.3.0-6ubuntu2~24.04.1) 13.3.01. Теория по MAC, PHY, DMA и PCIe
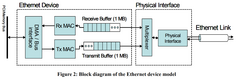 Упрощённая схема Ethernet устройства
Если кратко, то MAC(Medium Access Control) обрабатывает Ethernet фреймы, а PHY(Physical Layer Transceiver) отвечает за передачу и приём сигналов на физическом уровне Ethernet.
MAC(Medium Access Control) — подуровень канального уровня, который отвечает за управление доступом к физической среде передачи данных и доставку Ethernet кадров узлу назначения в соответствии с его MAC адресом без гарантий доставки данных. PHY(Physical layer) — самый нижний уровень модели OSI, его главная задача — перевод цифровых данных в аналоговые сигналы среды передачи, и наоборот.
Аппаратный MAC реализует часть функций канального уровня Ethernet. Драйвер Linux обеспечивает взаимодействие аппаратуры с сетевым стеком, то есть драйвер настраивает контроллер, организует передачу и приём пакетов, управляет очередями и обрабатывает события от устройства.
MAC и PHY могут быть реализованы в отдельных микросхемах или интегрированы в один контроллер. Для обмена данными между отдельными MAC и PHY используются цифровые интерфейсы, например MII, RMII, GMII, RGMII или SGMII. Конкретный интерфейс зависит от архитектуры устройства и требуемой скорости. В Intel I210 MAC и PHY/PCS взаимодействуют через внутренний интерфейс GMII/MII. Для гигабитного режима используется GMII.
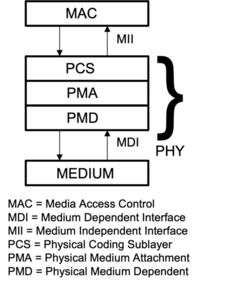
Сетевая модель IEEE 802.3 Источник PCS(Physical Coding Sublayer) — подуровень физического кодирования данных, преобразующего поступающие от уровня MAC байты в символы логического кода, например 4B/5B или 64B/66B. PMA(Physical Media Attachment) — подуровень, который соединяет интерфейс, зависящий от физической среды (MDI), с подуровнем физического кодирования (PCS). PMD(Physical Medium Dependent) — которые обеспечивают формирование сигналов в соответствии с методом физического кодирования.
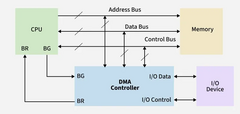 Структурная схема взаимодействия с контроллером DMA
DMA(Direct Memory Access) — это механизм, позволяющий устройству читать данные из оперативной памяти и записывать их туда без того, чтобы CPU вручную копировал каждый байт между устройством и памятью.
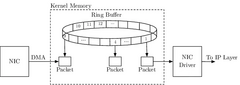 Кольцевой буфер дескрипторов
В Intel I210 DMA организован через очереди передачи TX(Transmit) и приёма RX(Receive). Каждая очередь использует кольцо дескрипторов — массив дескрипторов, доступный контроллеру через DMA. Дескриптор содержит DMA адрес, длину и управляющие поля. При TX контроллер читает из памяти дескрипторы и буферы отправляемых пакетов. При RX контроллер записывает полученные данные в буферы, заранее подготовленные драйвером.
PCI(Peripheral Component Interconnect) — это периферийный интерфейс через который сетевуха Intel I210 будет взаимодействовать с системой. Intel I210 поддерживает PCIe 2.1 с одной линией передачи (x1). PCI состоит из линий передачи данных, каждая линия использует отдельные дифференциальные пары для передачи и приёма, поэтому обмен может идти одновременно в обоих направлениях.
При инициализации PCI устройства, ядро Linux обнаруживает контроллер, читает его идентификаторы и выделенные ресурсы. Драйвер получает доступ к регистрам через MMIO (Memory‑Mapped I/O — ввод‑вывод с отображением на память).
1.1. Путь сетевого пакета от приложения до сетевой карты
Общая схема передачи и приёма данных для Intel I210 на уровнях L1 и L2 описана в документации в этих разделах: 1.8.1 Transmit Data Flow и 1.8.2 Receive Data Flow
А вообще, в данном разделе хотел бы описать передачу пакета из простарнства пользователя до сетевой карты, чтобы сложилось общее представление какой путь проходит сетевой пакет прежде чем попадёт на уровень драйвера устройства.
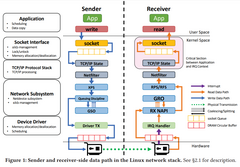 Примерный путь сетевых пакетов в Linux
Рассмотрим передачу данных через UDP‑сокет с помощью sendto(). В примере ниже предполагается, что сокет предварительно связан с адресом назначения через connect(), поэтому адрес в sendto() не передаётся:
sendto(sockfd, buf, len, flags, NULL, 0);После вызова sendto() управление переходит из пространства пользователя в ядро. Данные копируются из пользовательского буфера в память ядра и передаются обработчику соответствующего протокола.
1.1.1. Обработка на транспортном уровне
В зависимости от типа сокета ядро вызывает соответствующую функцию обработки:
-
udp_sendmsg()— для UDP -
tcp_sendmsg()— для TCP
В обоих случаях данные из пользовательского буфера копируются в память ядра и представляются с помощью struct sk_buff, которая используется сетевым стеком для хранения данных пакета и связанных с ним метаданных. При этом конкретный способ подготовки sk_buff зависит от протокола.
Для UDP формируется UDP‑заголовок, содержащий порты отправителя и получателя, длину и контрольную сумму. Как правило, одна отправка UDP‑сообщения соответствует одной UDP‑дейтаграмме. Подготовленный пакет передаётся на IP‑уровень.
Для TCP обработка сложнее: данные помещаются в очередь отправки сокета, после чего TCP определяет момент передачи, формирует сегменты и добавляет необходимые заголовки. TCP может объединять данные нескольких вызовов send() или разбивать поток на несколько сегментов, поэтому нельзя считать, что один вызов send() обязательно соответствует одному sk_buff.
1.1.2. IP Layer — маршрутизация
На сетевом уровне ядро формирует IP заголовок и определяет маршрут передачи пакета.
Для TCP одним из этапов передачи является вызов ip_queue_xmit(). Эта функция выполняет поиск маршрута и подготавливает пакет к передаче на IP‑уровень, включая формирование IP‑заголовка. Далее пакет проходит через функции IP‑уровня, в том числе ip_output().
Для UDP используется другой путь отправки: udp_sendmsg() подготавливает UDP‑дейтаграмму и передаёт её в IP‑уровень через UDP/IP‑функции отправки. Поэтому ip_queue_xmit() не следует считать общей функцией для TCP и UDP.
На выходе IP‑уровня пакет проходит через соответствующие хуки Netfilter. Например, могут применяться правила фильтрации или NAT. Конкретное расположение хуков зависит от этапа обработки: для локально сформированного пакета важны, в частности, LOCAL_OUT и POST_ROUTING.
1.1.3. Ethernet Layer — подготовка кадра
После определения маршрута необходимо подготовить Ethernet кадр.
Ядро определяет MAC адрес следующего узла через таблицу соседей (neighbour table). Если адрес неизвестен, для IPv4 может потребоваться ARP‑запрос.
Затем формируется Ethernet заголовок с MAC адресами отправителя и получателя.
После этого пакет передаётся функции dev_queue_xmit(), которая запускает его передачу через выбранный сетевой интерфейс.
Внутри dev_queue_xmit() пакет проходит через механизм управления трафиком (Traffic Control, TC), включая egress обработку и соответствующую очередь qdisc.
1.1.4. Передача пакета драйверу
На этапе передачи (egress) пакет может ожидать в очереди, например, если сетевой интерфейс временно не готов принять новые данные от вышележащего уровня. Когда приходит время передачи, ядро вызывает метод ndo_start_xmit() из структуры net_device_ops.
В нашем драйвере этот метод будет связан с функцией i210_xmit():
static const struct net_device_ops i210_netdev_ops = { .ndo_open = i210_open, .ndo_stop = i210_close, .ndo_start_xmit = i210_xmit,};В i210_xmit() передаётся указатель на структуру sk_buff, содержащую данные пакета и необходимые метаданные.
Драйвер подготавливает TX дескриптор, отображает буфер с данными в DMA адресное пространство и помещает дескриптор в TX кольцевой буфер. Сетевая карта получает информацию о новых дескрипторах и самостоятельно считывает данные из оперативной памяти с помощью DMA.
Чуть далее на практике разберём работу i210_xmit().
Сетевой стек Linux отвечает за подготовку и маршрутизацию пакета, а драйвера за передачу данных в сеть.
2. Немного про Vendor ID, Device ID, BAR
Нужно разобраться как Linux обнаруживает PCI устройства, идентифицирует их и предоставляет драйверу доступ к аппаратным ресурсам.
2.1. Адрес PCI устройства и его идентификаторы
Каждое PCI устройство имеет адрес, состоящий из четырёх частей: домена, шины, устройства и функции.
Если выполнить lspci -nn, то для Intel I210 можно увидеть примерно такой вывод:
02:00.0 Ethernet controller [0200]: Intel Corporation I210 Gigabit Network Connection [8086:1533] (rev 03)02:00.0 — адрес устройства, оно находится на шине 02, устройство номер 00 и функция 0. 8086 — Vendor ID, 16 битный идентификатор производителя Intel. 1533 — Device ID, 16 битный идентификатор конкретного устройства. [0200] — Class Code в сокращённом представлении lspci: класс 02 обозначает сетевой контроллер, а подкласс 00 это Ethernet контроллер. rev 03 — идентификатор аппаратной ревизии устройства.
Vendor ID и Device ID используются для идентификации устройства, а Class Code позволяет определить его функциональную категорию, например, два Ethernet устройства могут иметь одинаковый Class Code, но разные Vendor ID и Device ID.
2.2. Что такое PCI функция?
Одна шина может содержать до 32 устройств, а каждое устройство может иметь до восьми функций с номерами от 0 до 7.
PCI функция представляет собой отдельный логический интерфейс устройства с собственным конфигурационным пространством и идентификаторами. Одно физическое PCI устройство может включать несколько функций, каждая из которых предоставляет определённый набор возможностей и может обслуживаться отдельным драйвером. Например, одна PCI карта может содержать сетевой контроллер и UART контроллер, для которых будут использоваться разные драйверы.
2.3. Конфигурационное пространство PCI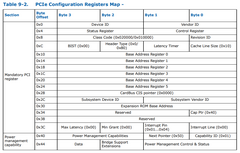 Некоторая часть конфигурационных регистров Intel I210
Каждое PCI устройство имеет конфигурационное пространство, в котором хранятся его идентификаторы, сведения о возможностях и параметры ресурсов. В начале расположены стандартные поля, включая Vendor ID, Device ID, Class Code и BAR(0×10-0×24).
2.4. Обнаружение PCI устройств в Linux
При запуске системы, Linux исследует доступные PCI шины и обнаруживает подключённые устройства. Для проверки адресов выполняются операции чтения конфигурационного пространства.
Когда устройство обнаружено, ядро получает его Vendor ID, Device ID, Class Code и другие параметры. Оно также определяет требуемые устройству ресурсы. На этапе начальной настройки BAR регистры(подробнее в даташите 9.3.11 Base Address Registers) используются для определения типа и размера ресурсов, после чего адресные диапазоны распределяются с учётом возможностей платформы.
После обнаружения ядро создаёт объекты PCI устройств и сохраняет сведения об их идентификаторах и ресурсах. Затем подсистема PCI сопоставляет обнаруженные устройства с таблицами идентификаторов зарегистрированных драйверов. Если драйвер подходит, ядро вызывает его функцию probe(). К моменту вызова probe() подсистема PCI уже обнаружила устройство и знает описание PCI ресурсов этого устройства.
PCI драйвер не ищет устройство на PCI шине самостоятельно. Он получает от ядра описание уже обнаруженной PCI функции и подготавливает её к работе.
2.5. Связывание PCI устройств с драйверами
Для регистрации PCI драйвера мы будем записывать Vendor ID и Device ID в struct pci_device_id. В ней перечисляются идентификаторы, по которым ядро может сопоставить обнаруженное устройство с драйвером.
Когда драйвер регистрируется в ядре, подсистема PCI сопоставляет его таблицу с уже обнаруженными устройствами. Если находится подходящее совпадение, ядро вызывает probe().
2.6. BAR и MMIO
BAR(Base Address Register) — это регистр конфигурационного пространства PCI, с помощью которого устройство описывает предоставляемый системе ресурс, например, область памяти, доступную через MMIO(Memory‑Mapped I/O). BAR не содержит сами регистры управления и не является указателем на них. Он описывает ресурс, который подсистема PCI распределяет в адресном пространстве системы. BAR — регистр конфигурационного пространства, описывающий ресурс устройства. MMIO область — адресный диапазон, через который CPU может обращаться к регистрам устройства. Отображение MMIO — получение драйвером подходящего адреса в виртуальном адресном пространстве ядра, через который выполняется доступ к регистрам.
Для лучшего понимания, вот такой примерный алгоритм будет у нас при работе с ресурсами PCI устройства:
-
Включить PCI устройство с помощью
pci_enable_device(). -
Запросить необходимые PCI ресурсы через
pci_request_selected_regions(). -
Отобразить область MMIO с помощью
pci_iomap(). -
Будем использовать
readl()иwritel()для доступа к памяти устройства, а для доступа к конфигурационному пространству будем использоватьpci_read_config_word()
3. Обработка прерываний и механизм NAPI
После настройки кольцевых TX и RX очередей необходимо организовать механизм, с помощью которого процессор будет узнавать о событиях сетевого контроллера. Например, о поступлении новых пакетов или завершении передачи.
Для этого сетевые контроллеры могут использовать аппаратные прерывания. Однако обработка каждого пакета непосредственно в обработчике прерывания негативно сказывается на производительности при большом трафике. В Linux для решения этой проблемы используется NAPI (New API).
Рассмотрим три подхода: обработку через прерывания, polling и гибридный механизм NAPI.
3.1. Классическая обработка через аппаратные прерывания
В классической interrupt‑driven модели сетевая карта генерирует аппаратное прерывание при поступлении пакета или другом событии. Процессор приостанавливает выполнение текущего кода и вызывает зарегистрированный обработчик прерывания (ISR).
В Linux обработка пакета не обязательно выполнялась целиком непосредственно в IRQ контексте. Обработчик обычно подтверждал/определял причину прерывания и передавал дальнейшую работу отложенному механизму, например, bottom half, tasklet или сетевой softirq. Однако при традиционной схеме уведомление о поступлении каждого пакета могло приводить к отдельному аппаратному прерыванию, а значит, к большому количеству входов в обработчик.
При высокой скорости поступления пакетов процессор тратит значительное время на обслуживание прерываний и переключение контекстов. Даже если фактическая обработка выполняется позже в softirq, большое количество IRQ создаёт дополнительную нагрузку. В результате часть ресурсов CPU расходуется не на обработку полезных данных, а на обслуживание самих уведомлений.
Возникает задача уменьшить количество аппаратных прерываний и при этом не заставлять процессор постоянно опрашивать устройство.
3.2. NAPI: гибридный подход
NAPI (New API) — механизм Linux для обработки сетевых пакетов, который сочетает аппаратные прерывания с polling. Прерывание сообщает процессору о появлении работы, после чего драйвер временно маскирует соответствующий источник прерываний и планирует NAPI. Дальнейшая обработка выполняется опросом RX кольца, обычно сразу для нескольких готовых дескрипторов.
Ключевая идея NAPI — не вызывать полноценную обработку сетевого пакета для каждого аппаратного прерывания. Одно прерывание запускает цикл обработки, в рамках которого драйвер может забрать несколько пакетов за один проход. Это уменьшает частоту IRQ при высокой нагрузке.
Упрощённо последовательность выглядит примерно так:
-
Сетевая карта записывает принятый пакет в RX DMA буфер и обновляет статус дескриптора.
-
Контроллер генерирует прерывание.
-
Обработчик прерывания определяет причину события, маскирует соответствующий источник прерываний и планирует NAPI.
-
Ядро вызывает NAPI callback драйвера.
-
Драйвер проверяет RX дескрипторы и обрабатывает готовые пакеты. За один проход разрешено обработать не более
budget(будем его задавать далее) пакетов. -
Если за проход обработано меньше
budgetпакетов, драйвер завершает NAPI и снова разрешает прерывания. -
Если достигнут
budget, обработка продолжается следующим проходом polling без повторного включения прерываний.
Т.е. при небольшой нагрузке интерфейс быстро реагирует на прерывания, а при высокой нагрузке NAPI позволяет обработать сразу несколько пакетов за один проход, уменьшая количество аппаратных прерываний.
Важно, что NAPI не означает постоянный бесконечный опрос RX кольца. Опрос запускается после прерывания и продолжается, пока есть работа или пока не исчерпан выделенный бюджет.
3.2.1. Чем NAPI отличается от модели до его появления
В классической модели каждый принятый пакет мог вызывать отдельное аппаратное прерывание. Обработчик прерывания выполнял минимальную работу и, как правило, передавал обработку пакета в отложенный контекст, например, в сетевой softirq. При большом потоке пакетов CPU получал множество отдельных уведомлений, даже если обработка самих пакетов уже выполнялась вне hard IRQ.
NAPI меняет именно модель уведомления и последующего получения пакетов:
-
До NAPI: поступление пакета обычно приводило к аппаратному прерыванию; обработчик подтверждал событие и инициировал отложенную обработку. При интенсивном трафике число прерываний могло быть очень большим.
-
С NAPI: первое прерывание запускает polling и маскирует соответствующий источник IRQ. Драйвер последовательно проверяет RX дескрипторы и обрабатывает несколько готовых пакетов за один проход. Пока NAPI запланирован, новые пакеты обычно обнаруживаются polling‑ом, а не отдельными прерываниями на каждый пакет.
-
Когда очередь опустела: драйвер завершает NAPI и снова разрешает прерывания. Следующее поступление пакетов снова может вызвать IRQ и запустить новый цикл.
Обработка в NAPI выполняется в контексте сетевого softirq (обычно NET_RX_SOFTIRQ), а не внутри hard IRQ handler. Это позволяет ограничивать объём работы за один проход с помощью budget и возвращать управление планировщику, если очередь остаётся загруженной. При этом NAPI не отменяет аппаратные прерывания полностью — они используются для перехода от ожидания к polling.
Таким образом, главное отличие NAPI — это пакетная обработка и временное подавление повторных прерываний на время опроса очереди, а не просто перенос обработки из обработчика прерывания в softirq.
3.3. Polling и Busy Polling
Ещё один подход — это постоянный опрос RX кольца (polling). В этом случае процессор циклически проверяет статусы дескрипторов и обрабатывает появившиеся пакеты, не ожидая аппаратного прерывания.
Преимущество такого подхода — минимальная задержка между появлением пакета в памяти и началом его обработки. Процессору не требуется ждать прерывание и переключаться в обработчик.
Недостаток — процессорное ядро постоянно занято проверкой очереди, даже когда новых пакетов нет. Это приводит к повышенной загрузке CPU и энергопотреблению. Поэтому такой вариант имеет смысл, когда важна минимальная задержка и можно выделить отдельное процессорное ядро под обработку сетевого трафика.
Нужно различать обычный polling внутри драйвера, механизм NAPI и busy polling Linux. В Linux существуют механизмы busy polling, позволяющие приложению или сетевому стеку инициировать опрос NAPI для уменьшения задержки. Отдельный вариант — это пользовательские сетевые фреймворки, например DPDK, где приложение может самостоятельно опрашивать RX очереди, обходя обычный путь обработки пакетов через сетевой стек Linux.
3.4. Что используется в нашем драйвере
В нашем драйвере будет использоваться NAPI совместно с MSI. При выделении вектора вызывается pci_alloc_irq_vectors() с флагом PCI_IRQ_MSI и минимальным/максимальным количеством векторов, равным одному. То есть в текущей реализации используется один MSI‑вектор, а не MSI‑X.
После регистрации обработчика через request_irq() и включения NAPI контроллер может генерировать прерывания при событиях RX/TX очереди. Обработчик i210_interrupt() не должен выполнять полноценную обработку пакетов. Его задача — определить причину прерывания, временно замаскировать соответствующий источник и запланировать NAPI через napi_schedule().
Далее ядро вызывает функцию i210_clean(). В ней выполняется обработка RX дескрипторов через i210_clean_rx() и очистка завершённых TX дескрипторов через i210_clean_tx(). Для RX используется budget, ограничивающий количество пакетов за один проход.
Когда RX пакетов для обработки больше нет и work_done меньше budget, драйвер завершает NAPI с помощью napi_complete_done() и снова разрешает прерывания очереди через регистр EIMS. Если же budget исчерпан, NAPI остаётся запланированным, и ядро продолжает polling.
Аппаратное прерывание используется как сигнал о появлении работы, а непосредственная обработка RX/TX дескрипторов выполняется в NAPI callback. Это позволяет избежать обработки каждого пакета в контексте аппаратного прерывания и уменьшить нагрузку на CPU при интенсивном сетевом трафике.
В текущем варианте RX и TX обслуживаются одним NAPI callback, но это не означает, что завершение TX автоматически вызовет NAPI. Нужно проверить, что источник прерывания TX действительно разрешён и отображён на используемый вектор, либо что очистка TX гарантированно запускается другим событием. В противном случае завершённые TX дескрипторы могут оставаться неочищенными, а очередь передачи не возобновляться после остановки.
4. От теории к практике
Напишим probe() с регистрацией pci драйвера, отобразим область MIMO, прочитаем MAC адрес из сетевой карточки и выполним регистрацию сетевого интерфейса через net_device. Реализуем приём и передачу данных.
4.1. Регистрация в подсистеме PCI
Для работы с PCI подсистемой Linux нужно описать в драйвере структуру struct pci_driver. У меня она выглядит вот так:
static struct pci_driver i210_driver = {.name = DRV_NAME,.id_table = i210_pci_tbl,.probe = i210_probe,.remove = i210_remove,.shutdown = i210_shutdown,};Подробно описывать каждое поле сейчас не буду, остановлюсь только на .id_tabel, это поле содержит указатель на таблицу PCI устройств, поддерживаемые нашим драйвером. Драйвер пишем для одного конкретного устройства с PCI ID 8086:1533, поэтому struct pci_device_id у меня выглядит так(Vendor ID и Device ID берём из даташита):
static const struct pci_device_id i210_pci_tbl[] = { {PCI_DEVICE(PCI_VENDOR_ID_INTEL, 0x1533),},{ 0, }};MODULE_DEVICE_TABLE(pci, i210_pci_tbl);Когда драйвер регистрируется в ядре, PCI подсистема сопоставляет его таблицу с уже обнаруженными устройствами. Если подходящее устройство найдено, ядро вызывает нашу i210_probe(). Для регистрации драйвера в подсистеме PCI используем pci_register_driver() с указателем на экземпляр struct pci_driver. Функция i210_init будет выполняться при загрузке модуля, а при выгрузке моделя будет выполняться функция i210_exit.
static int __init i210_init(void){ pr_info(DRV_NAME ": init()n"); return pci_register_driver(&i210_driver);}static void __exit i210_exit(void){ pr_info(DRV_NAME ": exit()n"); pci_unregister_driver(&i210_driver);}module_init(i210_init);module_exit(i210_exit);4.2. Инициализация устройства в probe()
В функции probe нам нужно будет выполнить подготовку ресурсов устройства и зарегистрировать сетевой интерфейс. Настройку передачи и приёма будем выполнять позже при открытии интерфейса.
Для доступа к регистрам Intel I210 используем MMIO, выбираем BAR и включаем устройство. После включения резервируем нужный PCI ресурс при помощи pci_request_selected_regions(). Выполнять резервирование необходимо, чтобы область ресурсов не использовалась одновременно несколькими драйверами.
//Выбираем BAR содержащие ресурсы памятиbars = pci_select_bars(pdev, IORESOURCE_MEM);if (!bars)return -ENODEV;//Включаем устройствоerr = pci_enable_device_mem(pdev);if (err) return err;//Резервируем в экслюзивное владение память, запрошенную из BARerr = pci_request_selected_regions(pdev, bars, DRV_NAME);if (err) goto err_disable_device;Для работы с DMA нужно выполнить:
pci_set_master(pdev);Это разрешает устройству выступать инициатором транзакций PCI и обращаться к оперативной памяти через DMA.
4.3. Отображение области MMIO
Память запросили, теперь можно её отобразить на пространство памяти, доступное драйверу. Вот такая сигнатура у функции pci_iomap: void __iomem pci_iomap(struct pci_dev dev, int bar, unsigned long maxlen). Второй аргумент 0 это номер BAR, а последний аргумент 0 означает, что мы отображаем весь ресурс.
//Снаружи probe() объвил структуру через которую буду выполнять доступ к памяти PCI устройстваstruct i210_hw {void __iomem *hw_addr; //Адрес области MMIO в виртуальном адресном пространствеvoid __iomem *flash_address;};adapter->hw.hw_addr = pci_iomap(pdev, 0, 0);if (!adapter->hw.hw_addr) { err = -EIO; goto err_free_netdev;}Вот так будет выглядеть чтение регистра STATUS(смещение 0×8, Table 8–6. Register Summary):
u32 status;status = readl(adapter->hw.hw_addr + 0x8);pr_info(DRV_NAME ": STATUS = 0x%08xn", status);Чтение MMIO и чтение PCI Configuration Space(Table 9–2. PCIe Configuration Registers Map) отличаются. Для PCI Configuration Space предусмотрены отдельные функции, например pci_read_config_word().
Это пример чтения Vendor ID и Device ID из PCI Configuration Space:
pci_read_config_word(pdev, 0x00, &vendor_id);pci_read_config_word(pdev, 0x02, &device_id);pr_info(DRV_NAME ": PCI Vendor ID = 0x%04xn", vendor_id);pr_info(DRV_NAME ": PCI Device ID = 0x%04xn", device_id);Пример чтения MAC адреса из iNVM — Integrated Non‑Volatile Memory (iNVM), описание регистров из раздела Flash‑Security Registers таблицы 8–6. Register Summary. Релизация вычитывания одного слова:
static int i210_read_nvm_word(struct i210_adapter *adapter, u16 offset, u16 *data){ u32 value; int timeout = 1000; /* Сигнализируем о начале чтения NVM */ value = EERD_START | ((u32)offset << EERD_ADDR_SHIFT); writel(value, adapter->hw.hw_addr + I210_EERD); do { value = readl(adapter->hw.hw_addr + I210_EERD); if (value & EERD_DONE) { *data = (u16)(value >> EERD_DATA_SHIFT); return 0; } udelay(1); } while (--timeout); pr_err(DRV_NAME ": NVM read timeout, offset=0x%04xn", offset); return -ETIMEDOUT;}Функция i210_read_nvm_word принимает смещение(offset — это адрес слова в NVM) и указатель, куда нужно записать результат.
Первые три слова NVM содержат шесть байтов MAC адреса(3.4.2 iNVM Structures):
u16 nvm_word[3];u8 mac[6];for (i = 0; i > 8;mac[2] = nvm_word[1] & 0xff;mac[3] = nvm_word[1] >> 8;mac[4] = nvm_word[2] & 0xff;mac[5] = nvm_word[2] >> 8;/* Установили MAC адрес для устройства из net_device */eth_hw_addr_set(netdev, mac);pr_info(DRV_NAME ": MAC address %pMn", netdev->dev_addr);4.4. Регистрация сетевого интерфейса
PCI драйвер обеспечивает взаимодействие с шиной и аппаратными ресурсами устройства, но для подключения сетевого контроллера к сетевому стеку Linux нужна структура net_device:
struct net_device *netdev;netdev = alloc_etherdev(sizeof(struct i210_adapter));if (!netdev) {err = -ENOMEM;goto err_release_regions;}alloc_etherdev() выделяет структуру net_device и дополнительную приватную область памяти, размер которой задаётся аргументом функции. Драйвер использует эту область для хранения собственных данных, например структуры адаптера. Сама net_device содержит параметры сетевого интерфейса и ссылки на его операции; связь с PCI устройством и отображёнными регистрами драйвер организует в своих структурах.
После настройки netdev нужно сохранить:
pci_set_drvdata(pdev, netdev);4.5. Операции сетевого интерфейса
Настройка операций сетевого интерфейса:
static const struct net_device_ops i210_netdev_ops = { .ndo_open = i210_open, .ndo_stop = i210_close, .ndo_start_xmit = i210_xmit,};i210_open — открытие сетевого интерфейса, например команда ip link set eth0 up i210_close — остановка сетевого интерфейса, например команда ip link set eth0 down i210_xmit — передача данных
После настройки операций сетевого интерфейса и NAPI вызывается:
err = register_netdev(netdev);if (err) goto err_napi;register_netdev() регистрирует сетевой интерфейс в ядре. После успешной регистрации он становится виден в юзерспейсе.
5. Выполнение i210_open()
Более подробно по регистру CTRL можно посмотреть в документации — 8.2.1 Device Control Register - CTRL
Для доступа к регистрам PHY используется регистр MAC MDIC. Драйвер записывает команду чтения или записи, затем ожидает завершения операции и проверяет наличие ошибки.
5.1. Сброс Intel I210
Сброс и базовую настройку будем выполнять в i210_open() внутри i210_reset_hw(). Перед настройкой контроллера необходимо выполниться сброс, чтобы вывести устройство из режима сна или энергосбережения, для этого будем использовать регистр CTRL.
Читаем текущее значение CTRL, затем устанавливается бит RST:
ctrl = readl(hw + I210_CTRL);ctrl |= I210_CTRL_RST;writel(ctrl, hw + I210_CTRL);После установки RST бита контроллер выполняет программный сброс. Согласно документации Intel I210, драйвер должен подождать не менее 3 мс, прежде чем обращаться к регистрам устройства после сброса(Раздел 4.3.1 Software Reset (RST)). Затем необходимо убедиться, что завершился сброс и автоматическая загрузка конфигурации из NVM.
msleep(3);status = readl(hw + I210_STATUS);if (!(status & I210_STATUS_PF_RST_DONE)) //Проверка завершён ли сброс return -ETIMEDOUT;eec = readl(hw + I210_EEC);if (!(eec & I210_EEC_AUTO_RD)) //Проверка завершено ли чтение NVM return -EIO;5.2. Инициализация MAC фильтра
Перед включением приёма пакетов необходимо настроить MAC фильтр, чтобы контроллер мог отбрасывать пакеты, не предназначенные этому устройству.
Выполняем запись MAC адреса в RAL0 и RAH0 внутри функции i210_set_mac_address:
writel(ral, hw + I210_RAL0);writel(rah | I210_RAH_AV, hw + I210_RAH0);RAL0 содержит первые четыре байта адреса, а RAH0 оставшиеся два байта и бит AV, который указываюет, что запись адреса действительна.
5.3. Инициализация PHY
Вся инициализация PHY вынесена в отдельную функцию i210_init_phy
Сначала устанавливается бит SLU в регистре CTRL, чтобы MAC уровень не игнорировал сигнлаы линка от PHY.
ctrl = readl(adapter->hw.hw_addr + I210_CTRL);ctrl |= I210_CTRL_SLU;writel(ctrl, adapter->hw.hw_addr + I210_CTRL);После чего драйвер читает управляющий регистр PHY через функцию i210_read_phy_reg и сбрасывает биты POWER DOWN и ISOLATE внутри функции i210_phy_power_up, если они установлены.
ctrl &= ~BIT(11); /* POWER DOWN */ctrl &= ~BIT(10); /* ISOLATE */5.4. Автосогласование скорости
Функция i210_phy_start_autoneg устанавливает увтосогласование скорости, устройства в сети сами будут согласовывать скорость обмена данными.
5.5. Настройка TX буферов
Перед настройкой буферов RX и TX для лучшего понимания можно почитать про кольцевые очереди — https://stackoverflow.com/questions/36625892/descriptor‑concept‑in‑nic
Перед тем как выделять ресурсы под TX буферы, нужно выполнить настройку передачи, это выполняется внутри функции i210_configure_tx_buffer:
writel(I210_TXPBSIZE_DEFAULT, hw + I210_TXPBS);writel(I210_DTXMXPKTSZ_DEFAULT, hw + I210_DTXMXPKTSZ);Регистр TXPBSIZE — 8.3.2 TX Packet Buffer Size — TXPBSIZE Регистр DTXMXPKTSZ — 8.12.9 DMA TX Maximum Packet Size
TXPBSIZE — распределение памяти для хранения передаваемых пакетов, я присваиваю туда значение 0x04000014 — это значение по умолчанию, не стал эксперементировать, оставил как в документации. На выходе получаем, что размер Txpb0size равен 20KB, а размер os2Bmcpbsize 4KB — буфер передачи данных от операционной системы
DTXMXPKTSZ задаёт максимальный размер передаваемого пакета. Значение 0x98 (152) соответствует 152 единицам по 64 байта, то есть 9728 байтам. Однако одной этой настройки недостаточно, чтобы говорить о полноценной поддержке Jumbo Frames всем драйвером. В текущей реализации RX буферы имеют размер 2048 байт, обработка пакетов, распределённых между несколькими RX дескрипторами, не реализована, а MTU интерфейса отдельно не настраивается. Поэтому в текущем варианте поддержку Jumbo Frames считать реализованной нельзя.
5.6. Выделение памяти TX буферов
Внутри функции i210_setup_tx_resources выделяется память под TX кольцо из 64 дескрипторов с помощью функции dma_alloc_coherent. Также выделяется массив buffer_info для хранения программной информации о передаваемых пакетах.
Массив buffer_info содержит информацию о каждом передаваемом пакете: указатель на sk_buff, DMA адрес буфера и его длину. Массив buffer_info используется только драйвером, а кольцо дескрипторов будет доступно аппаратуре.
5.7. Выделение памяти RX буферов
По аналогии с TX, в функции i210_setup_rx_resources задаём количество дескрипторов и вычисляем размер кольца:
rx_ring->count = I210_RX_DESC_COUNT;rx_ring->size = rx_ring->count * sizeof(struct i210_rx_desc);Далее выделяется массив buffer_info и память для самого кольца дескрипторов через dma_alloc_coherent():
rx_ring->buffer_info = kcalloc(rx_ring->count,sizeof(*rx_ring->buffer_info),GFP_KERNEL);rx_ring->desc = dma_alloc_coherent( &pdev->dev, rx_ring->size, &rx_ring->dma, GFP_KERNEL);После этого последовательно выделяем 64 сетевых буфера по 2048 байта:
skb = netdev_alloc_skb(adapter->netdev, I210_RX_BUFFER_SIZE);После выделения памяти каждый буфер отображается для DMA:
dma = dma_map_single(&pdev->dev,skb->data,I210_RX_BUFFER_SIZE,DMA_FROM_DEVICE);5.8. Настройка RX буферов
После выделения памяти для RX буфров вызывается функцияi210_configure_rx_ring в которой необходимо сообщить контроллеру, где находится RX кольцо и сколько дескрипторов в нём доступно. Для этого используются регистры: RDBAL — младшие 32 бита DMA адреса RX кольца RDBAH — старшие 32 бита DMA адреса RDLEN — размер кольца в байтах RDH — индекс головного дескриптора RDT — индекс последнего доступного дескриптора RXDCTL — управление RX очередью
Сначала записываем адрес и размер кольца:
writel(lower_32_bits(rx_ring->dma), hw + I210_RDBAL(0));writel(upper_32_bits(rx_ring->dma), hw + I210_RDBAH(0));writel(rx_ring->size, hw + I210_RDLEN(0));Настраивается регистр SRRCTL — 8.10.2 Split and Replication Receive Control — SRRCTL:
writel(0, hw + I210_SRRCTL(0));Затем устанавливаем начальные значения индексов. Поскольку перед этим драйвер подготовил все дескрипторы RX кольца, в RDT нужно передать индекс последнего подготовленного дескриптора:
writel(0, hw + I210_RDH(0));writel(rx_ring->count - 1, hw + I210_RDT(0));RDH указывает на текущую позицию, с которой контроллер начинает обработку RX кольца, а RDT задаёт границу дескрипторов, доступных контроллеру. Если записать в RDT ноль, когда подготовлено всё кольцо, контроллеру не будут доступны все подготовленные дескрипторы.
Используем нулевое значение SRRCTL, это означает, что размер RX буфера определяется полем RCTL.BSIZE, при стандартном значении RCTL.BSIZE это соответствует буферу размером 2048 байт.
5.9. Настройка MAC для передачи и приёма
После этого можно перейти к настройке MAC, для этого будем использовать функцию i210_configure_tx и i210_configure_rx.
В первой настраивается регистр TCTL— 8.12.1 Transmit Control Register — TCTL (0×0400; R/W:
tctl = readl(hw + I210_TCTL);tctl &= ~I210_TCTL_CT_MASK;/*Pad Short Packets (PSP)Retransmit on late collision (RTLC)*/tctl |= I210_TCTL_PSP;tctl |= I210_TCTL_RTLC;tctl |= I210_TCTL_CT;/*TX disabled yet*/tctl &= ~I210_TCTL_EN;writel(tctl, hw + I210_TCTL);Здесь включаются PSP и RTLC, а также устанавливается параметр CT, но саму передачу пока не включаем.
После настройки MAC вызывается функцию i210_enable_tx, которая устанавливает бит EN в TCTL
tctl = readl(hw + I210_TCTL);tctl |= I210_TCTL_EN;writel(tctl, hw + I210_TCTL);Для настройки приёма используем регистр RCTL — 8.10.1 Receive Control Register — RCTL (0×0100; R/W):
rctl = readl(hw + I210_RCTL);/*Enable receiver*/rctl |= I210_RCTL_EN;/*Accept broadcast packets*/rctl |= I210_RCTL_BAM;/*Strip Ethernet CRC*/rctl |= I210_RCTL_SECRC;writel(rctl, hw + I210_RCTL);Устанавливается бит EN, разрешающий приём пакетов, BAM для приёма широковещательных кадров и SECRC для удаления CRC из принятых кадров.
5.10. Настройка прерываний MSI
Для обработки событий контроллера будем использовать MSI (Message Signaled Interrupts).
Сначала отключаем прерывания в функции i210_disable_interrupts, чтобы во время настройки не возникало неожиданных вызовов обработчика:
void __iomem *hw = adapter->hw.hw_addr;writel(0xffffffff, hw + I210_EIMC);writel(0xffffffff, hw + I210_IMC);/*Clear pending causes*/readl(hw + I210_EICR);readl(hw + I210_ICR);Затем выделяем вектор прерывания в функции i210_alloc_irq:
err = i210_alloc_irq(adapter);if (err) goto err_free_tx;Внутри i210_alloc_irq используется `pci_alloc_irq_vectors:
ret = pci_alloc_irq_vectors(pdev, 1, 1, PCI_IRQ_MSI);В нашем случае запрашивается один MSI‑вектор. После его выделения получаем номер IRQ с помощью pci_irq_vector().
Важно различать MSI и MSI‑X. MSI использует механизм передачи сообщений для генерации прерываний и в нашей реализации выделяется один вектор. MSI‑X предоставляет более гибкую таблицу векторов и позволяет распределять разные очереди и события по нескольким прерываниям. В текущем драйвере MSI‑X не используется.
Далее регистрируем обработчик прерывания:
err = i210_request_irq(adapter);if (err) goto err_free_tx;В качестве обработчика используется i210_interrupt(). При возникновении прерывания он проверяет причину события, маскирует прерывания и планирует выполнение NAPI:
napi_schedule(&adapter->napi);Таким образом, непосредственно обработкой принятых пакетов занимается не обработчик аппаратного прерывания, а функция NAPI.
При реализации важно использовать согласованный набор регистров и причин прерывания. В I210 существуют обычные регистры маскирования/причин IMS/IMC/ICR и расширенные EIMS/EIMC/EICR. Если источник разрешается через EIMS, обработчик должен проверять соответствующую причину через EICR; нельзя без проверки смешивать эти регистры с обычными IMS/IMC/ICR.
5.11. Включение NAPI и настройка источников прерываний
NAPI контекст был создан ранее, при регистрации сетевого интерфейса в probe(), с помощью netif_napi_add().
Теперь необходимо разрешить его работу:
napi_enable(&adapter->napi);После этого вызывается i210_configure_interrupts(), которая настраивает маршрутизацию и разрешает прерывания RX/TX очереди.
Через регистр IVAR настраивается привязка прерывания к очереди, а через EIMS разрешается соответствующий
Источник: habr.com