
Привет, Хабр!
В сервисе заказов почти всегда есть две строчки подряд: orderRepository.save(order) и kafkaTemplate.send("orders", event). Первая пишет заказ в PostgreSQL, вторая сообщает складу, биллингу и уведомлениям, что заказ появился. Код проходит ревью, тесты зелёные, месяцами всё работает.
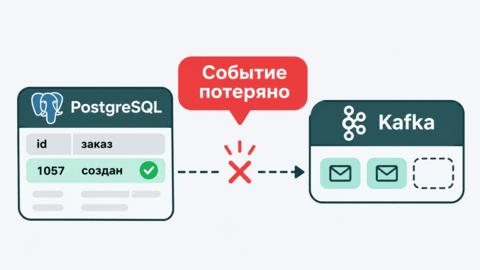
Потом склад присылает список заказов, о которых он не слышал. Их немного, по одному на несколько тысяч. И каждый приходится на деплой, перезапуск пода или короткую недоступность брокера. Ищут обычно в Kafka, смотрят лаг консьюмеров, ретеншн, настройки acks. Там всё в порядке, потому что сообщение до брокера просто не доехало.
У базы и брокера нет общей транзакции. Между коммитом и отправкой есть щель, и любой сбой в этой щели оставляет систему в состоянии, которое потом никто сам не исправит.
Закрывают её обычно outbox‑таблицей, но и у outbox есть пара мест, где он теряет события или путает их порядок. Обе проблемы воспроизводятся на обычном PostgreSQL за пару минут.
Четыре способа разойтись
Начнём с кода, который встречается в каждом втором сервисе:
@Transactionalpublic Order create(CreateOrder cmd) { Order order = orderRepository.save(Order.from(cmd)); kafkaTemplate.send("orders", order.getId().toString(), new OrderCreated(order.getId(), order.getTotal())); return order;}Отправка стоит внутри транзакции, а коммит произойдёт после выхода из метода. Сообщение уходит в Kafka раньше, чем заказ становится виден в базе.
Если коммит потом упадёт на ограничении целостности или на дедлоке, подписчики получат событие о заказе, которого нет. Склад начнёт резервировать товар под пустое место.
Перенесём отправку после коммита — и получим обратную картину. Процесс может умереть между коммитом и send от OOM, от SIGKILL после истёкшего terminationGracePeriodSeconds или вместе с упавшей нодой. Ретрай тут не поможет, потому что ретраить некому: процесса уже нет. Заказ сохранён, а события нет.
Третий вариант заметно тише первых двух. Метод send в Spring Kafka асинхронный и возвращает future. Если его результат никто не проверяет, ошибка брокера после ответа клиенту уйдёт в лог и там останется.
Четвёртый вариант возникает при таймауте отправки. Брокер мог записать сообщение и не успеть ответить. Продюсер повторит отправку, и событий станет два. С Kafka 3.0 у продюсера по умолчанию включён enable.idempotence=true, он убирает дубли от собственных ретраев продюсера. Дубль от ретрая на уровне приложения он не уберёт.
Все четыре случая редкие, поэтому в тестах их не видно. Проявляются они только на реальном объёме заказов. При 50 000 заказов в день и паре деплоев в неделю потерянные события набегают десятками в месяц.
Почему не помогает AFTER_COMMIT
Первое, что предлагают в обсуждениях, это @TransactionalEventListener. Публикуем событие приложения внутри транзакции, а слушатель отправляет его в Kafka после коммита:
@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)public void on(OrderCreated event) { kafkaTemplate.send("orders", event.orderId().toString(), event);}Фантомных событий так больше не будет, потому что при откате слушатель не вызовется. Потерянные события останутся.
Между коммитом и вызовом слушателя событие живёт только в памяти процесса. Умер процесс — умерло и событие. Мы просто передвинули щель на несколько строк ниже.
Транзакции Kafka тоже не помогают, хотя по названию кажется, что должны. Они делают атомарной запись в несколько топиков и коммит офсетов консьюмера. Ваша PostgreSQL в эту транзакцию не входит. Распределённые транзакции через XA между базой и Kafka не поддерживаются.
Outbox: событие пишется той же транзакцией
Чтобы событие и заказ сохранились атомарно, событие кладут в ту же базу и в ту же транзакцию. Это и есть transactional outbox. Отправкой в брокер занимается отдельный процесс. Такой процесс обычно называют relay. Он читает таблицу и публикует то, что ещё не отправлено.
create table outbox ( id bigserial primary key, aggregate_id bigint not null, event_type text not null, payload jsonb not null, created_at timestamptz not null default now(), sent_at timestamptz);create index outbox_unsent on outbox (id) where sent_at is null;Частичный индекс держит в себе только неотправленные строки, поэтому запрос relay остаётся быстрым даже тогда, когда таблица разрослась до миллионов отправленных событий, а отправленные строки никто не удалял, потому что про очистку забыли так же, как обычно забывают про ротацию логов. Чистить их лучше пачками по расписанию.
В коде сервиса Kafka больше нет:
@Transactionalpublic Order create(CreateOrder cmd) { Order order = orderRepository.save(Order.from(cmd)); outbox.save(OutboxEvent.of(order.getId(), "OrderCreated", toJson(order))); return order;}Если коммит упал, нет ни заказа, ни события. Если процесс умер после коммита, событие лежит в таблице и relay заберёт его после рестарта.
Платим за это задержкой. Событие уходит при следующем проходе relay, и при частом опросе это доли секунды.
Если у вас Spring Modulith, писать всё это руками уже не нужно. Его реестр публикаций событий сохраняет событие в таблицу event_publication той же транзакцией и досылает незавершённые публикации. С версии 2.1 есть отдельный режим spring.modulith.events.externalization.mode=outbox для отправки во внешний брокер.
Курсор по id теряет события
Самая очевидная реализация relay запоминает последний отправленный id и читает дальше: where id > :last_id order by id. id монотонно растут, значит, ничего не проскочит.
Растут они в момент вставки, а видимыми строки становятся в момент коммита, и порядок этих событий разный. Я поднял PostgreSQL 16 и воспроизвёл это в трёх сессиях.
Первая транзакция вставляет строку, получает id 1 и три секунды не коммитит. Вторая вставляет строку с id 2 и сразу коммитит. Relay в этот момент видит только вторую строку:
relay, проход 1: where id > 0 -> 2 last_id = 2первая транзакция коммитит строку с id 1relay, проход 2: where id > 2 -> (пусто)в таблице: 1, 2Строка с id 1 лежит в таблице и не будет отправлена никогда.
Под нагрузкой это случается каждый раз, когда одна транзакция с вставкой в outbox идёт дольше соседней: медленный внешний вызов внутри транзакции, блокировка, пауза GC. Значения bigserial выдаются вне транзакции, и откаты оставляют в нумерации дыры, поэтому по разрывам в id такую строку тоже не найти.
Надёжнее всего читать по признаку, а не по позиции. Relay выбирает строки, где sent_at is null, отправляет и проставляет время. Частичный индекс из предыдущего раздела нужен ради этого запроса.
Два relay путают порядок
Одного relay со временем становится мало, и запускают второй. Чтобы они не отправили одно и то же дважды, берут for update skip locked:
with e as ( select id from outbox where sent_at is null order by id limit 1 for update skip locked)update outbox o set sent_at = clock_timestamp()from e where o.id = e.idreturning o.id, o.event_type;Дублей действительно нет. Зато в моём прогоне получилось вот что.
В таблице два события одного заказа: OrderCreated и OrderPaid. Первый relay взял OrderCreated и задумался на две секунды, как задумывается на медленном ответе брокера.
Второй пропустил заблокированную строку, взял следующую и отправил её сразу:
OrderPaid 21:25:42.209OrderCreated 21:25:43.722Склад получил оплату заказа, которого для него ещё не существует. Kafka держит порядок внутри партиции, если ключом стоит id заказа, но выше брокера порядок уже потерян.
Исправляется это условием в выборке. Событие берём только тогда, когда у того же агрегата нет более раннего неотправленного.
select o.id, o.event_type, o.aggregate_idfrom outbox owhere o.sent_at is null and not exists ( select 1 from outbox p where p.aggregate_id = o.aggregate_id and p.sent_at is null and p.id < o.id)order by o.id limit 100for update skip locked;С таким запросом второй relay в моём прогоне не увидел ничего. Голова очереди заказа 7 была заблокирована первым, а OrderPaid отсеялся условием. Разные заказы по‑прежнему разъезжаются по разным relay. Есть и другой путь: шардировать relay по aggregate_id % N, и тогда каждый агрегат обрабатывает всегда один и тот же relay.
Когда таблицу читает Debezium
Вместо polling можно читать outbox через логическую репликацию, например Debezium с преобразованием Outbox Event Router. События приходят быстрее, база не опрашивается. Взамен в базе заводится слот репликации, и у него своя цена.
Пока коннектор жив, слот продвигается. Если коннектор остановили и забыли, PostgreSQL продолжает держать весь WAL, который слот ещё не подтвердил.
По умолчанию max_slot_wal_keep_size = -1, ограничения нет, и диск под pg_wal заканчивается через несколько дней на любой нагруженной базе.
Отследить это можно запросом:
select slot_name, active, pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) as retainedfrom pg_replication_slots;Ограничить можно двумя параметрами:
-
max_slot_wal_keep_sizeпо размеру (он появился в PostgreSQL 13); -
idle_replication_slot_timeoutпо времени простоя (он появился в PostgreSQL 18).
Слот, который упёрся в лимит, инвалидируется, и коннектор придётся пересоздать со снапшотом. Это неприятно, но лучше, чем остановившаяся база.
Доставка хотя бы один раз
Outbox гарантирует, что событие не потеряется. Он не гарантирует, что событие придёт один раз. Relay может отправить сообщение, упасть до того, как проставит sent_at, и после рестарта отправить его снова. Поэтому вторая половина решения живёт у потребителя: он запоминает обработанные id событий в той же транзакции, в которой меняет свои данные.
insert into inbox (event_id, processed_at) values (:event_id, now())on conflict (event_id) do nothing;Если вставка не добавила строку, событие уже обработано и его можно пропустить.
Без этой таблицы outbox просто превращает потерянные события в повторные. Для склада повторный резерв товара обычно хуже потерянного.
Каждая часть этой схемы по отдельности простая: таблица, запрос, уникальный ключ. Сложно в ней только одно: признать, что две строчки save и send — это распределённая транзакция, хотя выглядят как обычный код.
Дальше всё вытекает само, включая курсор, который нельзя хранить по id, и порядок, который ломается на втором relay.
А у вас события между базой и брокером ходят через outbox, через CDC или через две строчки подряд, и сколько потерянных вы находили при сверке?
Когда событие теряется между базой и брокером, последствия могут обнаружиться далеко не сразу — например, когда склад не находит заказ или получает события в неправильном порядке.
Чтобы лучше понимать механизмы доставки сообщений, находить слабые места интеграций и проектировать надёжные микросервисные системы, посетите бесплатные открытые уроки:
-
9 декабря, 20:00. «Apache Kafka в Observability: как построить надёжный конвейер данных». Записаться
-
14 декабря, 20:00. «Основы проектирования бизнес-логики в микросервисной архитектуре». Записаться
Источник: habr.com