
Всем привет, меня зовут Сергей Прощаев и в этой статье расскажу про встроенный JSON API, который появился в JDK 28 инкубаторным модулем.
Я Tech Lead и руководитель направления Java | Kotlin‑разработки в FinTech & E‑commerce, преподаю на курсах разработки и архитектуры в ОТУС.
Первый же бенчмарк показал ничью: встроенный парсер JDK 28 и Jackson разбирают документ на 12 МБ за примерно одно и то же время — 16 и 14 миллисекунд, разница укладывается в погрешность.
Стоило добавить в бенчмарк чтение значений, и на том же файле и той же машине встроенный парсер оказался в 1,65 раза медленнее и выделял примерно втрое больше памяти на операцию.
Обе цифры честные. Разница только в том, прочитали вы потом значения из дерева или нет.
Эта статья про то, почему так получается и что из этого следует для вашего кода.
Спойлер: Jackson никуда не денется, но в части задач тащить его в проект больше незачем.
Двенадцать лет без стандартного JSON API
Попытка встроить JSON в Java уже была. JEP 198 «Light‑Weight JSON API» завели в 2014 году, и он так и остался в статусе «Closed / Withdrawn» с пометкой: заменён JEP 540.
JEP 540 «Simple JSON API (Incubator)» вошёл в JDK 28 инкубаторным модулем jdk.incubator.json.
Авторы честно сузили задачу: API маленький, строго по RFC 8259, без привязки к объектам, потокового разбора и расширений синтаксиса. В разделе «Не цели» прямо сказано, что вытеснять существующие JSON‑библиотеки задачи нет.
Мне стало интересно не «кто быстрее», а другое: где этой урезанной версии хватит в реальной работе, а где без Jackson по‑прежнему не обойтись.
Что я проверил
Чтобы не спорить на ощущениях, я собрал репозиторий jdk-json-vs-jackson. В нём шесть будничных задач, каждая решена трижды: встроенным API, деревом Jackson 3.3.0 и привязкой Jackson к записям (records).
Документы синтетические: структура прогноза взята из примера в JEP, дамп потоков моделирует формат JSON‑дампа jcmd, размеры 4,5 КБ, 123 КБ и 12 МБ. Генератор использует фиксированный seed.
Два небольших документа лежат в репозитории, и CI сверяет их с генератором байт в байт, а дамп на 12 МБ создаётся при каждом прогоне, так что все три реализации получают одни и те же байты. Стеки потоков в дампе случайные и не согласованы с состоянием потока: файл служит для сравнения парсеров, а не диагностики.
Дополнительно я провёл четыре вида измерений:
-
поведение на 22 граничных случаях;
-
JMH для разбора документа и для двух сквозных задач (средняя температура и группировка потоков по состояниям);
-
занятая деревом память после сборки мусора;
-
холодный запуск программы.
Машина — Apple M2 Pro, ранняя сборка JDK 28-ea+23, JMH 1.37 с одним форком. Строка документа готовится до замера, чтение файла и декодирование UTF-8 в JMH не входят. Все три реализации на шести задачах дают одинаковые ответы, это первое, что проверяет run.sh.
Наблюдение 1. Для мелкой задачи код не длиннее, чем на Jackson
Задача из JEP: средняя температура по прогнозу. На встроенном API:
double avg = Json.parse(forecast).get("properties").get("periods").asList().stream() .mapToInt(p -> p.get("temperature").asInt()) .average().orElseThrow();На дереве Jackson почти то же самое:
// MAPPER = JsonMapper.builder().build(), настройки по умолчаниюdouble avg = MAPPER.readTree(forecast).get("properties").get("periods").valueStream() .mapToInt(p -> p.get("temperature").intValue()) .average().orElseThrow();Привязка к записям выглядит чище, но требует объявить по записи на каждый уровень вложенности. Для разового скрипта это лишняя работа.
Разница видна не в коде, а в холодном запуске JVM. Я замерил программу целиком на маленьком forecast.json: новая JVM читает файл в String, разбирает его, печатает одно число и завершается.
Важны накладные расходы запуска, а не обработка большого документа. Файловый кэш ОС прогрет одним проходом без замера. Затем выполнено 15 запусков, для которых рассчитана медиана.
Варианты чередуются, и только вариант JDK запускается с --add-modules jdk.incubator.json.
Вариант
Загружено классов
Время, мс
JDK
1153
70
Jackson, дерево
1834
170
Jackson, записи
2163
201
Плюс Jackson требует три jar‑файла на 2,6 МБ.
Для сервиса, который живёт неделями, эти 100 мс ничего не значат. Для CLI‑утилиты, скрипта в CI или лямбды с холодным стартом это уже заметная часть времени.
Наблюдение 2. Встроенный API строже при доступе к значениям
Здесь меня ждал главный сюрприз. Я подал обоим парсерам одни и те же входы без настроек.
Сразу оговорюсь: к расширениям синтаксиса оба одинаково строги, различия начинаются на дублях ключей и при переводе значения JSON в тип Java. В колонке Jackson — привычные мягкие методы asInt() и asString().
Вход
JDK 28
Jackson 3, дерево
{"a":1,"a":2}
ошибка разбора
2
1.5, прочитать как int
ошибка
1
"42", прочитать как int
ошибка
42
1e400, прочитать как double
ошибка
Infinity
нет поля, path("b").asInt() у Jackson
ошибка
0
null, прочитать как строку
ошибка
пустая строка
0.1000000000000000055511151231257827, вывести узел числа
исходная запись числа
0.1
Правая колонка — поведение Jackson при стандартной конфигурации и мягких методах as*().
Дубль ключа в платёжном запросе, дробная сумма, превращённая в целое, пропавшее поле, которое стало нулём.
Всё это ошибки, которые сначала живут в данных, а находятся через месяц в отчёте.
Две оговорки к таблице.
-
1e400— допустимая запись числа в JSON. JDK разбирает её без ошибок, а отказывает толькоasDouble(), которому нужно конечное значение. -
С дублями ключей RFC 8259 тоже мягче, чем кажется: имена «SHOULD be unique», а поведение при повторе названо непредсказуемым.
JDK выбрал самый строгий и предсказуемый вариант, Jackson по умолчанию берёт последнее значение.
Встроенный API на каждый такой случай бросает исключение с путём до места:
Path: "{threadDump{threadContainers[0{threads[0{tid"Я бы назвал это главным аргументом в его пользу, а не скорость и не размер.
Справедливости ради: в дереве Jackson 3 у мягких методов есть строгие пары.
intValue() для 1.5, "42" и MissingNode, который path() возвращает для отсутствующего поля, бросает исключение (get() в этом случае вернёт Java null). stringValue() для null возвращает Java null.
Но doubleValue() на 1e400 так же молча отдаёт Infinity.
Дубли ловит StreamReadFeature.STRICT_DUPLICATE_DETECTION, точность дробей в дереве сохраняет JsonNodeFeature.USE_BIG_DECIMAL_FOR_FLOATS. Оба варианта я проверил запуском, это отдельный раздел expected.txt.
Я сравниваю поведение по умолчанию. В JDK правила перевода значений фиксированы контрактом каждого метода и не переключаются настройками (asInt() требует точного значения, asDouble() — только конечного). В Jackson результат зависит и от метода, и от конфигурации.
Отсутствующее поле и null — не одно и то же
Отдельно про отсутствующее поле и null.
В JSON‑дампе JDK член waitingOn есть только у потоков, ждущих уведомления в Object.wait() (WAITING и TIMED_WAITING). У BLOCKED вместо него blockedOn, у запаркованных через LockSupport — parkBlocker, а parent у корневого контейнера равен null.
Я проверил это дампом jcmd с JDK 28, генератор воспроизводит распределение первых двух полей.
Встроенный API различает эти случаи двумя методами:
thread.tryGet("waitingOn").isPresent(); // поле есть или нетcontainer.get("parent").tryValue().isEmpty(); // поле есть, но равно nullУ дерева Jackson то же самое делают has() и isNull(). А вот привязка к записям в такой простой схеме различие теряет: в record JThread(String state, String waitingOn) и отсутствующее поле, и явный null дадут одно и то же null.
Сохранить разницу можно отдельной моделью присутствия поля или своим десериализатором, но это уже дополнительный код.
Для подсчёта ждущих потоков это неважно. Для PATCH‑запроса, где «не передали» и «передали null» означают разное, это уже ошибка в логике.
Наблюдение 3. Ничья в бенчмарке оказалась следствием ленивого дерева
Теперь к цифрам из начала. Первый вариант бенчмарка был «только разбор»: строка в памяти, вызов parse, вернули дерево.
Документ
JDK, мкс
Jackson, мкс
JDK, выделено
Jackson, выделено
4,5 КБ
8,7
8,6
37 КБ
13 КБ
123 КБ
152
144
561 КБ
238 КБ
12 МБ
16 065 ± 2 428
14 225 ± 904
55 МБ
23 МБ
Можно было бы на этом закончить и написать «встроенный парсер не уступает Jackson». Но смутила память: при равном времени JDK выделял в 2,3–2,9 раза больше памяти (точные значения в README репозитория).
Так не бывает, если обе стороны делают одну и ту же работу.
Ответ нашёлся во внутренних классах модуля. Вот как устроен узел дерева, который возвращает Json.parse.
Перед схемой важно одно: смотрите на стрелки к массиву символов — они идут от каждого узла.
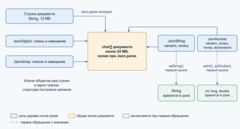 Ленивое дерево JDK: узлы хранят смещения в общей копии документа, значения вычисляются при первом обращении
Главная мысль схемы: после parse дерево уже построено, узлы объектов, массивов, строк и чисел созданы, а ключи объектов лежат строками в карте членов.
Но значения строк и чисел ещё не переведены в String, int или double.
Узлы хранят смещения в копии документа char[], по 2 байта на символ. Строка собирается при первом asString(), число — при первом asInt() или asDouble(), и дальше хранится в узле через LazyConstant.
Бенчмарк «только разбор» меряет JDK без половины работы, а Jackson — с полной.
Поэтому я добавил второй вариант: разбор и чтение всех значений дерева.
Обход в Walk.java читает каждую строку и переводит каждое число в double. Это способ заставить JDK вычислить всё, и реальная обработка обычно читает меньше.
Документ
JDK, мкс
Jackson, мкс
JDK, выделено
Jackson, выделено
4,5 КБ
28,8 ± 11,4
10,7
54 КБ
17 КБ
123 КБ
328 ± 148
184
956 КБ
310 КБ
12 МБ
29 061 ± 2 562
17 477 ± 845
94 МБ
31 МБ
Как только значения читаются целиком, JDK выделяет примерно втрое больше памяти на операцию. На 12 МБ он медленнее в 1,65 раза, и интервалы не пересекаются. На 123 КБ интервалы пересекаются, и разницу в скорости утверждать нельзя. Интервалы посчитаны по пяти итерациям одного форка JMH, межпроцессный разброс они не отражают. Ленивость выгодна, если из ответа нужны два поля, и невыгодна при полном обходе. Только это ленивость значений, а не разбора: структуру всего документа JDK строит сразу.
Если из файла на сотни мегабайт нужны три поля, потоковый API Jackson обойдётся без дерева вообще.
Наблюдение 4. Дерево держит в памяти больше, чем сам документ
Выделения — это мусор, который соберут. Важнее, сколько дерево удерживает, пока оно живо.
Я оценил это по разнице занятой кучи до и после построения дерева, каждый раз после принудительной сборки мусора, минимум из пяти попыток.
Документ на 12 МБ:
Сразу после разбора
После чтения всех значений
JDK
52 МБ
76 МБ
Jackson, дерево
23 МБ
24 МБ
У JDK к копии документа добавляются вычисленные строки и числа.
Это оценка для одного документа, одной JVM и одного сборщика (не точный размер графа объектов), но порядок ясен: втрое больше, чем у Jackson.
Если вы держите разобранные документы в кэше или обрабатываете пачку параллельно, разницу надо закладывать в размер кучи.
Наблюдение 5. В API нет настраиваемых пределов глубины и размера
Встроенный парсер разобрал вложенность в 2 000 и 100 000 уровней без единой жалобы: он держит открытые объекты и массивы в собственном стеке Deque, без рекурсии. Ограничивают его только ресурсы JVM.
Jackson 3 отказал на 501-м уровне:
Document nesting depth (501) exceeds the maximum allowed (500).Число из 2000 цифр JDK тоже разбирает и падает только при попытке прочитать его как double. Jackson отказывает сразу, по пределу длины числа.
У этих пределов есть история. Механизм StreamReadConstraints появился в Jackson 2.15 в 2023 году и потом расширялся. Автор библиотеки Тату Салоранта прямо называет цель: защита сервиса, чтобы один запрос не мог съесть ресурсы, нужные остальным. Неважно, по ошибке клиента или из‑за атаки.
В ветке 2.x глубина по умолчанию была 1000, в Jackson 3 её снизили до 500.
Ещё Jackson 3.3.0 по умолчанию ограничивает:
-
число — 1000 знаками;
-
строку — 100 млн;
-
имя поля — 50 000.
При этом общий размер документа и число токенов по умолчанию не ограничены.
Встроенный API таких ограничений не даёт, и это согласуется с его целями: он про простые задачи с доверенными данными.
Если JSON приходит из сети от чужого клиента, ответственность за ограничения остаётся на стороне приложения.
Размер тела ограничивается на шлюзе или в HTTP‑сервере, до чтения в String: parse принимает документ только целиком, а Jackson длину документа по умолчанию не ограничивает.
Глубину Jackson проверяет сам во время разбора, через StreamReadConstraints. Встроенному API для этого нужна отдельная предварительная проверка, по сути кусок своего JSON‑парсера с экранированием, ошибками и тестами на всё это.
Поэтому для недоверенного ввода я бы предпочёл Jackson с явно заданными пределами.
И ещё одна тонкость: построить глубокое дерево и обойти его — разные задачи. Мой Walk рекурсивный, на глубине 100 000 он упёрся бы в стек, поэтому глубину я проверял только на разборе.
Ограничения
Где мои выводы не универсальны:
-
jdk.incubator.json— инкубаторный модуль. API может поменяться до финальной версии, компиляция и запуск требуют--add-modules jdk.incubator.json, а JVM при старте печатает предупреждение. Ленивая реализация — деталь текущей сборки, её тоже могут переписать. -
В API нет привязки к объектам, потокового чтения и
parse(Reader): документ целиком загружается вStringилиchar[]. Для файла на гигабайт это сразу вопрос памяти. -
Генерация на простых документах совпала байт в байт, включая экранирование, для отступов есть
Json.toDisplayString(value, " "). Сериализации своих объектов нет: дерево изJsonObject.of(...)собирается руками.» -
Замеры — одна машина, ранняя сборка и один форк JMH, поэтому эталон в репозитории сверяет только поведение.
Так где хватит встроенного парсера
Свёл всё в одну схему выбора. Начинать с вопроса о том, откуда приходит JSON: он важнее скорости.
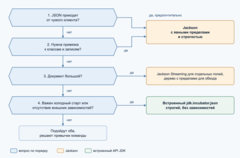 Где хватит встроенного парсера, а где нужен Jackson
Главная мысль схемы: встроенный JSON — не замена Jackson в сервисе, а замена Jackson там, где Jackson был лишним. Скрипты, CLI, разбор конфигов и отчётов, тесты, утилиты вокруг JDK — вроде чтения дампа потоков jcmd, который, кстати, сам выдаётся в JSON. Там строгость и отсутствие внешней зависимости могут перевесить память, скорость полного обхода и привязку к версии JDK.
Что сделать у себя
Если вы уже на ранних сборках или собираетесь попробовать JDK 28, я бы начал с трёх шагов:
-
Найти в проекте утилиты и тесты, где Jackson подключён ради разбора пары полей. Это первые кандидаты на встроенный API.
-
Прогнать свои реальные документы через таблицу граничных случаев. Если встроенный парсер на них падает, значит Jackson всё это время молча что‑то решал за вас. Об этом стоит узнать в любом случае.
-
Для входящего трафика в сервисе проверить, что пределы Jackson не отключены и не завышены. Встроенный парсер их не даёт, и переносить на него внешний ввод без ограничений нельзя.
Мой итог такой. Встроенный JSON API не стал полноценной заменой Jackson. Главное различие оказалось не в скорости разбора, а в устройстве результата: JDK откладывает строки и числа и держит копию документа, Jackson строит готовое дерево сразу. Поэтому выбор зависит от того, что приложение делает с деревом.
А строгость во встроенном API ценнее скорости. Как только задача выходит за рамки «прочитал несколько полей из доверенного файла», возвращаемся к Jackson.
Ссылка на мой репозиторий с экспериментом
Начать стоит с expected.txt: там ответы трёх реализаций и вся таблица граничных случаев, на которую опирается статья.
Сами решения лежат рядом:
-
JdkTasks.java; -
JacksonTreeTasks.java; -
JacksonBindingTasks.java.
Ленивость дерева видна в Retained.java и бенчмарке ParseBench.java, а весь прогон запускается командой ./run.sh.
Источники:
-
Репозиторий эксперимента jdk‑json‑vs‑jackson, цифры статьи сняты на коммите 0b8b082
-
JEP 540: Simple JSON API (Incubator)
-
Javadoc модуля jdk.incubator.json, JDK 28 Early Access
-
JEP 198: Light‑Weight JSON API
-
OpenJDK JDK 28 Early‑Access Builds
-
Jackson 2.15 Release Overview, Tatu Saloranta
-
StreamReadConstraints в Jackson 3.3.0
-
RFC 8259, раздел 4 «Objects»
Когда Java‑сервис начинает тормозить или потреблять больше памяти, чем ожидалось, важно понимать, на каком этапе возникают основные затраты. Разобраться в поведении приложений под нагрузкой и научиться работать с большими объёмами данных — значит увереннее находить узкие места, выбирать подходящие инструменты и проектировать производительные системы.
Подробнее изучить эти задачи можно на бесплатных вебинарах Otus:
-
30 ноября, 20:00. «Почему Java‑сервис тормозит: пулы и виртуальные потоки на нагрузочном тесте». Записаться
-
17 декабря, 20:00. «Миллиард чисел и мало памяти: как отсортировать то, что не помещается в RAM». Записаться
Источник: habr.com