
UPD от 11:35:
UPD (бета-тест локальный OCR под 152-ФЗ): По следам обсуждения в комментариях полностью убрал передачу фотографий во внешние Vision-модели и перевёл распознавание изображений и сканов на российский сервер.
Сначала быстро поднял RapidOCR на ONNX, но первый же боевой тест на русском полисе страхования показал, что его дефолтная модель плохо справляется с кириллицей (начинает подменять русские буквы латиницей и цифрами). В итоге перевёл контур на лёгкий Tesseract OCR (tesseract-ocr-rus) с предобработкой в OpenCV (масштабирование мелких шрифтов + шумоподавление bilateralFilter + выравнивание контраста CLAHE) и рендером пустых PDF-сканов через PyMuPDF, а заодно усилил регулярки анонимайзера под адреса и даты рождения.
Для лёгкого VPS без GPU сравнение двух подходов на боевом документе выглядело так:
Параметр
RapidOCR (onnxruntime)
Tesseract OCR (tesseract-ocr-rus) + OpenCV
Потребление RAM в работе
~350–500 МБ на процесс
~50–100 МБ на процесс
Вес зависимостей в Docker
~250+ МБ (onnxruntime + модели)
~35 МБ (бинарник + словарь rus)
Скорость на 1 странице (CPU)
2–5 секунд
0.5–1.5 секунды
Качество русской кириллицы
Плохое из коробки (без дообучения)
Отличное на печатных документах и сканах
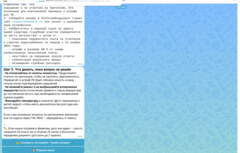
Теперь весь пайплайн единый и строго локальный: фото и сканы распознаются в памяти сервера в РФ, персональные данные заменяются на теги ([ФИО_1], [ПАСПОРТ_1], [АДРЕС_1]), и во внешний шлюз уходит только обезличенный текст.
Поскольку я прямо сейчас продолжаю выкатывать улучшения по вашим отзывам, во время рестарта контейнеров (пару секунд) сообщение может не уйти с первого раза — если вдруг такое случится, просто продублируйте запрос. Буду рад обратной связи!
Изначально я планировал написать лонгрид про своё участие в международном чемпионате по оптимизации ROADEF 2026. Там я вроде занял «почётное» 48-е место из 78 валидных участников, но потом дослал улучшенный код, и сейчас во Франции снова идёт пересчёт моего рейтинга.
Пока мы с вами ждали, что там да как с нашим кодом, позвонил знакомый отец Александр и попросил проконсультировать женщину по сложному пенсионному вопросу. Люблю я, знаете ли, не только NP-трудные алгоритмы решать, а ещё и бабушек консультировать в перерывах. И прямо в процессе этого разговора меня осенила мысль: а не совместить ли юридический бэкграунд и айтишный опыт в одном продукте?
(Барабанная дробь) — встречайте: первый, неповторимый и улётный во всех отношениях MAX-овский «Быстрый Юрист 24/7».
Зачем вообще делать ИИ-юриста в MAX
Когда обычному человеку нужно составить досудебную претензию управляющей компании из-за холодных батарей, вернуть бракованный смартфон, оспорить отказ Социального фонда по пенсии или оформить заявление на развод и алименты, у него два пути. Первый — идти в юридическую контору и отдавать от 5 000 до 15 000 рублей за типовой бланк. Второй — часами гуглить шаблоны пятилетней давности и получить отказ из-за устаревшей ссылки на закон.
При этом на фоне массового перехода аудитории (особенно граждан 45+, пенсионеров и жителей регионов) в российский мессенджер MAX выяснилось, что ниша полноценных прикладных ИИ-сервисов там практически свободна. Большинство существующих ботов — это либо пустые оболочки, либо «пылесосы» контактов для колл-центров.
Я решил за несколько вечеров собрать автономного правового помощника, который сам проводит интервью, читает фотографии справок и PDF-выписки, защищает персональные данные по 152-ФЗ и после оплаты по СБП выдаёт полноценный пакет «под ключ». Рассказываю, как устроена архитектура под капотом, на какие грабли я наступил и во сколько обходится содержание такого бота.
Почему не «просто обёртка над ChatGPT»
Любой, кто пробовал попросить языковую модель написать заявление в суд «в лоб», знает три главные проблемы:
-
Утечка персональных данных: люди без раздумий кидают в чат фото паспортов, СНИЛС, ИНН и адреса прописки, что напрямую нарушает 152-ФЗ.
-
Галлюцинации на стыке отраслей права: если дать нейросети слишком широкую свободу, она начинает смешивать нормы разных кодексов или ссылаться на утратившие силу постановления.
-
Халявный расход токенов: пользователи любят бесконечно расспрашивать бота «за жизнь», сжигая баланс API без намерения что-то купить.
Чтобы решить эти задачи, пришлось спроектировать жёсткий инженерный конвейер.
1. Архитектура: 10 закрытых веток вместо «универсального советника»
Весь бэкенд написан на Python 3.12 (FastAPI + Uvicorn) и крутится в Docker на российском VPS в Москве рядом с PostgreSQL 16. Чтобы бот работал без VPN и стабильно принимал оплату в рублях, используется официальный российский шлюз ProxyAPI и мультимодальная модель nvidia/nemotron-3.5-super-vl.
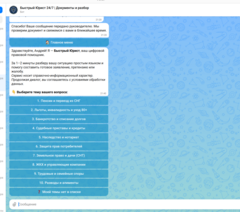
Вместо одного гигантского системного промпта диалог разбит на 10 закрытых тематических веток:
-
Пенсии и переезд из СНГ / Беларуси;
-
Льготы, инвалидность и уход (80+);
-
Банкротство и списание долгов;
-
Судебные приставы (ФССП) и кредиты;
-
Наследство и нотариат;
-
Защита прав потребителей;
-
Земельное право и дачи (СНТ);
-
ЖКХ и управляющие компании;
-
Трудовые споры;
-
Разводы и алименты.
Под каждую ветку подключается свой компактный экспертный модуль с актуальными нормами законодательства РФ и судебной практикой. Если пользователь выбрал раздел «ЖКХ», а потом вдруг начал спрашивать про раздел имущества при разводе, бот вежливо фиксирует смену темы и предлагает вернуться в меню, не позволяя модели «плыть» по контексту.
2. Двусторонний анонимайзер под 152-ФЗ
Самый важный узел с точки зрения безопасности — локальная защита персональных данных. Ни одно ФИО, паспорт, номер СНИЛС, ИНН, телефон или банковский счёт не уходит в облачную нейросеть в открытом виде.
Схема работает в три шага:
-
До отправки запроса в LLM локальный парсер находит персональные данные (как в тексте сообщения, так и внутри извлечённого текста из прикреплённых
.pdfи.docx) и заменяет их на обезличенные теги:[ФИО_1],[ПАСПОРТ_1],[АДРЕС_1],[ТЕЛЕФОН_1]. -
Нейросеть анализирует обезличенную фабулу дела и составляет юридический документ, расставляя эти теги в нужных падежах и строках шапки заявления.
-
На российском сервере перед отправкой ответа пользователю происходит обратная подстановка реальных реквизитов из временного словаря сессии.
А чтобы не хранить чувствительные данные дольше необходимого, фоновый воркер каждый час зачищает в PostgreSQL словари расшифровки старше 24 часов.
3. Локальный OCR и парсинг документов в памяти
Пожилым людям и их родственникам тяжело вручную перепечатывать отказы из МФЦ, постановления приставов или страховые полисы. Чтобы исключить передачу изображений во внешние Vision-модели и соблюсти 152-ФЗ, весь разбор вложений выполняется локально на сервере в РФ:
-
Электронные документы (
.pdf,.docx,.txtдо 10 МБ) распаковываются в оперативной памяти, очищаются от ПДн через двусторонний анонимайзер и передаются в контекст диалога. -
Фотографии и скриншоты бумажных справок распознаются локально за 0.5–1.5 секунды связкой Tesseract OCR (
tesseract-ocr-rus) + OpenCV (масштабирование мелких шрифтов, шумоподавлениеbilateralFilterи выравнивание контрастаCLAHE). Распознанный текст сразу проходит через фильтр ПДн, а исходная картинка не покидает сервер. -
Отсканированные PDF без текстового слоя автоматически рендерятся построчно через PyMuPDF (
fitz) и прогоняются через тот же локальный OCR-конвейер — пользователю не приходится переснимать документ на камеру.
4. Конечный автомат диалога и интеграция платёжного шлюза
Чтобы разделить этап сбора фактов и генерацию объёмных документов, в сессии пользователя (PostgreSQL) реализована двухфазная машина состояний:
-
Фаза интервью (сбор контекста): бот задаёт по 1–2 уточняющих вопроса за раз, валидирует полноту фактов и формирует краткое резюме ситуации плюс экран подтверждения данных (
ПРОВЕРЬТЕ ВВОДНЫЕ ДАННЫЕ) для защиты от галлюцинаций и опечаток до генерации документа. -
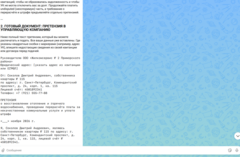
Фаза генерации результата (после подтверждения вебхука от ЮKassa / СБП): состояние сессии переключается, и система формирует структурированный ответ из трёх блоков (правовой анализ со ссылками на нормы РФ, шаблон документа с подставленными реквизитами из локального словаря и алгоритм дальнейших действий), а также открывает окно для двух автоматических правок в течение 24 часов.
Отдельное внимание уделено защите платёжного контура:
-
На уровне Nginx эндпоинт приёма уведомлений от ЮKassa ограничен белым списком официальных IP-адресов платёжного шлюза.
-
На уровне PostgreSQL обработка вебхука сделана идемпотентной через атомарный
UPDATE ... WHERE is_paid = FALSE, что исключает повторную генерацию при дублировании уведомлений от шлюза.
 5. Двухступенчатый цикл правок и фоновый планировщик задач
Для обработки опечаток пользователей в исходных данных (например, в дате договора или адресе) реализован двухступенчатый контур:
-
Контур 1 (автоматические правки): в течение 24 часов после оплаты пользователь может внести до 2 корректировок в диалоге. Система проверяет статус сессии, обновляет контекст и перегенерирует документ.
-
Контур 2 (эскалация по инцидентам): интерфейс включает опцию «⚠️ Сообщить об ошибке / Нужен возврат». Запрос с
payment_idЮKassa и логом сессии передается администратору в MAX для ручного разбора.
В фоне работает планировщик (asyncio-воркер): при прерывании сессии на этапе сверки данных отправляется однократное напоминание через 24 часа, а через 14 дней пользователю предлагается помощь со следующим шагом.
Затраты на инференс и грабли при интеграции
-
Расход токенов: за три дня тестирования 10 сценариев, парсинга файлов и циклов оплаты расход на API через ProxyAPI составил 6,6 рубля (себестоимость одного диалога — около 10–15 копеек за счет локального Tesseract OCR вместо дорогого Vision-инференса).
-
Грабли при подключении эквайринга ЮKassa: при переходе на боевые ключи возникла ошибка
401 Unauthorizedиз-за лишнего символа=в файле.envпри копировании ключа. Кроме того, в личном кабинете ЮKassa для работы вебхука требуется вручную раскрыть список событий и активировать чекбоксpayment.succeeded.
А пока во Франции дочитывают наш алгоритм для ROADEF 2026, посмотреть, как вся эта связка (FastAPI + Tesseract OCR + локальный анонимайзер под 152-ФЗ) работает вживую, можно в демо-боте в MAX: se15026938_bot.
Буду рад конструктивной критике архитектуры, кейсам по работе регулярных выражений с нестандартными документами и идеям по оптимизации OCR-конвейера в комментариях.
Источник: habr.com