
Во многих научных симуляциях — от молекулярной химии до материаловедения — львиная доля времени вычислений уходит на выполнение операций умножения плотных матриц (GEMM) с высокой точностью: DGEMM (для вещественных 64-бит чисел с плавающей запятой двойной точности) и ZGEMM (для комплексных 64-бит чисел с плавающей запятой двойной точности). В задачах HPC и ИИ для ускорения операций GEMM и других базовых подпрограмм линейной алгебры (BLAS) на ускорителях NVIDIA широко используется библиотека cuBLAS.
Активное развитие аппаратных средств, оптимизированных для вычислений с более низкой точностью, стимулировало разработку нового класса алгоритмов, которые позволяют получать результаты с полноценной двойной точностью, используя при этом более быстрые тензорные ядра (Tensor Cores), изначально предназначенные для целочисленных вычислений.
NVIDIA отметила, что с выходом CUDA Toolkit 13.4.2 при использовании cuBLAS больше не нужно выбирать между точностью и скоростью. Библиотека разбивает каждое число двойной точности на целочисленные компоненты, выполняет их умножение на тензорных ядрах, а затем восстанавливает точный результат. Итоговые значения имеют полную точность (double precision), но при этом вычисления выполняются без использования аппаратных FP64-блоков.
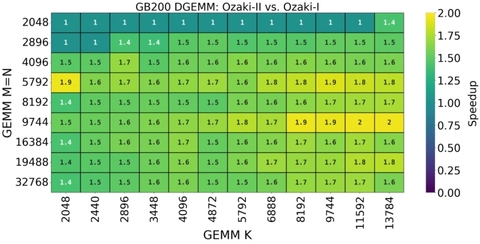
Росту эффективности процесса способствуют два новых алгоритма: схема Ozaki-II требует меньше целочисленных умножений, чем предыдущая версия Ozaki-I, а алгоритм 2M для эффективного умножения комплексных матриц сокращает количество операций по сравнению с классическим подходом с четырёх до двух. Решение основано на концепции автоматической динамической точности (Automatic Dynamic Precision, ADP). Схемы Озаки-I и Озаки-II имеют общий первый этап, но различаются способом выполнения умножения больших целых чисел. cuBLAS использует эвристический подход для автоматического выбора между алгоритмами для достижения максимальной производительности, хотя доступен и ручной выбор типа расчётов.
Архитектура Rubin вводит новый числовой формат — TI16 (12-бит знаково целое с диапазоном значений от -2047 до +2047), который отлично подходит для ускорения вычислений по схеме Озаки. В библиотеке cuBLAS 13.4 формат TI16 используется для ускорения Ozaki-I и Ozaki-II с помощью инструкции `tcgen05.mma` на ускорителях Rubin. На рисунке ниже показан прирост скорости операции DGEMM в cuBLAS при использовании метода Ozaki-II по сравнению с нативным FP64 на системе VR200 NVL72.
Верхний предел прироста производительности зависит от соотношения пропускной способности целочисленных тензорных ядер ускорителя и производительности его аппаратных блоков для вычислений в формате FP64. Это соотношение существенно варьируется в зависимости от конкретной модели устройства. Компания продемонстрировала это на примере ускорителя RTX PRO 6000 Blackwell Server Edition. На рисунке ниже представлено ускорение DGEMM при использовании схемы Ozaki-II по сравнению с нативным выполнением FP64 на данной модели.
Применение Ozaki-II обеспечивает преимущество во всем диапазоне протестированных размеров матриц: даже для самых маленьких матриц скорость растёт в 10 раз, а для самых крупных — в 23 раза. NVIDIA осознанно предпочитает использовать эмуляцию для повышения производительности HPC на ИИ-ускорителях вместо создания специализированных блоков для аппаратных FP64-вычислений. В свою очередь, в AMD считают, что это FP64 остаётся золотым стандартом для научных вычислений и подход NVIDIA к этому вопросу оправдан не для всех сценариев.
Разработчики AMD уверены, что в настоящее время нет замены «сырой» производительности FP64 и планируют увеличить нативную FP64-производительность ускорителя Instinct MI430X. Предполагается, что для «Миссии Генезис» (Genesis Mission) будут использоваться оба подхода, но в основном она будет полагаться на эмуляцию. Впрочем, NVIDIA Rubin HPC так или иначе обещает значительно повысить скорость обработки HPC-задач, но до выхода этого ускорителя пока далеко.
Источник: servernews.ru