
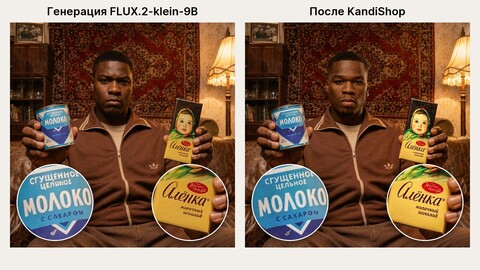
Современные генеративные модели уже умеют по одной фотографии поместить человека или товар в любую сцену. Но присмотритесь: лицо получилось «почти» тем, а мелкий текст на упаковке превратился в набор похожих на буквы закорючек.
На связи команды Контролируемого генеративного ИИ и Генерации видео AIRI. В этой статье мы расскажем, откуда берется эта проблема и как мы её решили с помощью нашего нового метода KandiShop — без единого шага обучения.
«Почти» не считается
За последние полтора года персонализированная генерация сильно изменилась. Раньше, чтобы модель «запомнила» конкретного человека, её дообучали на десятке его фотографий (DreamBooth, LoRA) или подключали отдельный энкодер лица (IP‑Adapter, InstantID, PhotoMaker). Теперь есть in‑context модели — FLUX.2, Qwen‑Image‑Edit, HunyuanImage 3 из open‑source, Nano Banana и GPT Image из коммерческих: даёте им фото и текстовый запрос и мгновенно получаете роскошную фотореалистичную ИИ‑фотосессию в самых разных стилях и локациях.
Но если показать результат своим друзьям, ответ часто будет: «Похоже, но это же не ты». Общие черты на месте — цвет волос, овал лица, улыбка, — а вот то, по чему мы на самом деле узнаём людей, поплыло: точная форма глаз и носа, лёгкая асимметрия и другие мелкие пропорции. Лицо получилось похожим, но не тем самым.
Ниже на фото слева — типичная ситуация: мы даём FLUX.2 klein 9B референс лица и просим сгенерировать его в новой сцене. Герой на себя не похож (знаю его лично!), да и метрика сходства ArcFace выдает скромные 0,59. Справа — результат работы KandiShop по тем же вводным: человек легко узнаваем, а метрика вырастает до 0,83.
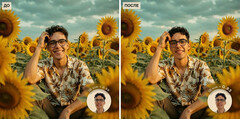 Рисунок 1. Слева — генерация FLUX.2 klein 9B по фотографии, справа — тот же кадр после KandiShop (референс в кружке). Сцена, поза и свет прежние, изменилось только лицо: теперь это тот самый человек. Сходство с референсом по ArcFace выросло с 0,59 до 0,83.
С товарами то же самое. Логотип и цвета упаковки модель воспроизводит, а мелкий текст может превратиться в правдоподобную текстуру из псевдобукв. Для людей, привыкших, что на экране телефона лёгким движением пальцев можно приблизить любую картинку и рассмотреть все мельчайшие детали, такое совершенно не подходит.
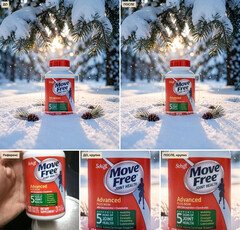 Рисунок 2. Сверху — генерация FLUX.2 klein 9B с баночкой Move Free в заснеженном лесу и тот же кадр после KandiShop; рамкой отмечена этикетка. Снизу — она же крупно рядом с референсом. Базовая генерация передаёт дизайн упаковки, но мелкие строчки — «with Glucosamine + Chondroitin», «Strength», «Flexibility» — рассыпаются в псевдобуквы. После KandiShop текст снова читается, а снег, ветки и свет не меняются.
Почему модель теряет детали
Чтобы понять корень проблемы, посмотрим, как устроены in‑context модели. Это диффузионные трансформеры, обученные в парадигме rectified flow: генерация стартует из шума и за несколько шагов превращается в картинку.
Проблема в том, что за один проход модель решает сразу две задачи, которые тянут в разные стороны:
-
творческую — поставить человека в новую позу, перерисовать свет под сцену, вписать его в композицию;
-
копировальную — перенести каждую черту лица и каждую букву с точностью до пикселя.
Когда приходится выбирать, модель жертвует второй. Глобальная композиция и смысл сцены выигрывают, а высокочастотные детали — то, что делает лицо узнаваемым, а текст читаемым, — размываются.
Неожиданное наблюдение: копировать модель вообще‑то умеет
Может быть, модели просто не хватает выразительности, чтобы удержать такие детали? Мы проверили это простым экспериментом. Дали модели референс и нейтральный запрос generate a precise copy of this image — «сделай точную копию». Никакой новой сцены, никакой новой позы — только воспроизведение. Генерация при этом идёт честно: из чистого шума, все шаги.
Результат оказался почти идеальным. Сходство лиц по ArcFace — 0,965–0,971, а текст на упаковках распознаётся с OCR F1 до 0,92. Но когда те же самые референсы нужно поместить в новую сцену, сходство лиц падает: в бенчмарке с несколькими людьми мы получали просадки до 0,24–0,60.
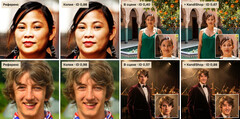 Рисунок 3. Один и тот же человек в двух режимах. С запросом «сделай точную копию» FLUX.2 klein 9B воспроизводит лицо почти идеально (ID 0,98). Но стоит поместить того же человека с тем же референсом в новую сцену — сходство падает до 0,40 и 0,57. Справа — та же сцена после KandiShop: 0,67 и 0,88.
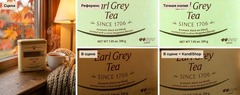 Рисунок 4. С текстом то же самое. Копия банки Twinings воспроизводит этикетку до последней строчки, а в уютной осенней сцене мелкий текст — «Aromatic black tea blend, scented with a citrus bergamot flavour» — превращается в кашу. KandiShop возвращает его на место.
Модель
Копирование лиц: ID ↑
Копирование товаров: OCR F1 ↑
Копирование товаров: CER ↓
FLUX.2 klein 9B
0,968
0,912
0,221
FLUX.2-dev
0,965
0,919
0,244
Qwen-Image-Edit-2511
0,971
0,840
0,360
HunyuanImage 3.0 Instruct-Distil
0,969
0,886
0,247
Таблица 1. Копирование без конфликта: модель просят точно воспроизвести референс. ID — сходство лиц по ArcFace; OCR F1 и CER (доля ошибок в символах) — точность текста на упаковке.
Вывод: нужная ёмкость у модели есть. Мешает не нехватка «памяти» о деталях, а конфликт задач. А раз так, задачи можно развести: пусть один процесс отвечает за сцену, другой — за точное копирование, и при этом оба работают над одной и той же картинкой.
Идея KandiShop: стиринг двумя потоками в одном трансформере
KandiShop работает уже после генерации: на входе сгенерированная готовая картинка и фото‑референс, на выходе — та же картинка с исправленным лицом или этикеткой.
Идея простая: на протяжении всего прямого прохода мы делаем стиринг (trajectory steering) траектории расшумления. Веса модели не трогаем и ничего не дообучаем — только подправляем путь, по которому модель идёт от шума к картинке. Если точнее, внутри маски лица или товара тянем признаки к тем, что получаются при точном копировании референса, а вокруг оставляем всё как было. Как это работает по шагам?
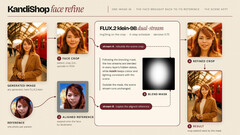 Рисунок 5. Схема KandiShop на примере одного лица. Модель — FLUX.2 klein 9B, 4 шага, сила перерисовки (denoise) 0,75.Шаг 1. Вырезаем объект крупно
Находим целевое лицо или товар и вырезаем вокруг него кроп. Зачем? В кадре 1024×1024 лицо может занимать всего 5–10 процентов токенов. Если пытаться влиять только на них, эффект быстро растворяется: глобальный self‑attention постоянно перемешивает информацию между всеми токенами, и маленькую правку «перекрикивает» фон. В кропе лицо получает весь бюджет токенов.
Шаг 2. Выравниваем референс
Очень важно точно сопоставить токены референса и токены сгенерированной картинки. Нос мы хотим тянуть именно к носу на референсе, а криво написанное слово «Aromatic» к корректному слову «Aromatic». Проще всего это сделать, заранее выровняв референс и положив его ровно туда, где объект находится в кропе. Для лиц мы находим пять ключевых точек (глаза, кончик носа, уголки рта) и подбираем преобразование подобия: сдвиг, поворот и масштаб.
Для товаров чуть сложнее. Grounding DINO находит объект, SAM вырезает его силуэт, а затем внутри силуэтов сопоставляются ключевые точки SIFT. По ним подбирается подобие или — если упаковка видна под углом — гомография. Маска при этом взвешивается по плотности совпавших точек: там, где совпадений нет (гладкие однотонные участки), решение остаётся за потоком сцены. Это спасает от «призраков» — полупрозрачных двойных контуров.
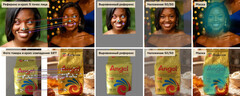 Рисунок 6. Выравнивание референса. Сверху — лицо: на референсе и в кропе находятся пять ключевых точек, по ним подбирается подобие, и выровненный референс ложится точно на лицо в кропе (наложение 50/50). Справа — маска: внутри неё работает поток идентичности. Снизу — товар: ключевые точки SIFT сопоставляются между фото товара и кропом, по ним подбирается гомография. Маска взвешена по плотности совпадений, поэтому на гладких участках без совпадений решение остаётся за потоком сцены.Шаг 3. Стиринг: два потока расшумления
Теперь главное. Кроп частично зашумляется — насколько сильно, задаёт параметр denoise, — и дальше расшумляется двухпоточной процедурой.
Каждый блок трансформера прогоняется дважды:
-
с входными данными сцены: копирующий промпт + зашумлённый кроп + исходный кроп как условие. Он держит позу, геометрию, фон и освещение;
-
с входными данными идентичности: также копирующий промпт + тот же зашумлённый кроп + выровненный референс как условие. Он «знает», как должно выглядеть лицо или этикетка.
После чего на выходе блока мы блендим два независимо вычисленных шумных латента по маске лица или товара. Но с некоторыми важными уточнениями:
-
Смешиваются только выходы блоков. Внутри блока потоки ничего друг о друге не знают.
-
Оба потока всегда стартуют с одного шумного латента. Каждый блок через attention читает своё условие и дописывает в этот общий холст своё: поток сцены — позу, свет и фон, поток идентичности — черты лица или буквы этикетки.
-
Условия никогда не смешиваются. Токены текста, кропа и референса проходят все 32 блока строго в своём потоке: референс напрямую никогда не попадает в поток сцены, а кроп — в поток идентичности. Смешивание касается только токенов картинки, которую модель расшумляет.
Один шаг расшумления выглядит так:
# x — зашумлённый латент кропа, общий для обоих потоков# m — маска объекта на сетке токенов: 1 внутри, 0 снаружи, мягкий крайh_scene = [text, x, crop] # поток сценыh_id = [text, x, ref] # поток идентичностиfor block in blocks: # 8 двухпоточных + 24 однопоточных h_scene = block(h_scene) # каждый поток проходит блок сам, h_id = block(h_id) # со своим условием x_s = h_scene.image # берём только токены зашумлённой картинки x_i = h_id.image x_i = adain(x_i, x_s, m) # шаг 4: свет и цвет — от сцены x_mix = m * x_i + (1 - m) * x_s h_scene.image = x_mix # общий результат — в оба потока; h_id.image = x_mix # текст, crop и ref не трогаемv = head(h_scene.image) # предсказание шага — из потока сценыx = scheduler.step(v, x)Почему важно смешивать именно внутри трансформера? Потому что после смешивания в следующих блоках токены лица через self‑attention «видят» окружающую сцену и подстраиваются под неё: под направление света, блики, цвет и границы.
Аналогия. Представьте двух художников, которые пишут одну картину по очереди, мазок за мазком. Один хорошо знает сцену, другой — лицо человека. Внутри контура лица кисть у второго, вокруг — у первого, но каждый видит, что нарисовал коллега, и подстраивается под него.
Шаг 4. AdaIN: черты — от референса, цвет — от сцены
У такого смешивания есть побочный эффект: поток идентичности тянет за собой не только черты лица, но и цвет референса. Если фото снято при тёплом домашнем свете, а сцена — холодный туман, лицо будет выглядеть приклеенным. Поэтому перед смешиванием мы применяем AdaIN: внутри маски выравниваем по каналам среднее и разброс признаков потока идентичности под поток сцены. Структура остаётся от референса, а «тон» — от сцены. AdaIN применяется в каждом блоке на каждом шаге расшумления.
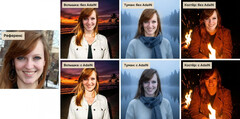 Рисунок 7. Один референс, снятый днём, и три сцены с очень разным светом: резкая вспышка камеры на закате, холодный туман и костёр. Без AdaIN лицо приезжает со своим дневным светом и выглядит наклеенным. С AdaIN черты лица те же, а свет и цвет — от сцены. ArcFace без AdaIN ожидаемо выше (со вспышкой 0,97 против 0,92): метрике нравится точная копия, вместе с чужим освещением.
Для товаров AdaIN мы отключаем: он немного смазывает мелкий текст, а небольшой сдвиг цвета упаковки глаз замечает гораздо меньше, чем неестественный оттенок кожи.
Шаг 5. Возвращаем кроп на место
Готовый кроп уменьшается обратно и вклеивается в исходный кадр по мягкой маске. Всё, что за пределами кропа, остаётся пиксель в пиксель исходным.
Ничего не обучается. KandiShop не требует дообучения, инверсии или дополнительных энкодеров! Всё, что нам нужно, это готовая in‑context модель и пара вспомогательных детекторов. Поэтому подход переносится между моделями: мы проверяли его на четырёх открытых бэкбонах — FLUX.2-dev, FLUX.2 klein 9B, Qwen‑Image‑Edit-2511 и HunyuanImage 3.0. В открытом коде — версия для FLUX.2 klein 9B.
Насколько сильно перерисовывать
Главная ручка — denoise: какую часть траектории расшумления мы проходим заново. Чем он больше, тем агрессивнее вставляется референс.
На практике для большинства картинок хорошо работают значения 0,5 или 0,75. Если лицо в исходнике уже близко к референсу, берите меньше — от исходного кадра сохранится больше (мимика, пряди волос); если далеко — больше. Для замены головы или товара целиком (о ней ниже) используем 1,0.
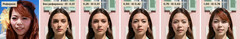 Рисунок 8. Как работает denoise. Базовая сцена сгенерирована вообще без референса: в ней просто случайная девушка, которую модель придумала по текстовому описанию (ID −0,01). KandiShop с референсом (слева) и растущим denoise: 0,25 почти ничего не меняет (0,01), а дальше черты, причёска и цвет волос референса проступают всё сильнее — 0,42 → 0,63 → 0,78. Поза, костюм и фон при этом не меняются.
Что получается
Лица
KandiShop обрабатывает каждое лицо отдельно, со своим референсом и своим кропом, поэтому ёмкость больше не делится между людьми и лица не перетекают друг в друга.
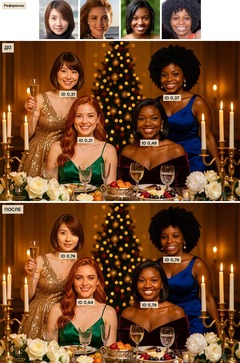 Рисунок 9. FLUX.2 klein 9B получил все четыре референса сразу (сверху) и честно постарался, но похожими лица получились лишь отчасти: ID 0,21–0,49. KandiShop прошёлся по каждому лицу отдельно — 0,64–0,79, а платья, свечи, бокалы и ёлка остались на месте.
Для количественной оценки мы собрали бенчмарк из 100 лиц FFHQ. Измеряли сходство ArcFace и HPSv3 — модель человеческих предпочтений, которая оценивает общее качество и эстетику картинки. Вот, что у нас получилось:
Модель
ID ↑: без → с KandiShop
HPSv3 ↑: без → с KandiShop
FLUX.2 klein 9B
0,519 → 0,748
11,36 → 11,37
FLUX.2-dev
0,504 → 0,752
10,42 → 10,35
Qwen-Image-Edit-2511
0,239 → 0,655
10,48 → 10,32
HunyuanImage 3.0 Instruct-Distil
0,492 → 0,842
11,41 → 11,08
Nano Banana Pro
0,571
11,09
GPT Image 2 High
0,861
10,59
Таблица 2. Сохранение личности на 100 лицах FFHQ в сценах с несколькими людьми. Для коммерческих моделей — их собственный результат без KandiShop.
Для FLUX.2 klein 9B сходство лиц выросло с 0,519 до 0,748: это выше, чем у Nano Banana Pro (0,571), и уже близко к GPT Image 2 High (0,861). HPSv3 при этом не изменился — картинка не стала хуже. На всех четырёх открытых моделях эффект устойчивый: прирост от +0,2 до +0,4.
Честная оговорка: FFHQ — открытый датасет, и эти лица могли попасть в обучение моделей. На новых людях цифры могут отличаться, поэтому примеры на странице проекта сделаны на реальных людях не из датасетов.
Товары и текст
Второй бенчмарк — 32 товара из Products-10K с плотным текстом на упаковке, по 10 сцен на каждый, всего 320 сцен. Метрики: OCR F1 и CER по распознанному тексту, LPIPS внутри маски товара (насколько упаковка близка к оригиналу) и тот же HPSv3.
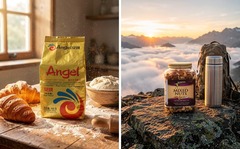 Рисунок 10. Два товара из бенчмарка после KandiShop: дрожжи Angel на столе пекарни и орехи Planters на горной вершине над облаками.
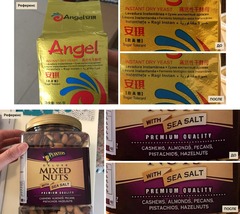 Рисунок 11. Те же этикетки крупно. До KandiShop мелкие строчки — многоязычная надпись на Angel и список орехов на Planters («CASHEIS… FECANS») — превращаются в похожие на буквы штрихи; после снова читаются, как на референсе.
Модель
OCR F1 ↑
CER ↓
LPIPS ↓
HPSv3 ↑
FLUX.2 klein 9B
0,762 → 0,841
0,654 → 0,506
0,152 → 0,139
12,04 → 12,05
FLUX.2-dev
0,725 → 0,821
0,653 → 0,518
0,166 → 0,137
11,55 → 11,55
Qwen-Image-Edit-2511
0,635 → 0,721
0,710 → 0,552
0,167 → 0,158
11,34 → 11,29
HunyuanImage 3.0 Instruct-Distil
0,744 → 0,870
0,566 → 0,296
0,142 → 0,094
12,31 → 12,22
Nano Banana Pro
0,777
0,710
0,142
12,26
GPT Image 2 High
0,819
0,579
0,118
11,79
Таблица 3. Точность текста и внешнего вида упаковки. Для открытых моделей — «без → с KandiShop».
Текст на картинках FLUX.2 klein 9B с KandiShop распознаётся лучше, чем у обеих коммерческих моделей: OCR F1 0,841 против 0,819 у GPT Image 2 High и 0,777 у Nano Banana Pro, а доля ошибок в символах падает с 0,654 до 0,506. HPSv3 снова не меняется: этикетка не выглядит наклеенной, текст ложится по форме объекта и под свет сцены.
Не только для своих генераций
KandiShop не нужен доступ к модели, которая сгенерировала картинку: он работает только с кропом. Значит, исправлять можно что угодно — выдачу коммерческого API, кадр из другой модели или реальную фотографию. Мы проверили это на Nano Banana Pro: взяли её генерации и прогнали через KandiShop на FLUX.2 klein 9B. По всем метрикам точности получили прирост, а HPSv3 почти не изменился.
Метрика
Nano Banana Pro
+ KandiShop
Разница
Лица: ID ↑
0,571
0,761
+0,190
Лица: HPSv3 ↑
11,09
11,09
0,00
Товары: OCR F1 ↑
0,777
0,825
+0,048
Товары: CER ↓
0,710
0,580
−0,130
Товары: HPSv3 ↑
12,26
12,18
−0,08
Таблица 4. KandiShop как постобработка чужой модели: картинки Nano Banana Pro, исправленные с помощью FLUX.2 klein 9B.
Бонус: замена головы и товара
Нигде в KandiShop не зашито, что на референсе и в кадре один и тот же человек или товар. Если подать фото другого человека и взять маску, включающую волосы, — получится замена головы (head swap); если другой товар — замена товара. Механика та же, меняются только маска и сила перерисовки.
Замена головы
В примере ниже маска строится сегментатором лица (BiSeNet face parsing) как объединение головы в кадре и головы с референса вместе с волосами. Перегенерация полная (denoise 1,0), AdaIN подстраивает свет.
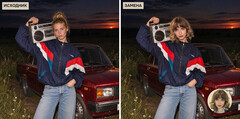 Рисунок 12. Замена головы. Куртка, поза, магнитофон, машина и закатный свет остались прежними; лицо и причёска — от референса (в кружке).
Мы сравнили этот подход с «нативной» заменой, когда модель просто просят заменить человека текстовой инструкцией. Нативная замена копирует донора чуть точнее, но оставляет коллажные швы и заметно теряет в качестве. В слепом попарном сравнении панель из семи VLM‑судей сочла результат KandiShop более естественным в 76% случаев.
Вариант
ID к донору ↑
ID к исходному ↓
HPSv3 ↑
Естественнее ↑
Исходный кадр Nano Banana Pro
0,014
0,636
11,40
—
Нативная замена
0,884
0,019
10,65
24%
KandiShop
0,742
0,011
11,21
76%
Таблица 5. Замена головы на кадрах Nano Banana Pro с одним человеком. «Естественнее» — доля побед в слепом попарном сравнении.
Замена товара
С товаром так: находим и сегментируем оба объекта, ставим новый на место старого с нужным масштабом и привязкой (по центру или по нижнему краю), объединяем силуэты, чтобы старый объект полностью исчез, и перерисовываем кроп с нуля. Модель вообще‑то и так умеет заменять объекты по инструкции, но при этом рискует при замене потерять половину букв, а KandiShop — нет.
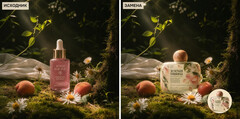 Рисунок 13. Замена товара: флакон сыворотки заменён баночкой крема с референса (в кружке). Мох, ромашки, персики и луч света остались на месте.Управление мимикой
Хорошо, лица править мы научились, но выражение всегда переезжает с референса. Не беспокойтесь, эмоции тоже можно добавить: два потока можно кормить разными текстами. Если потоку идентичности дать запрос generate a precise copy of this image but now the person is angry, меняется только выражение лица, а фон, поза и свет остаются от исходного кадра. На трёх сценах и пяти эмоциях сходство с человеком получается почти вдвое выше, чем если просто попросить модель сгенерировать сцену с новой эмоцией: 0,40 против 0,21. Ведь модель всё ещё сфокусирована на небольшом числе задач — скопировать лицо и добавить эмоцию, — фон, свет, поза и сцена её по‑прежнему не отвлекают.
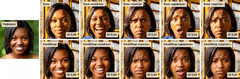 Рисунок 14. Верхний ряд — базовая модель, которой эмоцию просто дописали в запрос: мимика меняется, но сходство остаётся низким (ID 0,22–0,40). Нижний ряд — KandiShop с тем же исходным кадром и пятью запросами для потока идентичности. Без дополнительных слов лицо берёт выражение с референса — улыбку (0,94); со словами «смеётся», «злится», «удивлена», «грустит» меняется только мимика, а сходство остаётся выше: 0,41–0,69.
Ограничения
-
Цена двух потоков. Каждый шаг — почти два прохода трансформера. Для 40-шаговых моделей вроде FLUX.2-dev или Qwen‑Image‑Edit это заметно. Поэтому для практики мы выбрали дистиллированную 4-шаговую FLUX.2 klein 9B: на одном H100 исправление одного лица или товара занимает около 5 секунд вместе с детекцией и выравниванием.
-
Разные ракурсы — реальный челлендж для метода. Если референс в анфас, а сгенерированная картинка в профиль, метод может воспроизвести крайне ненатуральный поворот головы, особенно при высоком denoise и полной замене головы. В менее сложных случаях помогают меньший denoise или более крупные кроп и маска вставки. Сам перерисованный кроп обычно получается согласованным — self‑attention сводит все токены воедино, — а артефакты появляются при вставке обратно; широкая маска захватывает шею и плечи и сглаживает переход.
Чему мы научились, Палмер?
Научились без единого шага обучения:
-
повышать сходство лиц на FLUX.2 klein 9B с 0,52 до 0,75 — выше, чем у Nano Banana Pro;
-
делать мелкий текст на упаковках более читаемым, чем у GPT Image 2 High;
-
работать с любой картинкой — своей генерацией, выдачей Nano Banana или обычной фотографией;
-
а бонусом заменять головы, товары и управлять мимикой.
Двери открыты: код на GitHub и страница проекта с интерактивными «до/после» на реальных людях и товарах с русскими надписями.
А если вы такой же, как и я, detail‑oriented creative‑AI‑hyperfixated diffusion models enjoyer — подписывайтесь на мой телеграм‑канал @OnlyGensAI: там о наших проектах, красивом визуале и о генеративных моделях вообще.
Источник: habr.com