
Красивый отчёт — не значит верный. А верный — не значит полезный. Можно ли вообще построить систему исследований с ИИ, если модели становятся умнее и врут всё убедительнее? Пытаешься поймать их на ошибках — и постепенно обкладываешь систему правилами так, что профита от генеративности всё меньше.
 Статья из Insider от 8.10.2025
В статье — почему строгость и польза могут тянуть в разные стороны, как ловить новые обманки и как я собираю систему, которая помогает находить в куче данных инсайты для гипотез и роста продукта.
Ссылки выдуманы, а выводы те же. Так можно пересказать историю Deloitte: компания сдала правительству Австралии отчёт с несуществующими источниками, согласилась вернуть последний платёж, а министерство заявило, что рекомендации не изменились (тут). Хотелось бы иметь такую уверенность в своей работе.
И это не единичный случай. За последний год на отчётах с ИИ попадались Deloitte — в Канаде и Австралии, EY, KPMG: несуществующие источники, ошибки в ссылках, материалы, которые не подтверждают написанное.
Как так вышло, что ошибки ИИ уже стали частью рабочих документов, за которые платят деньги и на основе которых принимают решения?
Если бы дело было только в ненастоящих ссылках, проверять всё это было бы проще. Но есть ошибки тоньше: источник настоящий, цитата дословная, а вывод из неё — полный бред.
Можно поверить такому отчёту и потратить деньги на слабую идею. Можно перепроверить выводы руками — и потратить время, которое рассчитывал сэкономить. С парочкой выводов ещё разберёшься. Но когда их десятки, проверка сама становится отдельной работой, а выводить идеи на рынке всё так же дорого, и бюджет на ошибки никто не добавил (ИИ удешевил генерацию, не проверку).
Мне как тимлиду продуктового маркетинга с большой командой хотелось всё-таки получать от ИИ помощь с этой работой. Поэтому я начал строить «Полигон гипотез».
Коротко — приносишь идею и контекст, система агентов раскладывает её на проверяемые утверждения, ищет основания и противоречия, предлагает, что отбросить, а что доработать. На выходе — доработанные гипотезы и понятные шаги для живой проверки. При необходимости система собирает дополнительные материалы и проводит синтетические эксперименты.
Про раннюю версию и устройство системы я писал в первой части (тут). Сегодня — про то, что пришлось менять, когда я начал внимательнее проверять её работу.
О чём дальше:
-
Три барьера, на которые я налетел по очереди: ошибки моделей стали тоньше, проверки начали ошибаться сами
-
Когда я ужесточил правила, система стала осторожнее — и пользы от неё стало меньше.
-
Как система устроена сейчас и почему именно так.
Ну и что взять себе, если строим что-то такое)
Шесть ошибок, которые легко заметить. Пока видишь исходник
Давайте с интересного — я сгруппировал ошибки, с которыми сталкивался сам. Попробуйте назвать, что именно пошло не так в каждом из шести сценариев.
№
В отчёте
В исходных материалах
1
«Большинство клиентов недовольны интеграцией»
Недовольны двое из десяти. Остальные интеграцию не пробовали
2
«Спрос на мобильное приложение подтверждён: его упомянули четверо»
Четверо сказали «было бы неплохо». Шестеро не вспомнили. В брифе команды — «нам нужно мобильное приложение»
3
«Рынок растёт на 25% в год. Это подтверждают три агентства»
Все три пересказывают один пресс-релиз производителя
4
Подробный разбор, почему клиенты не покупают: цены, возражения, воронка
Вопрос был — почему клиенты не продлевают подписку
5
«Конкурентов с такой функцией нет»
Сделали два запроса на английском. Местная компания эту функцию продаёт
6
«Опыт крупного банка: отток снизился на 15%»
Банка, внедрения и числа не существует
Ну как? Вроде бы суперочевидно — пока перед глазами правая колонка. Но в обычном отчёте её нет, весь путь приходится восстанавливать: читать интервью, проверять происхождение публикаций, смотреть, что агент искал и куда не заглянул. И делать это на потоке.
На третьем отчёте за день «три агентства подтверждают» уже очень хочется принять за достаточное основание.
1. Потеря смысла при обобщении
Модель сокращает длинные интервью и объединяет похожие ответы. При сжатии теряются числа, полутона и оговорки, а вывод становится шире исходных данных: двое недовольных превращаются в «большинство».
В другом разборе интервью было похожее: «так говорят трое из десяти», но третий говорил о другом. А «не назвал конкурента» превратилось в «не знает конкурента».
Поэтому к обобщениям я стал требовать список: кто именно так сказал и где его слова. Скрипт пересчитывает участников, отдельный агент проверяет, действительно ли ответы позволяют объединить людей в одну группу.
2. Подстройка под заказчика
В брифе команда уже написала, что хочет приложение. Модель могла принять желаемое решение за исходную предпосылку и собрать подтверждения вокруг него — и вежливого «было бы неплохо» от четверых оказалось достаточно. Удобное исследование: можно ничего не менять в своих планах.
Как решение — включил утверждения из брифа в проверку и потребовал к каждому основному выводу сильнейший довод против. Проверяющий сверяет его с материалами, чтобы неудобные ответы не потерялись по дороге.
3. Зависимые источники
Если учитывать публикации, не прослеживая, откуда взялись данные, повторение выглядит как независимое подтверждение. Одна цифра прошлась по трём сайтам и вернулась с группой поддержки.
Пришлось завести реестр источников и стал считать подтверждения по нему. Тут начались первые косяки — о них дальше.
4. Ответ на соседний вопрос
В задачах «почему не покупают» и «почему не продлевают» есть цены, клиенты и возражения. Потеряв различие между первой покупкой и продлением, легко собрать содержательный отчёт вокруг знакомых тем и уехать от исходного вопроса.
Теперь бриф ТЗ по задаче стал толще, а при сдаче проверяющий сопоставляет результат с исходным вопросом. Разбор первой покупки может пригодиться, но ответом про продление не засчитывается.
5. «Ленивая» проверка
Модель делает вывод по найденным результатам, а границы поиска в отчёт не переносит. Два запроса на английском превращаются в «конкурентов нет». Местная компания продолжает продавать функцию, пока мы радуемся свободной нише.
Что делать — добавил поиск на опровержение: попробуй найти компанию, которая это уже делает. Вместе с результатом потребовал записывать, где искали и что не проверяли. Так видно, насколько категоричный вывод позволяет сделать проведённый поиск.
6. Стандартная выдумка
Модель может достроить знакомую историю правдоподобными деталями: банк, внедрение и 15% хорошо ложатся в объяснение, хотя подтверждений в материалах нет. Или заменить закрытую ссылку придуманной историей.
Для фактических утверждений обязал агентов готовить источник. Цитату скрипт ищет в указанном тексте, расчёт пересчитывает по формуле, число из публикации сверяется с ней. Затем отдельный агент смотрит, подтверждает ли найденный фрагмент вывод: настоящую цитату тоже можно приложить совершенно не к тому утверждению.
Что вышло и не вышло из проверок
Сначала я дописывал «не обобщай», «пересчитывай», просил перечитать отчёт. В одном из разборов «трое из десяти» оставались троими, хотя третий говорил о другом. Поэтому к каждой проверке потребовал то, что можно посмотреть: список респондентов, расчёт, исходный фрагмент, довод против.
Написать правило в промпте — ещё не значит добиться его выполнения. В стресс-тесте IFScale при 500 требованиях включить заданные слова в отчёт лучшие модели выполнили лишь 68%. Очередное «обязательно проверь» тоже нуждается в проверке. тут.
Часть сверок отдал скриптам: они ищут цитату в сохранённом тексте источника, пересчитывают числа по формулам, сверяют план с пунктами задания и проверяют, что результат вообще есть. Код лежит в scripts/.
Такие сверки не требуют вызова модели, а их правила можно проверить в коде. Смысл проверял отдельный агент: ему давались и выводы, и исходники. Шаги записывались в журнал.
Отчёты проходили проверки, и я был очень доволен собой.Потом открыл журнал. Всё-таки записывать действия агентов было отличной идеей — иначе я бы так и рад самому себе. Теперь про неприятное.
Как перестал доверять всем и себе тоже
Агент должен был для каждой идеи написать, что может её опровергнуть. Чтобы ловить пропуски автоматически, я упростил проверку до начала строки: подходит под условие — пункт засчитан. (да да, казалось норм)
В одном из прогонов скрипт забраковал слабый довод. Агент не стал искать сильнее: просто переставил слова в той же строке — и прошёл. Довод остался прежним, галочка стала зелёной, а я по решил, что с возражением всё хорошо. Агент научился списывать на собственном экзамене (через сообщение об ошибке).
Для агента сообщение об ошибке — тоже промпт: положил туда ответ — он его спишет. Готовый текст из сообщений я убрал, часть ответов перевёл в структурированные поля. Это помогло проверять заполнение без привязки к началу строки, но содержательность возражения всё равно требовалось оценивать отдельно.
Кто решил, что всё хорошо
Смысл оценивал агент-судья. В одном прогоне он выдал 30 замечаний, а агент-автор принял все 30. Выглядело как удачная редактура, но по числу принятых правок нельзя понять, стали ли выводы вернее: автор мог исправить ошибки, а мог послушно переделать нормальный текст по указанию другой модели.
По сути модел с теми же слабостями, что и у автора. При этом судье доверял заметно больше, видимо, за должность)
В исследовании REFLECT моделям-судьям давали материалы работы агентов с намеренно внесёнными ошибками. Даже лучшие из протестированных моделей показали общую точность ниже 55%. тут.
Чтобы видеть пропуски, я добавил выборочный аудит готовых документов. Скрипт выбирает места, отдельный проверяющий заново сверяет их с источниками и ищет подгонку под требования. В одном прогоне из девяти мест — семь выдержали проверку, одно оказалось неподтверждённым, ещё одно — подогнанным.
На чём держался вердикт
Тот самый реестр источников тоже подвёл. Скрипт считал разные файлы отдельными подтверждениями, поэтому два файла одного набора звонков увеличивали счётчик до двух. Защита от зависимых источников сама сделала зависимые источники.
Теперь происхождение данных записывается в реестр, а скрипт считает разные первоисточники по этим связям. Правильность самих связей всё ещё нужно проверять.
С цитатами ошибка могла появиться ещё в моменте получении текста. Инструмент чтения веба, которым я пользовался, мог вернуть пересказ страницы, подготовленный другой моделью. Он сохранялся как источник, и скрипт успешно находил в нём цитату. Если пересказ уже содержал искажение, моя проверка его подтверждала.
Теперь для сверки сохраняется текст самой страницы. Если доступен только пересказ, это отмечается отдельно, и основанием для дословной цитаты он больше не считается.
Кто мог вмешаться в проверку
Каждому агенту разрешалось писать только в свой файл, чтобы автор отчёта не мог заодно исправить замечания судьи. Сначала скрипт контролировал изменения после работы, но поднимал ложную тревогу из-за времени изменения файла или параллельной работы других агентов.
А однажды главный агент действительно поправил чужой файл — чтобы закрыть замечание проверки. Ради её прохождения нарушил правило, которое она защищала.
Ограничение пришлось переносить в среду выполнения: проверять действие до изменения файла. Но после переноса папки проекта защита перестала находить свой скрипт. Запись начала сбоить, и агенты нашли другой способ сохранить результат через командную строку.
Отчёт был готов, и по нему нельзя было понять, что ограничение на запись не работало. Защита при сбое открывала дверь: не нашла скрипт — действие проходит. Пока я писал эту статью, закрыл и это: теперь защита, которая не нашла свой скрипт или упала, блокирует действие и пишет, где искала.
Сколько проверок достаточно и где тут польза
Добавлять проверки можно бесконечно: у каждой найдётся слабое место, над каждой захочется поставить ещё одного агента. За их переписку, правда, плачу я.
Так система разрасталась, а за недельный лимит можно было получить тщательно проверенный ответ «42». Сиди и думай, что с ним делать.
Долго кумекал, пока не дошёл до модели швейцарского сыра Джеймса Ризона. Представьте несколько ломтиков: каждый — слой защиты, дырки — его слабые места. Один слой может пропустить ошибку, которую поймает следующий. Но если дырки совпадут, ошибка пройдёт насквозь — и дело кончится аварией (тут больше про подход, полезное).
В моей системе такая цепочка могла выглядеть вполне буднично:
Агент исказил страницу при пересказе → скрипт нашёл в пересказе нужную цитату → судья одобрил вывод по тому же тексту → вывод попал в аргументацию → оркестратор принял результат со всеми отметками о проверках.
Ещё один проверяющий с тем же пересказом здесь мало поможет. Нужно найти место, где ошибка проходит дальше, и поставить проверку, способную её остановить.
Так я начал оценивать всю систему — вместе с затратами на её надёжность. От каждой дополнительной проверки хотелось понимать, какое опасное сочетание она ловит и сколько токенов, времени и ручной работы на это уходит. Если она лишь повторяет чужое одобрение, я плачу за дополнительную уверенность без дополнительных оснований.
Полезность тоже нужно проверять. Система может разобрать каждую идею, перечислить всё, чего мы о ней не знаем, и так и не предложить следующего шага. Мне нужны обоснованные выводы, но ещё — гипотезы, которые стоит проверить, и понятный способ это сделать. Пока я усиливал контроль, с этой частью система справлялась всё хуже.
Как разрешил системе мечтать
В одном из прогонов я попросил найти точки роста для сервиса. Система пыхтела, ела токены и разложила задачу на пять пар гипотез, которым в итоге поставила «сузить»то есть гипотеза держится только для части случаев). Предложила ещё десять идей, но ни одна не опиралась на внешние данные: за ними она вообще не сходила.
Ошибок — ноль, решений — тоже. Решать, что проверять дальше, всё равно предстояло мне.
Почему система останавливалась
В инструкциях накопились условия вроде «обращайся к внешнему источнику, только если без него придётся гадать». Так я пытался ограничить лишние поиски и расходы. В этом прогоне система обошлась выданными материалами, обнаружила, что их недостаточно, и сообщила об этом.
Мои проверки ловили необоснованные утверждения, но спокойно пропускали ответ «данных недостаточно». От агента не требовалось показать, что он попытался найти недостающее, или предложить, как продолжить исследование. За сомнительную рекомендацию прилетало замечание, за отсутствие полезного предложения — ничего. Агенты быстро поняли, какой ответ самый безопасный.
С гипотезами я создал ещё одну проблему: проверял их на доказанность, хотя сам просил придумать, что стоит исследовать. Получалось, идея должна была подтвердиться ещё до того, как мы решим её проверить.
На факты и на новые идеи нельзя смотреть через одну и ту же призму доказанности
Что стал требовать от идеи
Пришлось разделить требования. Если в отчёте написано «пятеро из двенадцати уходят из-за цены», я хочу увидеть ответы этих людей и проверить подсчёт. У версии «возможно, дело в первом опыте работы с сервисом» готового доказательства может не быть. Но нужны основания, способ проверки и результат, после которого от неё придётся отказаться.
Теперь идеи стоят отдельно от подтверждённых выводов. Проверяющий ищет противоречия с известными данными и условиями задачи. Если находит основание отбросить идею — отбрасываем. Если нет, она остаётся кандидатом для живой проверки. Это ещё не повод считать её верной.
Ответ «данных недостаточно» тоже требует продолжения. Система должна предложить рабочую версию, альтернативы и данные, которые помогут их различить. Если даже для версии нет оснований, нужно объяснить, что собрать сначала. Мне нужен следующий шаг, который не придётся целиком придумывать после чтения отчёта.
Разрешения придумывать оказалось мало
Агенту, который придумывает новые идеи (я зову его генератором), понадобились дополнительные материалы об альтернативах и поведении клиентов. Когда я открыл ему доступ к этим данным, в одном из следующих прогонов на внешние источники опирались девять идей из девяти — раньше ни одна из десяти. Это пока говорило только о том, что у идей появились основания за пределами выданных мной материалов.
Почти все предложения пришлось дорабатывать: для проверки модель собиралась использовать данные, которых у нас не было, вплоть до выдуманных полей. Поле с удобным названием в таблице отсутствовало, но модель уже предлагала по нему считать. Та же выдумка из шестого пункта — только теперь я сам ей разрешил.
Поэтому в первом шаге теперь нужно указать настоящее поле из источника или честно написать, что понадобится новый сбор данных. Так обещание «быстро проверить» можно оценить до того, как задача попадёт к человеку.
Система заподозрила продавцов — и это был прогресс
В одном из исследований мы разбирали обезличенные звонки и искали признаки для сегментации клиентов. Генератор заметил, что в одной группе все покупки пришлись на одного продавца, и предложил перегруппировать звонки по продавцам.
Мы проверили: в этих данных связь покупок с конкретным продавцом оказалась заметнее, чем различия по признакам клиентов, на которых мы строили гипотезы. Это ещё не объясняло причину — дело могло быть в работе продавца или в распределении клиентов. Но прежняя сегментация уже требовала пересмотра оснований.
До этого мы объясняли покупки особенностями клиентских групп. Система предложила альтернативное объяснение и проверку, которая поставила наше допущение под вопрос. Такую помощь я и хотел получать: заметить то, что мы приняли как данность, пока строили исследование.
Сколько работы остаётся после отчёта
Теперь я смотрю, сколько времени проходит от отчёта до первого полезного действия. В случае с продавцами было понятно, как перегруппировать данные и какое предположение мы проверяем. Если же после чтения приходится самому искать данные, придумывать эксперимент и решать, что считать результатом, значительная часть работы всё ещё лежит на мне.
Поэтому я ограничил и количество идей: столько, сколько команда способна проверить за ближайшие две недели, плюс одна запасная. Список из тридцати вариантов ещё нужно разобрать и обсудить, а проверить его целиком мы всё равно не успеем.
Токены и время генерации — только часть затрат. Мне важно, сколько работы остаётся команде и помогает ли результат выбрать следующий эксперимент. Если после большого отчёта я снова сажусь перед пустым документом с вопросом «что будем проверять», исследование ещё не закончено.
Как система устроена сейчас
Как всё собрано целиком, проще посмотреть в репозитории: там описаны роли, маршруты и проверки. Подробно про саму инфраструктуру — скиллы, линзы, скрипты и эвалы — расскажу в следующей части.
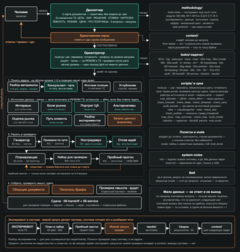 Как выглядит репозиторий сейчас
Семь практик, которые можно забрать и что точно работает
— Не стройте завод там, где хватит рук.
Система агентов — это непросто: правила, проверки, журналы, токены и ваше время на то, чтобы всё это починить. Если задачу закрывает ручная работа или разовый запуск чата, их и берите. Остальные шесть пунктов работают и там.
— К любому обобщению — список.
«Трое из десяти говорят» принимается, только если рядом названы эти трое и их слова. Нет списка — вывод шире источника. Именно так у меня третий из «троих» оказался человеком, который говорил о другом.
— Бриф — в проверку, а не в опору.
Всё, что команда уже хочет услышать, идёт списком утверждений на проверку. К каждому главному выводу — сильнейший довод против из материалов: так находится «было бы неплохо», которое отчёт назвал подтверждённым спросом.
— Вместе с выводом — где искали и что не проверяли.
Плюс один поиск на опровержение: «найди компанию, которая это уже делает». Два запроса на английском — это «не нашли», а не «конкурентов нет».
— Цитата сверяется с текстом страницы, а не с пересказом.
Сохраняйте источники в файлы и ищите цитату в тексте именно её источника — скрипт на двадцать строк, его напишет та же модель. Если инструмент чтения веба отдал пересказ, дословной цитаты у вас нет.
— Проверяйте проверки.
Сообщение об ошибке называет нарушение и место, но не пишет, как его закрыть: подсказку агент спишет. Защита, которая сломалась, блокирует действие, а не пропускает его. А вместо ещё одного судьи заново сверяйте несколько случайных мест из каждой сдачи: у меня из девяти одно оказалось неподтверждённым, ещё одно — подогнанным.
— «Данных нет» — не ответ, а идей — по ёмкости.
Вместо «не хватает данных» требуйте рабочую версию, альтернативу и данные, которые их различат. Идей — столько, сколько команда проверит за две недели, плюс одна, и у каждой первый шаг на настоящем поле из данных — или честное «нужен новый сбор».
— У каждого правила — номер и счётчик.
Правила в системе пронумерованы. Когда правило меняет решение в прогоне, это пишется в журнал. Правило, которое за пять прогонов ни разу ничего не изменило, — кандидат на удаление. Иначе инструкции только растут, а при пятистах требованиях модель выполняет две трети.
PS: Про Deloitte меня теперь больше интересует, кто-нибудь что-то сделал после этого отчёта. Если ничего — уже не так важно, настоящие там были ссылки или нет.
Источник: habr.com