
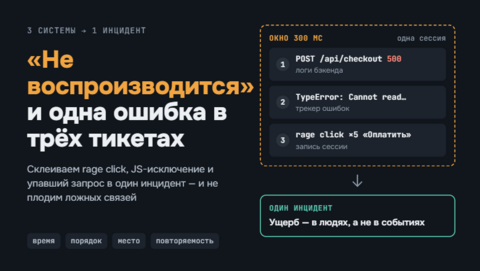
Ошибка в трекере, пачка 500 в логах бэкенда и яростные клики в записи сессии. Обычно это одна проблема, разложенная по трём системам. Разбираю, как собрать её в один инцидент и не наплодить ложных связей.
Привет! Я Паша, участвую в разработке сервиса записи сессий Broux. Ниже описано, как мы решали эту задачу у себя.
Картина, знакомая, наверное, каждому. В трекере ошибок висит TypeError: Cannot read properties of undefined. В логах бэкенда пачка 500 на /api/checkout. В записях сессий кто-то пять раз подряд жмёт «Оплатить».
Три инструмента, иногда три команды, три тикета. Связь между ними видит только тот, кто догадался сопоставить время. Обычно это происходит через неделю, когда в поддержку пишет клиент, а разработчик отвечает «не воспроизводится».
Почему это не склеивается само
У каждого источника свой идентификатор: у трекера ошибок id события, у бэкенда trace id, у записи id сессии. Часы клиента и сервера расходятся, иногда на секунды. И группируют всё по-разному: ошибки по стеку, запросы по эндпоинту, rage click по элементу. Чтобы найти связь, приходится вручную пересекать три выборки по времени.
Что их связывает
Самый надёжный общий контекст это сессия. Если клик, исключение и запрос пишутся одним SDK в одну сессию, у них один источник времени (часы клиента), и события можно сравнивать между собой без поправки на расхождение часов.
Дальше работают несколько сигналов.
Время. События попадают в одно окно. Мы берём 300 мс после клика. За это время успевают отработать синхронный обработчик и ближайшие промисы, а фоновый шум страницы почти не попадает. Если окно растянуть до секунд, к любому клику что-нибудь да приклеится. Сам rage click — это четыре клика и больше по одному элементу за 750 мс. Чтобы считать клик мёртвым, ждём реакцию интерфейса 500 мс.
Порядок. Ожидаемая цепочка выглядит так: запрос упал, обработчик бросил исключение, кнопка перестала реагировать, пользователь кликает снова. Если rage click случился раньше запроса, связь сомнительная.
Место. Rage click и исключение привязываются к одному элементу: ошибки ищутся вокруг кликов именно по нему, а не по всей странице. Если по стеку видно, что исключение брошено в обработчике этой кнопки, связь почти наверняка настоящая.
Повторяемость. Одна и та же связка встречается у разных пользователей. Одиночное совпадение может быть случайным, а двадцать одинаковых уже нет.
Ложные связи
На них уходит большая часть усилий.
Самая частая причина ложных связей это чужие скрипты. Виджет чата или счётчик бросает исключения постоянно и без всякой связи с действиями пользователя. При широком окне он «приклеится» к любому rage click на странице. Первая линия защиты — узкое окно. Виджет, который бросает ошибку раз в несколько секунд, редко попадает в 300 мс после клика случайно. А если и попал, его отсеивает повторяемость: у других пользователей совпадения не будет. Ошибки из скриптов с чужого домена без CORS приходят как безликое Script error. без стека, и мы помечаем их отдельно. Остальной шум одним действием переводится в «Игнорируется» с причиной («ложное срабатывание», «незначительно») и больше не всплывает.
Вторая причина: медленный запрос без ошибки. Пользователь кликает повторно, потому что ждёт, а ничего не сломалось. Это проблема быстродействия, и её нужно разбирать отдельно, а не склеивать с исключением, которое случилось рядом.
Третья: многократные клики, которые так и задуманы. Кнопки «плюс» и «минус» в корзине, листалка галереи, счётчик. Порог высокий: четыре клика за 750 мс по одному элементу, и не больше одного срабатывания в 5 секунд на элемент. В нормальном режиме «плюс» в корзине так не нажимают. Второй фильтр — реакция интерфейса: если после клика изменился DOM, пошла навигация, прокрутка или ушёл запрос, интерфейс жив и клик не считается мёртвым. Если счётчик всё же попадёт в выдачу, хватит один раз пометить его как ложное срабатывание.
Считать людей, а не события
Когда связка собрана, возникает вопрос, насколько всё плохо. Счётчик событий здесь врёт. Двести срабатываний у одного человека с залипшей мышью и двадцать срабатываний у десяти разных платящих клиентов дают одинаковый порядок цифр, но это совершенно разные приоритеты.
Поэтому мы решили считать ущерб в людях: инцидент описывается списком затронутых пользователей, а не числом событий. Приоритет ставится по нему.
И последнее: инцидент удобно вести как задачу с жизненным циклом, от обнаружения до исправления. Отдельно стоит различать случай, когда связка вернулась после фикса. Иначе починенное и вернувшееся выглядят в списке одинаково, и регрессию легко пропустить.
Источник: habr.com