
После публикации моей первой статьи я пообщалась с одним из авторов комментариев к ней, который сообщил мне интересный факт: замена длинных тире на дефисы может привести к изменению вывода Думейта об авторстве текста на противоположный. Камиль Гадеев [ https://habr.com/ru/users/Kamil_GR/] сделал этот вывод на сгенерированном маленьком тексте (около 150 слов), для которого оценка Думейта была 100% ИИ, а после замены всего четырех(!) длинных тире на дефисы эта оценка кардинально изменилась, составив для того же текста 0% ИИ.
В тот момент я подумала, что причина ложного срабатывания в размере текста, и запросила Думейт напрямую о минимальном размере, который разработчики считают достаточным для надежных оценок своего детектора, а также о том, знают ли они о влиянии длинных тире на свой вердикт. Техническая поддержка Думейта сообщила о желательном размере в 10 страниц, по моему мнению, разработчики излишне страхуются и реальные размеры как минимум вдвое меньше. Техподдержка подтвердила также, что компания сталкивалась с ситуациями, когда длинное тире влияет на результат, однако опубликованных исследований, по их сведениям, на эту тему не было. Настоящая статья, надеюсь, будет побудительным мотивом для разработчиков Думейта внести необходимые изменения в свою модель для устранения типографических проблем.
В ходе своих последних тестирований Думейта на текстах с достаточным размером я сама столкнулась с большой ложноположительной оценкой ИИ при проверке собственного человеческого текста. При этом, оценка Думейтом моего исходного текста показала 0% ИИ при 90% оригинальности, а его оценка текста, полученного после двойного перевода исходника RU-EN-RU составила уже 51,1% ИИ при практически той же оригинальности. Пытаясь понять причину столь странной оценки, я попросила Claude (Anthropic) выполнить посимвольное сравнение исходного и конечного текстов. И эта процедура оказалась чрезвычайно полезной, поскольку помимо обычных замен человеческих слов и фраз на более шаблонные, характерные для ИИ, она обнаружила замену в конечном тексте буквы «е» на «ё» и моих любимых кавычек “” на «». Я решила проверить влияние типографики на вывод детектора, для чего заменила в конечном тексте 33 «ё» на «е» и 12 кавычек- елочек («») на кавычки-лапки (“”).
Результат был невероятно сильным: Думейт снизил долю ИИ с 51,1% до 16,83 % при той же оригинальности. Замечу, что текст остался абсолютно тем же, изменилось несколько значков в его оформлении— чистая типографика.
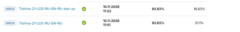 Рисунок 1. Результаты проверки моего текста до замены типографики и после нее
Изменение типографики произошло в данном случае при переводе ИИ-чатом английского варианта текста обратно на русский, при котором чат использовал отличные от авторских типографические значки. Именно это привело к существенному увеличению признаков ИИ-генерации для модели, используемой Думейтом. Идея, высказанная Камилем в отношении длинных тире, подтвердилась и для других символьных обозначений – для буквы «ё» и кавычек-елочек «». Думейт считает существенным признаком ИИ-присутствия использование длинных тире (в отличие от дефиса), буквы «ё» ( вместо «е») и кавычек-елочек ( « » ) вместо кавычек-лапок («).
Я проверила этот вывод на трех оригинальных работах студентки филологического факультета регионального университета Б-вой, написанных в разные годы (2024, 2025 и 2026 гг.). Работы предоставил ее научный руководитель для моего исследования. Девушка, кстати, отличница, и все три работы были ею защищены на «5», причем проверка на присутствие ИИ в студенческих работах впервые была проведена вузом только летом 2026 г. Тогда Антиплагиат показал около 25% ИИ-доли в ее ВКР. Вместе с тем, результаты моего тестирования всех трех работ российскими детекторами в ноябре 2026 г.( актуальная версия Думейта и версия Антиплагиата 1.9.2 от 10.11.26 г.) показали существенную долю ИИ-текста в работах 2025 и 2026 гг. При этом ИИ-доля увеличивалась в каждом следующем году, что могло свидетельствовать о все более близкой совместной работе девушки и ИИ-чатов ( см. мои комментарии в таблице к полученным результатам детекторов).
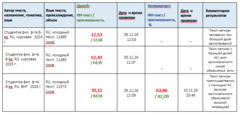 Таблица 1. Результаты проверки российскими вузовскими детекторами оригинальных работ студентки Б-вой
Вместе с тем, эти работы особенно подходят для выяснения влияния типографики на вывод детектора, поскольку эта студентка-филолог часто использует «ё», а также приводит множество цитат, обозначая кавычки елочкой.
В таблице 2 представлены результаты следующего эксперимента: в каждой работе Б-вой я заменила все длинные тире на дефисы, «ё» на «е» и кавычки-елочки «» на кавычки- лапки “”.
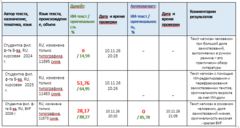 Таблица 2. Результаты проверки российскими вузовскими детекторами работ студентки Б-вой после изменения типографики
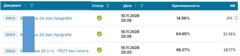 Рисунок 2. Оценки Думейтом текстов Б-вой после замены типографики
Результаты тестирования Думейтом работ Б-вой после описанной выше замены значков, таким образом, подтвердили корректность сделанного ранее вывода о важности применяемой типографики. Я также сделала такую проверку для работы 2026 г. другим российским детектором – Антиплагиатом, чтобы понять, насколько важна типографика для актуальной модели наиболее популярного вузовского детектора. Были, в частности, заменены 33 «ё», 54 кавычки-елочки и 4 длинных тире. И оказалось, что это тоже так, причем, различие результатов тестирования исходного текста и этого же текста с заменой типографики у Антиплагиата еще больше, чем у Думейта:
Думейт 70,12% → 28,17%, Антиплагиат 63,86% → 0%.
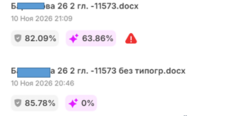 Рисунок 3. Оценки Антиплагиатом текста ВКР Б-вой до и после замены типографики
Ниже я показываю для сравнения две картинки из отчетов Антиплагиата по ИИ-генерации для этих двух идентичных текстов, отличающимся только разным обозначением кавычек, тире и букв «ё». Тем не менее изменение типографики по факту изменило отношение обоих российских детекторов к авторству текста.
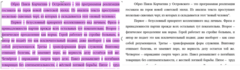 Рисунок 4. Сравнение ИИ-отчетов Антиплагиата по тексту ВКР Б-вой до и после замены типографики, розовым детектор помечает фрагменты ИИ-текстом
Эти результаты позволяют частично оправдать студентку Б-ву, поскольку оба детектора показали отсутствие ИИ или его допустимо низкий уровень для текстов 2024 и 2026 гг. Однако, оценка текста за 2025 г. свидетельствует об обратном: «личная» типографика автора не всегда играет существенную роль в оценке детектора, а только в том случае, если ее в тексте много, а претензии детектора к содержательной части малы или отсутствуют. Доказательством этого служат результаты оценки за курсовую работу, выполненную в 2025 году: как следует из таблицы 2, в этом случае замена типографики не помогла, объем ИИ-текста уменьшился лишь на долю процента, оставшись вблизи 50%. Этот факт свидетельствует о том, что в данном случае к оценке текста как сгенерированного привела не типографика, а его содержание, имеющее сильные признаки ИИ-генерации.
Судя по результатам проведенного тестирования существуют как содержательные, так и оформительские признаки ИИ-генерации текста, на которые опираются российские детекторы при построении своих моделей. В зависимости от того, каких ИИ-признаков в тексте больше, и как они расположены по всему объему, общая оценка складывается как сумма тех и других ИИ-фрагментов, либо как один из них, поглощающий другой.
Чувствительность детектора GPTZero к российской типографике, разумеется, практически отсутствует – я это проверяла, разница оценок составляет единицы процентов.
Таким образом, в настоящее время оценка ИИ-доли текста на русском языке, определяемая обоими российскими детекторами, существенным образом зависит от типографики текста. Мне известны 3 значка, замена которых помогает снизить объем ИИ-фрагментов в тексте, возможно, их больше.
Разумеется, я уверена, что Антиплагиат и Думейт найдут способ корректно оценивать типографику текстов в ближайшее время. А пока это не так, я не даю совет, как обмануть ИИ-детектор – я предлагаю помочь ему избежать ложноположительных результатов.
Вывод: перед проверкой своего текста сделайте названные здесь замены значков, это повысит Ваш шанс получить корректную оценку вузовских детекторов.
Источник: habr.com