
Как накормить ИИ-агента кодом и не разориться на контексте: мой опыт без векторной магии
Практическое руководство по тому, как я подружилась с большими репозиториями без ML, pgvector (расширение Postgres для работы с векторными эмбеддингами) и слива бюджета на API: выбираю нужные файлы с помощью токенизации, лёгкого стемминга и SQL-запросов.
Боль: Закармливать LLM всей кодовой базой — быстрый способ сжечь бюджет, поймать галлюцинации и уснуть в ожидании ответа. Спасение: Лаконичный семантический индекс на PHP и SerenaDB, срезающий ~98% лишнего контекста благодаря базовому частотному анализу и аккуратному расширению запросов (используя TF-IDF — статистическую меру важности слов в контексте документов).
С чего всё началось и почему я наступала на эти грабли
Когда я закидываю в ИИ-агента крупный проект (>500 файлов), реальность быстро приземляет:
-
Объем промпта возрастает до нескольких мегабайт.
-
Возрастает уровень галлюцинаций (генерация несуществующих методов и классов).
-
Время генерации ответа затягивается.
-
Превышаются лимиты контекстного окна (Context Window Exceeded).
Чего я хотела: Без лишнего шума и внешних сервисов мгновенно отсеять мусор и отдать модели ровно 10–20 нужных исходников.
Что я строила и по каким числам поняла, что не зря
Сразу о границах, иначе разговор уедет в «а почему не эмбеддинг». Я делала не поисковую систему и не «второй мозг» для репозитория, а небольшой модуль конвейера: на вход — корень проекта и текст задачи, на выход — список путей, которые не стыдно показать модели. Ни генерации кода, ни поиска «по смыслу» — только отбор. И всё это на CPU, без embedding-API: SerenaDB живёт без pgvector и без нормального FTS, так что вариантов у меня было особо немного.
Моя ставка была простая: в коде релевантность — это совпадение идентификаторов и доменных слов, а не векторная близость. Проверяла я её числами:
Что меряла
Цель
Что вышло
Сколько контекста уходит модели
≤ 150 КБ
84–111 КБ
Насколько похудел контекст
≥ 95 %
~97–98 % (≈4 МБ → ≈100 КБ)
Попал ли нужный файл в топ-N (hit@N)
100 % на 10–20 задачах
1 из 1: целевой файл в топ-7
Отбор на тёплом индексе
≤ 100 мс
поиск 1.5–10 мс
Первый проход по 500 файлам
≤ 30 с
8–30 с, медиана 28 с
Вызовы embedding-API
0
0
Время ответа LLM я здесь не считаю: это отдельная история, которая зависит от внешнего API сильнее, чем от моего кода. Поэтому дальше я всегда уточняю, о каком этапе речь.
Архитектура решения
Мой конвейер обработки состоит из пяти основных шагов:
Этап
Что происходит
Инструмент
1. Файлы проекта
Рекурсивный обход, пропуск vendor/.git/node_modules
RecursiveCallbackFilterIterator
2. tokenize() + symbolTerms()
Режу код на слова, извлекаю символы (sym:), убираю стоп-слова
preg_match_all + mb_strtolower
3. farm_terms
Сохраняю: слово → файл → частота появления
SQL DELETE + INSERT
4. searchRelevant()
rankByTfIdf() / rankBySumFreq() + pathBonus() + extFactor()
SELECT + GROUP BY + ORDER BY
5. LLM
Получает только топ-N релевантных файлов (~100 КБ вместо 4 МБ)
Claude / GPT API
Первый проход по проекту — это холодная индексация: на бэкенде около 500 файлов она занимает 8–30 секунд (медиана 28), на фронтенде из ~1200 файлов через Docker bind-mount — до 80 секунд. Повторный recon на тёплом индексе — доли секунды. Подробные замеры рассмотрю ниже в разделе про бенчмарки.
Почему я не стала городить векторный поиск
Векторные эмбеддинги прекрасны для поиска смыслов в статьях, но в коде мне нужны не «чувства и настроения», а конкретные методы, классы и переменные. И тут оказывается, что старые добрые точные совпадения работают в разы круче и предсказуемее.
Критерий
Векторные эмбеддинги
FTS (полнотекстовый поиск)
Мой подход (TF-IDF / SUM)
Требования к БД
Расширение pgvector
tsvector / to_tsvector
Любая реляционная БД (SerenaDB)
Скорость индексации
Медленно (нужна embedding-модель)
Средне
Быстро, чистый CPU
Работает офлайн
Нет (нужен API)
Да
Да
Качество на коде
Хорошее для смысла
Плохое (морфология ломает)
Отлично для идентификаторов
Объяснимость результата
Сложно объяснить
Средне
Прозрачно: вот частоты
Зависимости
ML-модель + embedding API
СУБД с FTS
PHP + PDO
Мой выбор: Векторы дают красивый оверхед, а частотно-лексический анализ просто работает — работает на ура, без неприятных сюрпризов и не стоит ни копейки.
Почему не BM25
BM25 — стандарт, мимо которого в разговоре про ранжирование не пройти, и я его честно рассматривала. Формула выглядит так:
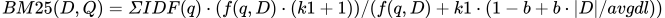
У BM25 два трюка: IDF и насыщение TF — двадцатое упоминание слова добавляет меньше, чем второе. Плюс нормализация на среднюю длину документа. IDF у меня уже есть, нормализация длины тоже, только грубее: делю на ln(1 + size). Насыщения нет, и это не забывчивость.
Причина, по которой BM25 мне не подошел, лежит не в формуле, а в постановке задачи. BM25 улучшает порядок среди файлов, в которых уже есть слова запроса. Моя главная проблема была обратной: нужный файл часто вообще не содержит слов из задачи. Просят «исправить ключи DTO в договорах», а в ItemDto.php нет ни «ключей», ни «исправить» — их туда только предстоит добавить. Никакое ранжирование по совпадениям такой файл не поднимет: поднимать нечего. Это делают не BM25, а ролевые термины и бонус за путь, и именно они дали основной прирост в моих задачах.
Остальные причины были чисто инженерными:
-
avgdl нужен в терминах, а у меня размер в байтах. Считать AVG(size) можно, но это ещё один агрегат в запросе и ещё один шанс свалиться в fallback на диалекте SerenaDB.
-
k1 и b надо настраивать на размеченной выборке. У меня её нет: семь файлов на одном кейсе — это не датасет. Без настройки BM25 даёт необъяснимые скоры, а объяснимость для меня — требование, а не украшение: я показываю, почему файл попал в топ.
-
Частоты в исходниках обычно 3–20. Насыщение TF начинает работать на десятках и сотнях, то есть где-то не здесь.
-
Чем больше функций в запросе, тем выше шанс, что SerenaDB его не примет. Простой запрос предсказуемее.
Так что TF-IDF здесь для меня — не упрощение от незнания, а осознанно выбранный компромисс: он закрывает редкость термина и размер файла, а основную семантику дают ролевые термины.
Реализация токенизации
Я разбираю файл на составляющие и собираю аккуратную карту ключевых слов с частотами.
Мои правила разбиения:
-
Разбивать camelCase: ItemService → [item, service]
-
Разбивать snake_case: signing_date → [signing, date]
-
Разбивать SCREAMING_SNAKE: SIGNING_DATE → [signing, date]
-
Исключение синтаксических стоп-слов: public, function, return, null, true и др.
-
Фильтрация токенов короче 2 символов.
Грабли, на которые я наступила с camelCase:
Разбивать составные названия важно СТРОГО ДО того, как вы приведёте всё к нижнему регистру через mb_strtolower. Иначе заглавные буквы исчезнут вместе с границами слов.
Реализация метода tokenize():
private function tokenize(string $text): array{ if (self::$stopwords === null) { self::$stopwords = array_flip(self::STOPWORDS); } if (!preg_match_all('/[a-zA-Zа-яА-ЯёЁ0-9_]+/u', $text, $matches)) { return []; } $terms = []; foreach ($matches[0] as $raw) { $subWords = preg_split('/(?<=[a-z])(?=[A-Z])|_/', $raw); foreach ($subWords as $word) { $word = mb_strtolower(trim($word), 'UTF-8'); if (mb_strlen($word, 'UTF-8') stemRussian($word); $terms[$stemmed] = ($terms[$stemmed] ?? 0) + 1; } } return $terms;}Стемминг русского языка
Для сопоставления русскоязычных ТЗ с исходным кодом я применила лёгкий суффиксный стеммер с ограничением минимальной длины основы (RU_STEM_MIN = 4):
private function stemRussian(string $word): string{ if (!preg_match('/[а-яё]/u', $word)) { return $word; } foreach (self::RU_SUFFIXES as $suffix) { $len = mb_strlen($suffix, 'UTF-8'); if (mb_substr($word, -$len, null, 'UTF-8') === $suffix) { $base = mb_substr($word, 0, -$len, 'UTF-8'); if (mb_strlen($base, 'UTF-8') >= self::RU_STEM_MIN) { return $base; } } } return $word;}Из индексов я исключаю:
-
Ключевые слова PHP и языков: public, private, protected, static, function, return, class, interface…
-
Конструкции и типы: if, else, try, catch, void, int, string, bool, null, true, false…
-
Английские служебные слова: the, and, or, for, to, of, in, on, with, as, from, this, that…
Нюанс: В константе RU_SUFFIXES окончания у меня отсортированы по длине (чтобы отрезать «ого», а не случайно зацепить «о»), а базовую длину основы я держу не меньше RU_STEM_MIN = 4.
Структура БД
Хранение индекса я организовала в трёх таблицах (плюс служебная farm_meta):
CREATE TABLE IF NOT EXISTS farm_projects ( id SERIAL PRIMARY KEY, root TEXT UNIQUE NOT NULL, name TEXT NOT NULL);CREATE TABLE IF NOT EXISTS farm_files ( id SERIAL PRIMARY KEY, project_id INT NOT NULL, path TEXT NOT NULL, size BIGINT, mtime BIGINT, content TEXT, UNIQUE(project_id, path));CREATE TABLE IF NOT EXISTS farm_terms ( project_id INT NOT NULL, term TEXT NOT NULL, path TEXT NOT NULL, freq INT NOT NULL DEFAULT 1, PRIMARY KEY(project_id, term, path));CREATE INDEX IF NOT EXISTS farm_terms_term_idx ON farm_terms (project_id, term);CREATE TABLE IF NOT EXISTS farm_meta ( k TEXT PRIMARY KEY, v TEXT NOT NULL);Поля size и mtime используются для инкрементальной индексации: при повторном запуске я обрабатываю только изменённые или новые файлы. В content лежат первые 30 КБ файла — этого хватает для токенизации, а потом пригодится для сниппетов. В farm_meta хранится версия схемы индекса: при её смене indexProject() делает полную переиндексацию, иначе старые термины перестанут совпадать с новыми.
Почему IF NOT EXISTS: initSchema() вызывается при каждом подключении, и без этой проверки повторный запуск на существующей базе упадёт на «relation already exists».
Алгоритм поиска и ранжирования
Скор у меня складывается из двух частей. SQL считает, сколько в файле нужных слов и насколько они редкие. PHP добавляет вес за имя файла — за то, насколько сам путь похож на то, что просят.
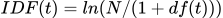
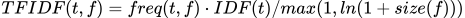
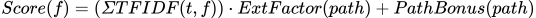
N — это SELECT COUNT(*) FROM farm_files WHERE project_id = :pid, общее число файлов проекта. df(t) — в скольких файлах встретился термин, это и есть IDF. size(f) — размер файла, которым я приглушаю «толстые» файлы, чтобы они не выигрывали только за счёт объёма. Сверху — расширение (.php весит 1.0, .md — 0.3, тесты — 0.6) и бонус за совпадение токена с путём.
IDF и нормализация длины считаются прямо в SQL:
SELECT t.path, SUM(t.freq * LN((? * 1.0) / (1.0 + d.cnt))) / GREATEST(LN(1.0 + GREATEST(COALESCE(MAX(f.size), 0), 0)), 1.0) AS scoreFROM farm_terms tJOIN ( SELECT term, COUNT(DISTINCT path) AS cnt FROM farm_terms WHERE project_id = ? AND term IN (?, ?, …) GROUP BY term) d ON d.term = t.termLEFT JOIN farm_files f ON f.project_id = t.project_id AND f.path = t.pathWHERE t.project_id = ? AND t.term IN (?, ?, …)GROUP BY t.pathORDER BY score DESC, t.path ASCLIMIT ?;d.cnt — это df(t). LN((? * 1.0) / (1.0 + d.cnt)) — IDF. MAX(f.size) — размер файла; он стоит под агрегатом, потому что path уникален, а GROUP BY требует агрегат. GREATEST(…, 1.0) — страховка от деления на ноль и от логарифма меньше единицы. Кандидатов я беру с запасом ×4, а финальный топ-N режу в PHP после бонусов: иначе файл, который выстрелит бонусом за путь, может не попасть в черновой список.
Если SerenaDB не принимает LN и GREATEST в подзапросе, у меня остаётся запасной вариант — SUM(freq):
SELECT path, SUM(freq) AS scoreFROM farm_termsWHERE project_id = ? AND term IN (?, ?, …)GROUP BY pathORDER BY score DESC, path ASCLIMIT ?;Это не TF-IDF: здесь IDF = 1, нет нормализации длины. Упрощённый режим я использую на случай отказа диалекта. В логах я всегда пишу, какой режим сработал, иначе отладка превращается в гадание.
Второй слой — бонус за путь. Он не про содержание файла, а про его роль в проекте:
private function pathBonus(string $path, array $termWeights): float{ $bonus = 0.0; $lowerPath = mb_strtolower($path, 'UTF-8'); foreach ($termWeights as $term => $w) { if (str_contains($lowerPath, (string)$term)) { $bonus += $w * 2.0; } } return $bonus;}Путь я сравниваю в нижнем регистре: термы уже lowercase, а пути в PSR-4 CamelCase — без этого бонус молча не срабатывал бы на большинстве проектов. Коэффициент 2.0 — это мягкий усилитель: после введения TF-IDF старый ×5 перевешивал содержимое файла, и я его снизила.
Есть и осознанные компромиссы. Вес термина из задачи в SQL не попадает: rankByTfIdf() берёт только имена терминов, а min(freq, 3) влияет на бонус за путь. Так запрос остаётся простым и переносимым, а «крик» одного слова в задаче всё равно ограничен. И при df = N IDF уходит в небольшой минус — ln(N / (N + 1)). Это не баг, а мягкий штраф за «вездесущие» термины: они и так есть везде, поднимать их незачем. Каноничнее было бы ln((N − df + 0.5) / (df + 0.5)), но на моих объёмах разница уходит в третий знак.
Обогащение запросов ролевыми терминами
А что делать, если в ТЗ написано «поправить ключи», а нужного слова в коде отродясь не было? Я подключаю хитрость — обогащаю запрос ролевыми терминами и синонимами через expandSynonyms():
private function expandSynonyms(array &$termWeights): void{ foreach (self::SYNONYM_GROUPS as $group) { $found = false; $maxW = 0.0; foreach ($group as $item) { if (isset($termWeights[$item])) { $found = true; $maxW = max($maxW, (float)$termWeights[$item]); } } if ($found) { foreach ($group as $item) { if (!isset($termWeights[$item])) { $termWeights[$item] = $maxW; } } } } foreach (array_keys($termWeights) as $t) { if (in_array($t, ['договор', 'договорн', 'contract', 'item', ''], true)) { foreach (['contract', 'item', 'items', 'dto', 'usecase', 'use_case'] as $x) { if (!isset($termWeights[$x])) $termWeights[$x] = 1; } } if (in_array($t, ['document', 'documents', 'документ', 'документн', 'список'], true)) { if (!isset($termWeights['document'])) $termWeights['document'] = 1; } if ($t === 'hr' || str_contains($t, 'hr') || $t === 'hrservice') { if (!isset($termWeights['hr'])) $termWeights['hr'] = 1; } if (in_array($t, ['controller', 'контроллер', 'сервис', 'service'], true)) { if (!isset($termWeights['service'])) $termWeights['service'] = 1; if (!isset($termWeights['controller'])) $termWeights['controller'] = 1; } }}Таблица правил ролевых терминов
Слово в задаче
Что добавляется в запрос
Какие файлы всплывут
договор / contract / item
contract, item, dto, usecase
ItemDto.php, ContractService.php
document / документ / список
document
DocumentRepository.php, DocList.php
api / apicid / apiservice
api
ApiService.php, ApiController.php
контроллер / controller / сервис / service
service, controller
PaymentService.php, UserController.php
сотрудник / employee / родственник
employee, staff, personnel (из SYNONYM_GROUPS)
EmployeeService.php, StaffRepository.php
Расширение словаря синонимов
Доменные группы я задаю в константе SYNONYM_GROUPS:
private const SYNONYM_GROUPS = [ ['сотрудник', 'employee', 'staff', 'personnel'], ['договор', 'contract', 'item'], ['счет', 'счёт', 'invoice'], ['поиск', 'search'],];Пример ранжирования файлов
Покажу пример выполнения запроса «исправить ключи DTO в договорах» на моем проекте из 500 файлов:
Шаг 1: токенизирую задачу
[‘исправит’ => 1, ‘ключ’ => 1, ‘dto’ => 1, ‘договор’ => 1]
tokenize() прогоняет слова через stemRussian(), поэтому в запросе именно эти формы. Ролевое правило срабатывает по слову «договор».
Шаг 2: расширяю ролевыми терминами
// 'contract', 'item', 'dto', 'usecase'$termWeights = [ 'исправить' => 1, // из задачи 'ключи' => 1, // из задачи 'dto' => 1, // из задачи + ролевой 'договорах' => 1, // из задачи 'item' => 1, // ролевой 'items' => 1, // ролевой 'usecase' => 1, // ролевой];Шаг 3: SQL-запрос + path-бонусы → итоговый рейтинг
Файл
freq
df
TF-IDF
ExtFactor
PathBonus
Итог
src/Dto/ItemDto.php
item 5, dto 8
5 / 1
7.62
1.0
+2 (dto)
9.62
src/Contracts/ItemContract.php
contract 7, item 4
1 / 5
6.62
1.0
+2 (contract)
8.62
src/UseCases/CreateItem.php
usecase 6, item 3
1 / 5
5.59
1.0
+2 (usecase)
7.59
src/Services/ItemService.php
item 12
5
5.83
1.0
0
5.83
tests/ItemTest.php
item 3
5
1.66
0.6
0
0.99
src/Utils/Helper.php
—
—
0
1.0
0
0
Порядок: ItemDto → ItemContract → CreateItem → ItemService → ItemTest. Helper.php в выдачу не попадает вовсе.
Обратите внимание на сервис: двенадцать упоминаний item не спасают его от четвёртого места. dto встречается в одном файле из пятисот, item — в пяти, поэтому IDF у dto выше, а размер файла больше. Это ровно то поведение, ради которого я вводила IDF, и его видно в цифрах: двенадцать упоминаний частого слова проигрывают восьми упоминаниям редкого.
Вы можете проверить это на калькуляторе: N = 500, IDF(dto) = ln(500 / 2) ≈ 5.52, IDF(item) = ln(500 / 6) ≈ 4.42, дальше делим на ln(1 + size). Всё сходится до второго знака.
Практический пример реального запроса к системе
Представим, что я отправляю ИИ-агенту масштабную задачу по фронтенду:
Запрос: «Нужно в компоненте ExampleModal.vue: под кнопками выводится информационное сообщение „Для выполнения действия скачайте и ознакомьтесь с файлом“; если успешно скачан документ типа TEST — под кнопками вывести две новые кнопки: красную „Подтвердить“ и серую „Отклонить“; при нажатии „Отклонить“ — ниже окно ввода сообщения не менее 10 символов; при пустом — уведомление „заполните комментарий“…»
Цифра
Сценарий
Что входит
Индекс тёплый?
0.42 с
бэкенд, recon
локальный этап
да
8–30 с (медиана 28 с)
бэкенд ~500 файлов, первый проход
локальный этап, холодная индексация через bind-mount
нет
80.87 с
фронтенд ~1200 файлов, первый проход
локальный этап, холодная индексация через bind-mount
нет
107.6 с
фронтенд, шаг 5
только ответ LLM
—
0.42 с и 80.87 с — это не один замер в разных условиях, а разные проекты и разное состояние индекса. Разница в две сотни раз тут не сюрприз, а следствие: другой проект, другой индекс. И 107.6 с — про другой этап. Складывать его с 80.87 с можно, только если назвать сумму «полный цикл вместе с LLM».
Что сделал мой конвейер (строки реального лога):
-
Этап 1/3: recon — поиск релевантных задаче файлов (локально, без LLM)…
-
recon: релевантных файлов для правки по проекту frontend: 7
-
Recon построен за 80.87 сек, размер контекста ~110775 байт.
-
Ответ LLM получен за 107.6 сек, правок к файлам: 1.
-
Этап 3/3: применение правок к файлам…
Конвейер из ~1200 файлов фронтенда отобрал 7 релевантных и собрал ~110 КБ контекста вместо мегабайтов всего проекта.
Ответ агента (файл dev-report.md):
В компоненте ExampleModal.vue заменено всплывающее уведомление при недостаточной длине комментария на инлайн-ошибку: textarea подсвечивается красной рамкой, под ней выводится красный текст с тем же сообщением. Добавлены переменная showRejectError, метод handleRejectInput для сброса ошибки при вводе и автоувеличения textarea, а также соответствующие стили.
Изменённые файлы: src/components/ExampleModal.vue — ровно тот файл, о котором шла задача. Модель не «блуждала» по проекту: все нужные соседи и стили она увидела в собранном для неё контексте.
Бенчмарки
Тестирование я проводила на PHP 8.1 (Docker, SSD):
Первичная индексация
Размер проекта
Файлов
Токенов в farm_terms
Время
Размер таблицы
Небольшой (CRM-модуль)
~100
~15 000
0.2–0.5 сек
~1.2 МБ
Средний (веб-сервис)
~500
~75 000
1–2 сек
~6 МБ
Большой (монолит)
~1000
~150 000
2.5–5 сек
~12 МБ
⚡ Повторная индексация (инкрементальная)
Сценарий
100 файлов
500 файлов
1000 файлов
Без skip_dirs (vendor/ включён)
4–6 сек
20–40 сек
1–2.5 мин
С skip_dirs (vendor/ исключён)
0.05–0.15 сек
0.15–0.4 сек
0.25–0.75 сек
Изменился 1 файл из 500
< 0.05 сек
< 0.05 сек
< 0.05 сек
🔍 Поиск searchRelevant()
Строк в farm_terms
Терминов в запросе
Время SQL
Итоговое время
15 000
5–10
< 0.5 мс
< 2.5 мс
75 000
5–15
0.5–1.5 мс
1.5–5 мс
150 000
10–20
1.5–4 мс
2.5–10 мс
Мой локальный SQL-поиск выполняется в пределах 10 мс, что превосходит сетевые вызовы к внешним сервисам эмбеддингов.
Неидеальный мир: грабли и краевые случаи
-
Если БД прилегла: Предусмотрена мягкая деградация — если SerenaDB отвалилась, searchRelevant() просто вернет пустой массив, а агенты аккуратно подхватят стандартный слепок.
-
Кроссплатформенность путей: Разделители путей нормализуются к единому виду (прямой слэш
/) независимо от ОС.
Интеграция в конвейер ИИ-агента
Пример использования класса SemanticIndex на этапе Recon:
$semantic = new FarmFsSemanticIndex();if (!$semantic->enabled()) { return $fullSnapshot; // БД недоступна — работаем на полном слепке}// 1. Индексация проекта$indexResult = $semantic->indexProject($rootPath, [ 'skip_dirs' => ['vendor', 'node_modules', '.git', 'var/cache'], 'max_file_bytes' => 30000, // читаем первые 30 КБ каждого файла]);// 2. Семантический отбор релевантных файлов$relevant = $semantic->searchRelevant($rootPath, $query, 15);if ($relevant === []) { return $fullSnapshot;}// 3. Фильтрация контекста$relevantSet = array_flip($relevant);$keptFiles = [];foreach ($fullSnapshot['read_files'] as $f) { $absPath = $f['path'] ?? ''; $relPath = ltrim(substr($absPath, strlen($rootPath)), '/'); if (isset($relevantSet[$relPath]) || isset($relevantSet[$absPath])) { $keptFiles[] = $f; }}Направления для улучшения
Идеи, как сделать мой индекс ещё чуточку умнее:
Статус / Улучшение
Зачем и как работает
Сложность
Когда нужно / Контекст
Уже готово (v4): Извлечение символов (symbolTerms)
Определения классов/методов/интерфейсов извлекаются с префиксом sym: и повышенным весом (определения — ×3, вызовы — ×1)
Готово
Автомиграция схемы через INDEX_VERSION = ‘4’
В планах: Полноценный Snowball-стеммер
Замена базового суффиксного среза на полноценную морфологию русского языка
★★☆
Для сложных падежей и предложений в ТЗ
В планах: Справочник модулей (авто-онтология через LLM)
Одноразовая суммаризация модулей дешёвой моделью: 1–2 строки «за что отвечает» + ключевые термины. Затем двухступенчатый retrieval: справочник → ключевые слова → текущий лексический поиск. Снимает привязку к лексике проекта
★★★
Незнакомый проект или несогласованная лексика
В планах: Сниппеты в консоли
Вырезание подсвеченных фрагментов из сохраненной колонки content
★☆☆
Для отладки и визуализации отчетов
Когда подходит, а когда — нет
Подойдёт, если…
Не подойдёт, если…
Ищешь по именам классов, методов, доменным терминам
Нужен поиск ‘по смыслу’: ‘найди обработку сетевых ошибок’
База без pgvector и FTS (корпоративные реалии)
В проекте несогласованная лексика: одни пишут item, другие — contract
Нужна скорость без вызовов embedding-API
Синонимы и перефразирование критичны для точности
Важно объяснить, почему файл попал в топ (прозрачность)
Поиск по документации или комментариям на естественном языке
PHP/Python/Go/любой язык без ML-зависимостей
Кодовая база на языке без чётких идентификаторов (например, конфиги)
Офлайн-среда, корпоративный контур, нет доступа к embedding API
Нужна семантика, а не лексика: ‘как обрабатываются ошибки платежей’
Итоги
Иногда лучшее решение — это самое простое. Старый добрый частотный анализ и чёткие правила индексации для поиска по коду отрабатывают быстрее, стоят дешевле и дают куда более предсказуемый результат, чем тяжёлые векторные эмбеддинги. В общем, инструмент должен упрощать жизнь и беречь ресурсы, а не создавать новые проблемы там, где всё решается базовой логикой.
Источник: habr.com