
Правило разрешало подключаться к orders только одному клиенту. С ним всё работало, и ошибка осталась бы незаметной, если бы проверка закончилась на успешном запросе. Два посторонних Pod показали, что один дефис в YAML открывает доступ всем трём. На одноузловом стенде получилось 12 проб: без ограничения, с правильным правилом, с ошибкой и после возврата прежнего файла.
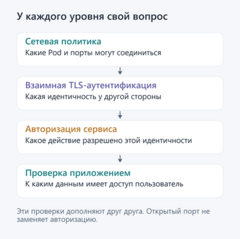
Условия примера: API в namespace shop читает заказы у orders в backend по TCP/8080. Само нахождение внутри кластера не должно давать соседним сервисам такой доступ. Политика orders‑from‑api ограничит соединения, orders‑mtls потребует mTLS, orders‑read‑from‑api разрешит чтение. А право конкретного пользователя на конкретный заказ проверит приложение. Эти проверки нельзя заменить одной сетевой границей.
На что действует NetworkPolicy
У NetworkPolicy есть неприятная особенность: объект может сохраниться в API, хотя фильтрация так и не начнётся. Её выполняет CNI, поэтому перед опытом нужна проверка поддержки политик. Подключения с hostNetwork требуют отдельной пробы: их обработка зависит от реализации. Все запросы ниже используют новые соединения.
Сначала стоит посмотреть, какие Pod попадут в выборку. Команды для сервера и клиента: kubectl ‑n backend get pods ‑l app=orders ‑show‑labels и kubectl ‑n shop get pods ‑l app=api ‑show‑labels. Если вывод пуст или содержит лишние Pod, нужно исправить имена либо метки. У namespace shop команда kubectl get namespace shop ‑show‑labels должна показать kubernetes.io/metadata.name=shop. После этой проверки можно ограничить входящий TCP/8080 к orders:
apiVersion: networking.k8s.io/v1 kind: NetworkPolicy
metadata:
name: orders-from-api
namespace: backend
spec:
podSelector:
matchLabels: {app: orders}
policyTypes: [Ingress]
ingress:
 - from:
 - namespaceSelector:
 matchLabels:
kubernetes.io/metadata.name: shop
podSelector:
matchLabels: {app: api}
ports:
- {protocol: TCP, port: 8080}
Внутри одного элемента from условия namespaceSelector и podSelector должны выполняться вместе: shop и app=api. Дефис перед podSelector создаёт второй элемент. Теперь достаточно любого условия: либо любого Pod из shop, либо app=api из backend. Последнее ограничение неочевидно: без namespaceSelector селектор Pod действует в namespace самой политики. Проверить сохранённый объект позволяет kubectl ‑n backend describe networkpolicy orders‑from‑api.
API из shop проходит в обоих вариантах. Ошибку обнаружат только посторонние клиенты: Pod с другой меткой из shop и app=api из backend. У каждого не совпадает одно из необходимых условий.
Ошибочный участок выглядит так. Это только фрагмент ingress: добавленный дефис превращает podSelector в самостоятельное разрешение.
- from:
- namespaceSelector:
matchLabels:
kubernetes.io/metadata.name: shop
- podSelector:
matchLabels: {app: api}
Для проверки использован одноузловой K3s v1.36.5+k3s1 на Alpine 3.24.2, четыре vCPU и 4 ГБ памяти. Фильтрацию выполнял встроенный сетевой контроллер K3s. Учебный orders с BusyBox:1.37.0 возвращал lab‑ok через httpd по адресу /orders/123 на порту 8080. IP 10.42.0.3 оставался прежним. С трёх клиентов через kubectl exec запускался wget с таймаутом 3 секунды. В таблице 0 означает полученный lab‑ok, 1 — ошибку. Оба прогона с одним элементом from дали посторонним клиентам Connection refused.
Возврат прежнего файла снова закрыл доступ посторонним Pod. При этом curl с ноды, где работал orders, получил HTTP 200: стандартная NetworkPolicy не блокирует такой трафик. Политика ограничивает ingress только выбранных orders. Остальные Pod, egress и шифрование остаются за её пределами. Если у API уже ограничен egress, исходящее соединение к orders тоже нужно разрешить.
Существующие разрешения тоже считаются
Посторонний клиент может пройти и с правильным from. Тогда нужен вывод kubectl ‑n backend get networkpolicy ‑o yaml: какие ещё объекты выбирают orders своим podSelector? Если среди них есть allow‑all, он продолжает действовать. Разрешения складываются; узкое правило не отменяет широкое независимо от порядка файлов. Ревью одного diff этого не обнаружит.
Отдельно нужен фактический маршрут DNS. Правило с меткой CoreDNS из чужого примера может оказаться бесполезным, если клиент использует NodeLocal DNSCache, и оставить приложение без разрешения имён. Следом проверяются адреса и порты proxy, webhook и внешних API. Для каждого допуска в списке должна находиться зависимость, ради которой он появился.
Отказ постороннему и успех нужного клиента проверяются отдельно. Один результат не показывает другой.
mTLS и разрешение на чтение
Сеть теперь ограничена, но разрешённый клиент по‑прежнему может послать на TCP/8080 как GET /orders/123, так и POST /orders/123. NetworkPolicy не читает HTTP‑метод. В этом примере чтение от изменения отделит Istio: он подтвердит идентичность workload и проверит разрешённое действие.
PeerAuthentication orders‑mtls в режиме STRICT требует mTLS у выбранного orders. До её применения нужные клиенты должны быть подготовлены к работе через mesh. Сам объект не включает сервисы в mesh; преждевременный STRICT оборвёт и нужные соединения.
AuthorizationPolicy использует principal cluster.local/ns/shop/sa/orders‑api: домен доверия, namespace и ServiceAccount. mTLS подтверждает эту идентичность стороны соединения. Дальше HTTP‑правило ограничивает метод и путь, если механизм применения видит HTTP. Principal ничего не сообщает о правах человека на заказ, поэтому проверка в приложении остаётся обязательной.
Здесь у обоих сервисов sidecar; backend не является root namespace mesh. API работает в shop с ServiceAccount orders‑api и trust domain cluster.local, orders обслуживает HTTP на 8080. Метку app=api недостаточно увидеть: spec.serviceAccountName нужно проверить в выводе kubectl ‑n shop get pods ‑l app=api ‑o yaml. Условные имена и /orders/* заменяются своими до применения.
После применения пригодится CLI совместимой версии: istioctl analyze ‑n backend и istioctl analyze ‑n shop. Они проверяют настройки. Для проверки mTLS и разрешений нужны реальные запросы.
apiVersion: security.istio.io/v1 kind: PeerAuthentication
metadata:
name: orders-mtls
namespace: backend
spec:
selector:
matchLabels: {app: orders}
mtls:
mode: STRICT
После orders‑mtls добавляется разрешение на чтение orders‑read‑from‑api:
apiVersion: security.istio.io/v1 kind: AuthorizationPolicy
metadata:
name: orders-read-from-api
namespace: backend
spec:
selector:
matchLabels:
app: orders
action: ALLOW
rules:
- from:
- source:
principals:
- cluster.local/ns/shop/sa/orders-api
to:
- operation:
ports:
- '8080'
methods:
- GET
paths:
- /orders/*
При отсутствии других влияющих правил этот ALLOW пропускает нужному principal GET /orders/123, но не POST. Другой ALLOW способен расширить допуск; DENY и CUSTOM тоже участвуют в решении. У /orders отдельная проверка: путь без конечного слеша не совпадает с /orders/*. Readiness и ночная выгрузка требуют собственных запросов.
Проверка Istio состоялась 23 октября на отдельной копии стенда: K3s v1.36.5+k3s1, Istio 1.31.3 minimal, Alpine 3.24.2, 4 vCPU и 6 ГБ RAM. Приложение на Python отвечало 200 на GET и POST. У всех клиентов app=api: сетевой селектор должен пропускать их, иначе отказ CNI скроет результат проверки mTLS. У api были orders‑api и sidecar, у other — default и sidecar, у plain — orders‑api без sidecar.
Каждая серия состоит из пяти новых запросов. A: api, GET /orders/123. B: api, POST /orders/123. C: other, GET /orders/123. D: plain, GET /orders/123. E: api, GET /orders. Числа в таблице обозначают HTTP‑статусы; reset — завершение wget с кодом 1 и Connection reset by peer, без HTTP‑ответа.
Кто может запустить Pod от имени клиента
Остаётся проверить, кто вообще может запустить Pod с orders‑api. Под учётными данными оператора выполняются kubectl auth can‑i create pods ‑n shop и kubectl auth can‑i patch pods ‑n shop. Первое разрешение требует проверить выбор ServiceAccount, второе — изменение меток. Ответ yes ещё не гарантирует создание Pod: admission может его отклонить. Но если Pod с чужой ServiceAccount принят, оператор получает доступ к её полномочиям. Этот риск описан в рекомендациях Kubernetes по RBAC. Нужны ограничения параметров Pod и меток наряду с проверкой ролей.
Опыт с учётными записями выполнен на копии одноузлового K3s v1.36.5+k3s1 с Istio 1.31.3, 4 vCPU и 6 ГБ RAM. Role для pod‑maker95 разрешала только create/get pods в shop. Администратор делал запросы через ‑as с именем этой записи и обычными группами ServiceAccount. Такая проверка охватывает RBAC и admission, но не аутентификацию настоящего пользователя. API принял оба определения Pod.
Первый Pod, rbac95-own, использовал pod‑maker95. Второй, rbac95-delegated, получил orders‑api. У обоих app=api и sidecar; каждый при запуске сам отправил три GET /orders/123. Администратор прочитал логи, exec для отправки запросов не использовался. API‑токен приложению не монтировался: automountServiceAccountToken=false. Проверки can‑i подтвердили запреты на чтение Secrets и ServiceAccount, patch Pod, exec и логи. Для подресурсов использовался ‑subresource; запись pods/exec проверяет другое.
Pod ServiceAccount GET /orders/123
 rbac95-own pod-maker95 403, 403, 403
 rbac95-delegated orders-api 200, 200, 200
Envoy подтвердил результат: в istio_requests_total с connection_security_policy=«mutual_tls» есть три 403 для pod‑maker95 и три 200 для orders‑api. Сетевой фильтр и HTTP‑правило отработали согласно настройке: orders узнал разрешённую идентичность. Слабое место находилось при создании Pod, где разрешался выбор spec.serviceAccountName. В другом кластере admission может отклонить такой манифест. Отключённый API‑токен приложения сам по себе не лишает sidecar его идентичности.
Сначала список клиентов, потом YAML
Для переноса опыта на рабочий кластер сначала нужен список связей. Первая строка здесь: shop → backend, TCP/8080; у orders метка app=orders, у клиента app=api. Метки относятся к NetworkPolicy, а orders‑api будет идентичностью клиента при проверке mTLS в Istio. Ночная выгрузка на тот же порт с другой учётной записью займёт отдельную строку: запись «внутренние сервисы» не объясняет, кому и зачем нужен доступ.
Дневной лог не покажет выгрузку, которая ещё не запускалась. Её расписание и конфигурация приложения дополняют наблюдения; метрики и readiness‑пробы получают собственные записи. Владелец orders подтверждает список. Иначе в разрешения попадут случайные запросы и забытые связи, которые удалось увидеть в трафике.
Orders подходит для пилота, если у него есть владелец, а у изменения предусмотрен откат. Проверка должна воспроизвести и нужное соединение, и отказ постороннему. Только после этого имеет смысл расширять пилот на соседние сервисы.
Приёмка на новых соединениях
Перед пилотом сохраняются прежние манифесты и diff. У kubectl diff ‑f orders‑from‑api.yaml код 0 означает отсутствие различий, 1 — наличие изменений, больше 1 — ошибку. В план приёмки входят api из shop, api из backend и Pod с другой меткой из shop. Только первому положен доступ; остальные проверяют два разных условия from. У mesh свой набор запросов с разрешённой и посторонней идентичностями.
Используются новые соединения. Для уже открытого TCP‑сеанса поведение после изменения orders‑from‑api зависит от CNI. Дальше нужны перезапуск Pod, перенос на другую ноду, штатный rollout и фоновые задачи. Откат проверяется отдельным прогоном, а доступ для возврата прежних политик должен сохраняться.
Клиентские ответы сверяются с доступной телеметрией CNI или mesh. Требуются и успех разрешённого клиента, и отказ постороннему; обязательного журнала блокировок стандартная NetworkPolicy не предоставляет. Один таймаут не устанавливает причину отказа. Приложение могло перестать отвечать независимо от фильтрации.
На стенде похожий таймаут возник ещё до создания политик: K3s не получал ответ с 127.0.0.1:6443/cacerts. У VM был выключен lo, маршрут к 127.0.0.1 шёл через eth0. Восстановление loopback вернуло узел в Ready. Политики к этой неисправности отношения не имели.
Пропавшая после пилота ночная выгрузка возвращает к списку зависимостей orders. Если нужный клиент пропущен, ему требуется обоснованный допуск. Открытие всего namespace восстановит связь ценой доступа остальных Pod. Поэтому вместе сохраняются манифесты, проверенные соединения и причины разрешений. Для следующего сервиса список клиентов составляется заново.
Источник: habr.com