
Мы делаем сайт с набором небольших браузерных инструментов. Два из них, хэш-калькулятор и генератор паролей, работают целиком на клиенте: введённая строка никуда не отправляется, и это можно проверить на вкладке Network. Расскажу, как они устроены, какие решения оказались неочевидными и как мы нашли у себя ошибку в собственной оценке надёжности.
Статья без громких обещаний. В ней много кода, несколько цифр и одна неловкая находка.
Часть 1. Хэши
Что даёт Web Crypto и чего не даёт
Первая мысль: зачем писать хэши руками, если в браузере есть crypto.subtle.digest? Потому что он умеет мало. Из семейств, которые нужны инструменту, он считает только четыре алгоритма: SHA-1, SHA-256, SHA-384 и SHA-512. MD5 в нём нет, SHA-224 тоже, про CRC32, SHA-3 и BLAKE2 говорить не приходится. Ещё два ограничения:
-
API асинхронный и возвращает
Promise, а значит, весь код вокруг приходится делать с учётом асинхронности; -
у него нет потокового режима:
digest()принимает весь буфер целиком. Для больших файлов это важно, об этом ниже.
И ещё одно, о чём часто забывают: crypto.subtle доступен только в защищённом контексте, то есть по HTTPS или на localhost. Если открыть страницу по обычному http://, объект окажется undefined.
В нашем калькуляторе обёртка над Web Crypto выглядит так:
function webCryptoHex(algo) { return function (bytes) { return crypto.subtle.digest(algo, bytes).then(function (buf) { return bytesToHex(new Uint8Array(buf)); }); };}Строку в байты переводим через TextEncoder: он всегда кодирует в UTF-8, и это же делает подавляющее большинство других инструментов. Иначе хэш от русской строки у вас и у sha256sum в терминале будет разный, и пользователь решит, что калькулятор врёт.
MD5 на чистом JS
MD5 в Web Crypto нет специально: алгоритм считается небезопасным. Но пользователям он нужен, потому что им до сих пор подписывают файлы и сверяют загрузки. Пишем сами. Ядро короткое:
function md5Hex(bytes) { var padded = mdPadLE(bytes); var a0 = 0x67452301, b0 = 0xefcdab89, c0 = 0x98badcfe, d0 = 0x10325476; var M = new Int32Array(16); for (var chunk = 0; chunk < padded.length; chunk += 64) { for (var i = 0; i < 16; i++) { M[i] = padded[chunk + i*4] | (padded[chunk + i*4 + 1] << 8) | (padded[chunk + i*4 + 2] << 16) | (padded[chunk + i*4 + 3] << 24); } var A = a0, B = b0, C = c0, D = d0; for (i = 0; i < 64; i++) { var F, g; if (i < 16) { F = (B & C) | (~B & D); g = i; } else if (i < 32) { F = (D & B) | (~D & C); g = (5*i + 1) % 16; } else if (i < 48) { F = B ^ C ^ D; g = (3*i + 5) % 16; } else { F = C ^ (B | ~D); g = (7*i) % 16; } F = (F + A + MD5_K[i] + M[g]) | 0; A = D; D = C; C = B; B = (B + rotl32(F, MD5_S[i])) | 0; } a0 = (a0 + A) | 0; b0 = (b0 + B) | 0; c0 = (c0 + C) | 0; d0 = (d0 + D) | 0; } return bytesToHex(le32Words([a0, b0, c0, d0]));}Три места, где легко ошибиться:
-
Порядок байтов. MD5 читает слова и записывает длину сообщения в порядке «младший байт первым» (little-endian), а SHA-семейство в порядке «старший первым» (big-endian). Если скопировать дополнение (padding) от SHA, хэш получится правильной длины, но неверным.
-
Целые со знаком. В JS побитовые операции работают с 32-битными знаковыми целыми. Поэтому после каждого сложения стоит
| 0, а для сравнения и вывода слова приходится приводить через>>> 0. -
Проверка. Единственная надёжная защита — известные тестовые векторы. Хэш пустой строки у MD5:
d41d8cd98f00b204e9800998ecf8427e, словаhello:5d41402abc4b2a76b9719d911017c592. А у SHA-256 для пустой строки началоe3b0c44298fc1c14. Если эти строки не совпали, дальше смотреть бессмысленно.
Пример наглядно показывает «лавинный эффект»: hello и Hello дают 5d41402a… и 8b1a9953…, у них нет ничего общего, хотя отличается одна буква.
64-битные алгоритмы и BigInt
SHA-512 в браузере умеет сам, но нам нужны её производные (SHA-512/256), а также SHA-3, BLAKE2b и xxHash64. Им нужна 64-битная арифметика, а у JS нет нативных 64-битных целых. Можно эмулировать парой 32-битных слов, но в сдвигах и переносах очень легко ошибиться. Мы выбрали BigInt:
var MASK64 = (1n << 64n) - 1n;function rotl64(x, n) { n = BigInt(n % 64); if (n === 0n) return x; return ((x <> (64n - n))) & MASK64;}Это медленнее. Но для коротких строк, ради которых инструмент и сделан, разница не заметна, зато риск ошибки транскрипции гораздо ниже. Если бы мы считали хэши больших файлов, подход был бы другим: WebAssembly и потоковая обработка кусками, ведь Web Crypto, как сказано выше, потоково не умеет.
Гонки при живом пересчёте
Калькулятор пересчитывает хэш на каждое нажатие клавиши, без кнопки. Пока считаются синхронные алгоритмы, проблем нет. Но SHA-1/256/384/512 идут через Promise, и при быстром наборе несколько запусков могут завершиться не в том порядке, в котором стартовали. Результат: на экране хэш от предыдущей версии строки. Мы лечим это «токеном запуска»:
var runToken = 0;function runNow() { var str = els.input.value; var myToken = ++runToken; HashCalculator.compute(id, str).then(function (text) { if (myToken !== runToken) return; // устаревший ответ, выбрасываем els.result.value = text; });}els.input.addEventListener('input', function () { clearTimeout(timer); timer = setTimeout(runNow, 150); // небольшой debounce});Приём простой, но без него баг проявляется редко и неприятно: хэш «не обновился», хотя вы уверены, что ввели строку правильно.
Коротко об истории: почему MD5 нельзя использовать для защиты
Это пригодится, когда пользователь спросит, зачем в калькуляторе пометка «устарел».
-
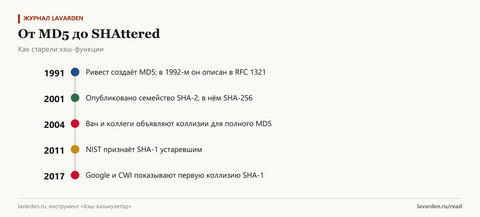
1991. Рональд Ривест создаёт MD5 взамен более слабого MD4. В 1992 году он описан в RFC 1321.
-
1993 и 1996. Находят слабые места во внутренней функции сжатия.
-
2001. Публикуется семейство SHA-2, в нём SHA-256.
-
2004. Сяоюнь Ван с коллегами объявляет о коллизиях для полного MD5: умении находить два разных сообщения с одинаковым хэшем.
-
2011. NIST признаёт SHA-1 устаревшим.
-
23 февраля 2017. Google и нидерландский институт CWI показывают первую практическую коллизию SHA-1 (атака SHAttered): два разных PDF-файла с одинаковым хэшем. По их оценке, понадобилось около 9 квинтильонов вычислений SHA-1: порядка 6500 лет работы процессоров и 110 лет работы видеокарт.
 От MD5 до SHAttered: как старели хэш-функции
Вывод для практики: MD5 и SHA-1 годятся для проверки «файл не побился при скачивании», но не для защиты от злоумышленника. Для целостности и подписей берут SHA-256 и старше. А для хранения паролей не подходит ни один быстрый хэш: нужны специальные медленные алгоритмы (bcrypt, scrypt, Argon2), потому что перебор быстрого хэша на видеокарте слишком дёшев.
Часть 2. Пароли
Случайность: getRandomValues и отбраковка
Единственный правильный источник случайности для пароля в браузере — crypto.getRandomValues. Math.random() для этого не годится: он не рассчитан на криптографическую стойкость. Но даже с хорошим источником есть тонкость, о которой часто забывают.
Допустим, нужно выбрать случайный символ из набора в n знаков. Первая мысль: random32 % n. Но число значений 2³² не делится нацело на n, поэтому первые символы набора выпадают чуть чаще остальных. Это «смещение по модулю». Для 32-битного числа и набора из 95 символов оно ничтожно, порядка миллиардных долей, но исправить его ничего не стоит. Нужна отбраковка (rejection sampling): отбрасываем «хвост», который не помещается в целое число полных кругов:
function randU32() { var buf = new Uint32Array(1); window.crypto.getRandomValues(buf); return buf[0];}// равномерный выбор 0..n-1 без смещенияfunction randBelow(n) { if (n = limit); return v % n;}Бесконечного цикла бояться не нужно: в худшем случае отбраковывается меньше половины значений, и ожидаемое число итераций близко к единице.
Энтропия: что считает инструмент
Надёжность случайного пароля измеряют энтропией в битах. Для пароля из L знаков, выбранных равновероятно из набора в N символов, это L · log₂(N). Для кодовой фразы из k слов, выбранных из списка в W слов, это k · log₂(W). В коде так и написано:
function entropyBits(value, isPhrase) { if (isPhrase) { return parseInt(WORDS_N.value, 10) * Math.log2(wordList().length); } return value.length * Math.log2(pool().length || 1);}function strength(bits) { if (bits < 40) return { label: 'слабый' }; if (bits < 60) return { label: 'средний' }; return { label: 'сильный' };}Время подбора мы оцениваем двумя числами: для онлайн-атаки по 1000 попыток в секунду и для офлайн-перебора украденной базы по 10 миллиардов в секунду. Оценка грубая и консервативная: она берёт полное пространство вариантов, а в среднем перебирать придётся вдвое меньше. Эти допущения стоит показывать пользователю, иначе цифры выглядят точнее, чем они есть.
Несколько ориентиров для случайных паролей:
Пароль
Энтропия
4 случайные цифры (PIN)
≈ 13 бит
8 случайных знаков, буквы и цифры (62)
≈ 48 бит
4 случайных слова из списка в 7776 слов
≈ 52 бита
12 случайных знаков из 95 печатных
≈ 79 бит
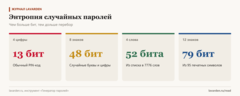 Энтропия случайных паролей
Ключевое слово: случайных. Пароль Мойпароль2024! выглядит сложным, но выбран человеком по шаблону, и формула к нему неприменима: его реальная энтропия намного ниже.
Правила, которые отменили
Долгое время «хороший пароль» означал: смесь больших и маленьких букв, цифр и спецсимволов, плюс обязательная смена каждые 90 дней. Эти требования в 2003 году закрепил в рекомендациях NIST сотрудник института Билл Бёрр. В 2017 году он в интервью The Wall Street Journal признал, что многое из сделанного теперь осуждает.
В том же 2017 году NIST выпустил новую редакцию (SP 800-63B), и она практически разворачивает прежний подход:
-
не навязывать правила состава пароля («обязательно цифра и символ»);
-
не требовать смены по расписанию;
-
требовать не короче 8 знаков, при этом рекомендуется требовать больше (если пароль единственный фактор, называют 15 знаков);
-
принимать пароли длиной не меньше 64 знаков, чтобы работали длинные фразы;
-
проверять пароли по спискам уже утёкших и самых распространённых.
То есть ставка на длину и непредсказуемость. С точки зрения разработчика формы регистрации это конкретные тесты: ваша форма отвергает пробелы? режет длину на 16 знаков? запрещает вставку из менеджера паролей? Всё это шаг назад.
Что мы нашли у себя и исправили
Когда мы сверяли цифры для этой статьи, выяснилось неприятное. Режим «кодовая фраза» берёт слова из списка, и мы считали, что получается примерно как у дайсвера (список 7776 слов, около 12,9 бита на слово). Но в нашем русском списке было всего 414 записей, из них 405 уникальных, то есть примерно 8,7 бита на слово. Четыре слова из такого списка дают около 35 бит. По собственной шкале инструмента это «слабый» пароль, и он действительно подбирается быстро при офлайн-переборе.
Что мы сделали:
-
русский список расширили до 2072 слов, все уникальные (одно существительное в именительном падеже), это около 11 бит на слово;
-
английский заменили на EFF Large Wordlist (7772 слова, около 12,9 бита; список Electronic Frontier Foundation распространяется под лицензией CC BY 3.0 US);
-
по умолчанию теперь предлагается 6 слов: это примерно 66 бит для русского списка и 77 для английского, то есть «сильный» по шкале инструмента. Четыре русских слова дают около 44 бит, это «средний».
Выводы:
-
Формула
k · log₂(W)честна только тогда, когда слова выбираются равновероятно и независимо из списка известного размера. Размер списка нужно знать и считать по уникальным словам: дубли тихо ломают расчёт. Мы проверили это скриптом: размер и число уникальных слов совпадают. -
Для фраз из небольшого списка надо либо брать больше слов (хотя бы шесть-семь), либо расширять список. Нормальный ориентир: 2048 слов (11 бит на слово) и выше.
-
Хорошо бы показывать пользователю не только общий «балл», но и источник цифры: «список из 2072 слов». Сейчас размер списков указан в справке на странице инструмента, а не рядом с оценкой, и это следующий шаг.
Нашли мы это только потому, что сели посчитать вручную, прежде чем писать статью.
Что в итоге
-
Web Crypto закрывает SHA-1/256/384/512, но не MD5, не SHA-224 и не SHA-3, асинхронный и без потоковой обработки; только HTTPS.
-
Остальное можно написать на чистом JS, но проверять нужно по тестовым векторам; для 64-битных слов проще
BigInt, если скорость на коротких строках не важна. -
Живой пересчёт с
Promiseтребует токена запуска, иначе на экране окажется устаревший результат. -
Случайность: только
crypto.getRandomValues, выбор с отбраковкой, чтобы не было смещения. -
Энтропия считается честно, только если выбор действительно случайный; размер списка слов надо проверять, а не предполагать.
-
Правила паролей давно сдвинулись от «сложных» к «длинным», и формы на сайтах пора подтягивать.
Оба инструмента работают в браузере и ничего не отправляют на сервер:
-
хэш-калькулятор: https://lavarden.ru/tools/hash-calculator
-
генератор паролей: https://lavarden.ru/tools/generator-paroley
Если найдёте ошибку в реализации или в рассуждениях, напишите в комментариях, мы поправим.
Источник: habr.com