
Qwen3.5-0.8B — модель с 752 млн параметров, 18 рекуррентными слоями GatedDeltaNet и 6 слоями внимания. В проверенных прогонах с весами BF16 она часто не завершает размышление до лимита в 32 768 новых токенов. В работе MIT CSAIL Sparks of Weight-Space Programming (Takehi et al., 2026) правка весов без дообучения MIT-p50c повышает точность на MATH-500 с 7.9% до 48.1% — в среднем по четырём прогонам vLLM с настройками из карточки модели: температурой 0.6 и штрафом 1.5 за уже использованные токены. Базовая модель в этом эталоне достигает предела длины в 93.0% генераций. Сохраняется ли сокращение зацикливания без случайного выбора токенов и штрафа за повторы? Какие различия в геометрии весов сопровождают изменение поведения?
В исследовании сопоставлены геометрия и поведение MIT-p50c и SGNE-CC (Spherical Gated Norm-preserving Edit, Column-Constrained — сферической весовой поправки с сохранением норм и рекуррентными воротами объёмом 3.13 МиБ), полученной без дообучения поворотами выходных столбцов с сохранением их исходной длины. Этот способ назван ДНК-редактированием весов.
1. Геометрия весовых правок: MIT-p50c против SGNE-CC
В каждой из двух изменённых выходных матриц полносвязных блоков MIT-p50c — слои с индексами 15 и 19, всего 128 столбцов — на первую сингулярную моду приходится свыше 99.999% энергии приращения. Нормы отдельных столбцов увеличены на величину до 114.3%. Все 18 рекуррентных слоёв GatedDeltaNet, составляющие 75% глубины сети, остались нетронутыми.
SGNE-CC изменяет направления 802 выходных столбцов в 15 полносвязных слоях и 1 182 столбцов в 9 рекуррентных слоях. Слои внимания не изменены; дополнительно изменена одна строка ворот затухания в слое с индексом 16. Максимальное отклонение нормы изменённого столбца после округления BF16 — около 0.16%, медианный угол поворота — 8.8°. В матрицах слоёв 15 и 19 на первую сингулярную моду приходится соответственно 67.6% и 73.4% энергии приращения. Нумерация слоёв начинается с нуля. Архитектура, токенизатор и программа исполнения модели остаются прежними.
2. Математические тесты при лимите генерации 32 768 токенов (MATH-500)
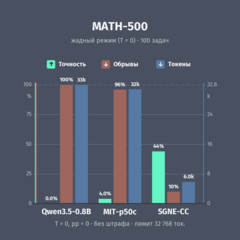 MATH-500 — жадный режим
Рис. 1. При нулевой температуре и без штрафа повторов SGNE-CC чаще завершает генерацию, чем MIT-p50c. Стратифицированная выборка из 100 задач семи разделов MATH-500; A100, BF16. Строгий зачёт требует завершения генерации и верного результата в итоговой рамке.
При строгом зачёте базовая модель не решает ни одной задачи из 100, MIT-p50c решает 4, а SGNE-CC — 44 (парный критерий МакНемара, p < 0.0001). Средняя длина ответов SGNE-CC и MIT-p50c составляет 6.0 тыс. и 31.6 тыс. токенов, доля достижения лимита — 10% и 96%. У MIT-p50c в 96 задачах из ста размышление остаётся незавершённым; у SGNE-CC таких случаев 4.
В задаче о переводе декартовых координат в полярные MIT-p50c рано получает правильный результат, но затем 451 раз повторяет абзац проверки до лимита генерации. SGNE-CC выдаёт итоговый ответ и останавливается на 2 394 токенах. При резервном извлечении ответа из незавершённых рассуждений по правилу MIT преимущество SGNE-CC сохраняется: 45 из 100 против 20 из 100, у базы — 7 (p < 0.0001). Основное правило MIT, не требующее окончания генерации, даёт соответственно 44, 5 и 1.
По протоколу автора, после заморозки весов из 300 задач вне калибровочного набора отобраны 49 задач для отдельной проверки. При нулевой температуре SGNE-CC решает 24 из 49, база — ни одной (p < 0.0001).
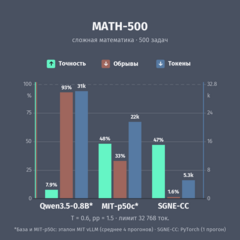 MATH-500 — полный прогон
Рис. 2. В режиме карточки модели SGNE-CC генерирует вчетверо короче внешнего эталона MIT-p50c, тогда как сравнение точности зависит от движка. Столбики базовой модели и MIT-p50c на графике показывают среднее четырёх запусков vLLM из репозитория MIT; SGNE-CC — один прогон генератора на PyTorch.
Режим карточки модели меняет результат MIT-p50c на той же сотне задач с 4 до 45, а суммарный счёт SGNE-CC остаётся прежним — 44 из 100. В прямом прогоне на PyTorch по всем 500 задачам база решает 39 (7.8%), MIT-p50c — 259 (51.8%), SGNE-CC — 235 (47.0%); номинальное p = 0.048. Средняя длина у SGNE-CC в 4.0 раза меньше: 5.3 тыс. против 21.1 тыс. токенов. Лимит генерации достигается в 17.6 раза реже: 1.6% против 28.2%.
При сравнении с первым внешним запуском MIT в vLLM — 241 из 500, или 48.2% — статистически значимого различия с SGNE-CC не выявлено (p = 0.67). Это не устанавливает эквивалентности моделей. Относительно среднего четырёх прогонов vLLM ответы SGNE-CC короче в 4.1 раза, а достижения лимита реже в 20.7 раза.
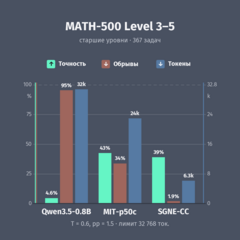 MATH-500 — старшие уровни
Рис. 3. На задачах уровней трудности 3–5 SGNE-CC значительно реже достигает лимита генерации; больше задач решает MIT-p50c. Прямой прогон 367 задач MATH-500 в режиме карточки модели.
На уровнях трудности 3–5 лимита в 32 768 токенов достигают 124 ответа MIT-p50c из 367 (33.8%) и 7 ответов SGNE-CC (1.9%) — разница в 17.7 раза. Средняя длина у SGNE-CC в 3.7 раза меньше: 6.3 тыс. против 23.5 тыс. токенов. Правильных ответов 143 (39.0%) против 156 (42.5%) у MIT-p50c, p = 0.24; база решает 17 из 367 (4.6%). В элементарной и школьной алгебре выше результат MIT-p50c: 96 из 142 против 77 из 142 у SGNE-CC. По сумме четырёх разделов — углублённой алгебры, начал анализа, геометрии и комбинаторики с теорией вероятностей — счёт обратный: 37 из 178 у MIT-p50c против 46 из 178 у SGNE-CC.
3. Перенос на другие задачи и границы метода
По протоколу исследования обе правки подбирались на математических задачах. Таблица показывает их перенос на другие области. Значения p относятся к сравнению доли зачтённых ответов SGNE-CC и MIT-p50c.
Тестовый набор (лимит 32 768 токенов)
Qwen3.5-0.8B
MIT-p50c
SGNE-CC
Длина и обрывы (SGNE к MIT)
Текстовая арифметика MGSM-240 (6 языков, карточка)
62/240 (25.8%)
137/240 (57.1%)
100/240 (41.7%)
В 2.8 раза короче (3.1 против 8.6 тыс.), p < 0.0001 (40 блоков)
Символическая логика BBH-160 (карточка)
3/160 (1.9%)
81/160 (50.6%)
66/160 (41.3%)
В 6.9 раза короче (2.4 против 16.9 тыс.), обрывы 1 против 23, p = 0.058
Код на Python HumanEval-164 (карточка, архивный прогон тестов)
26/164 (15.9%)
51/164 (31.1%)
46/164 (28.0%)
Размышление в 14.1 раза короче (449 против 6 334 ток.), обрывы 0% против 13.4%, p = 0.47
Тексты на 8 языках MultiSpeech-64 (нулевая температура, автофильтр)
2/64 (3.1%)
17/64 (26.6%)
23/64 (35.9%)
Незакрытое размышление: 5 против 22, медиана 2 235 против 32 768 ток., p = 0.21
На MGSM-240 более короткая генерация SGNE-CC сопровождается значимой потерей точности относительно MIT-p50c: 100 правильных ответов против 137, с учётом объединения переводов в 40 задач. В логике и написании кода обе правки дают больше правильных ответов, чем база; SGNE-CC при этом генерирует короче MIT-p50c и редко достигает лимита. В многоязычной генерации автоматический фильтр проверяет завершение ответа и пороги повторов, но не достоверность содержания. В режиме карточки у обеих правок встречаются единичные иероглифические вставки; у SGNE-CC сохраняются повторы на немецком языке — 4 случая из 8.
Сохранение норм столбцов проверено на весах. Для отделения его причинного вклада от ранга поправки, набора слоёв и строки ворот в слое с индексом 16 нужны отдельные опыты. На каждую задачу опубликован один прямой прогон; привязка отдельных файлов к ускорителям в журналах не сохранена. Разбиение MATH-500 на 200 калибровочных и 300 нетронутых задач приведено в манифесте. Значения p номинальные, без поправки на множественные сравнения. Поиск углов поворота не публикуется. Файл весовой поправки (sgne_cc_dna_delta.npz, 3.13 МиБ), все 26 файлов трасс (37 сумм SHA-256) и программы проверки на процессоре открыты:
python3 apply_dna_patch.py --verify-onlypython3 scripts/verify_paper_metrics.pyПримечание: работа выполнена в сотрудничестве с ИИ — как в самом исследовании, так и в подготовке кода, графиков и текста. Полную ответственность за выводы несёт автор, а все числа и замеры проверяются локально по открытой поправке, 26 трассам и скриптам на процессоре.
Статья, трассы и проверки (GitHub) · Архив DOI (Zenodo) · Весовая поправка SGNE-CC (Hugging Face)
Код, весовая поправка и текст автора открыты под лицензией Apache-2.0; сторонние данные, код и журналы сохраняют исходные лицензии.
Источник: habr.com