
Что произойдет, если разрешить узлам использовать swap на быстрых локальных NVMe SSD? Авторы с kubernetes.io провели эксперимент сразу в трех группах нагрузок — сборке ядра Linux, браузерных песочницах и изолированных Python-сессиях. Как это помогло втрое увеличить плотность размещения Python-песочниц на одном узле — в переводе. Плюс несколько моих комментариев.
Проблема плотности размещения на узлах
Объем памяти на узлах ограничен, а нагрузкам с ИИ-агентами ее нужно все больше. При этом они потребляют ресурсы неравномерно: периоды активности сменяются простоем.
Администратору приходится выбирать: завысить лимит памяти и платить за простаивающую RAM или занизить его и рисковать завершением процесса из-за нехватки памяти — Out-Of-Memory (OOM).
Особенно заметна эта проблема у автономных ИИ-агентов в защищенных средах выполнения, например на базе agent-sandbox. Таким подам нужно много памяти для запуска и выполнения недоверенного кода. После всплеска активности они обычно надолго замирают в ожидании запроса пользователя. Их состояние остается в RAM, ограничивает число подов на узле и повышает стоимость ИИ-инфраструктуры.
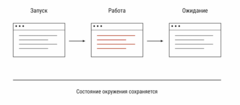 Типовой жизненный цикл песочницы
Решение: swap на узлах Kubernetes
Swap на узлах Kubernetes помогает справиться с этой проблемой. Ядро Linux может вытеснять анонимную память на диск. Появляется запас на случай скачка трафика или ситуации, когда приложениям нужно значительно больше памяти, чем есть на узле. Поддержка работы узлов со swap стала общедоступной в Kubernetes 1.34.
Раньше swap в Kubernetes не рекомендовали по двум причинам. Первая — учет памяти. В cgroup v1 для RAM и swap действовал общий лимит: отдельно ограничить дисковый swap было нельзя. Процесс мог вытеснить на диск много анонимной памяти, а его реальное потребление становилось трудно предсказать и изолировать. Kubernetes решает эту проблему с помощью cgroup v2, где swap учитывается отдельно.
Вторая причина — задержки при чтении страниц с медленных жестких дисков. Быстрые локальные NVMe SSD в значительной степени снимают эту проблему. Вместе эти изменения позволяют размещать больше подов и переживать всплески потребления памяти, сохраняя стабильность кластера.
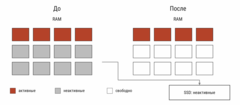 Принцип вытеснения неактивных страниц на SSD
Результаты тестирования
Мы проверили, как swap на локальных SSD влияет на производительность и расходы, в трех сценариях: сборке для CI/CD, одновременной работе множества браузерных песочниц и изолированных Python-песочниц.
Нагрузка
Без swap
Swap на Local SSD
Изменение
Сборка Linux 6.1.1
Лимит RAM 600 MB
Лимит RAM 300 MB
Лимит ниже на 50%
Chromium, Kata
40 окружений
50 окружений
+25%
Chromium, gVisor
80 подов
160 подов
+100%
Python, gVisor
80 сессий
240 сессий
+200%
1. Традиционная нагрузка: сборка ядра Linux
Сначала мы проверили swap на привычной пакетной задаче — полной сборке ядра Linux 6.1.1. При компиляции параллельно работают несколько потоков. Скомпилированные объектные файлы занимают память, а на коротком этапе линковки ее потребление резко растет.
Похожим образом память используется в корпоративных CI/CD-пайплайнах. Пайплайн движется дальше, а уже скомпилированные объекты остаются в памяти, хотя больше не используются. Поэтому такие задачи хорошо подходят для уменьшения потребления RAM с помощью swap.
Без swap у сборки был лимит памяти не ниже 600 MB, иначе она завершалась из-за OOM. Swap на локальном SSD снизил лимит вдвое — до 300 MB. И это без замедления: сборка завершилась за 374 секунды вместо 433.
Но когда лимит снизили до 200 MB, в swap попал активный рабочий набор — память, к которой приложение регулярно обращается. Ожидание ввода-вывода выросло, а сборка заняла более чем на 40% больше времени.
Помните: swap — страховка на случай кратковременных всплесков потребления памяти, а не замена RAM для активной работы.
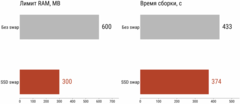 Два результата сборки ядра Linux 6.1.1
2. Нагрузки ИИ-агентов: больше изолированных браузеров на узле
ИИ-агентам часто нужно управлять браузерами Chromium без графического интерфейса. А выполнение внешнего недоверенного кода требует более строгой изоляции, чем дают обычные пространства имен Linux. Мы сравнили несколько сред выполнения контейнеров. Исходные журналы и методика тестирования стандартной среды доступны в каталоге Agent Sandbox GKE Swap.
Базовый вариант без песочницы (runc). Сначала мы проверили пределы узла без дополнительных расходов на защищенную среду выполнения. На узле c4-standard-32 с 32 vCPU и 120 GB RAM запускали обычные контейнеры runc. Без swap память заканчивалась при превышении 512 подов. Со swap на локальном SSD узел поддерживал 768 одновременно работающих подов.
Среды с усиленной изоляцией (gVisor и Kata Containers). Строгая изоляция требует дополнительной памяти и обычно сокращает число подов, которые помещаются на узле. Без swap gVisor упирался в лимит в 80 подов, а с ним на локальном SSD удалось запустить 160 подов одновременно — вдвое больше.
MicroVM Kata Containers без swap исчерпывали RAM при 40 одновременно работающих подах. Со swap на GCP Local SSD удалось запустить 50 стабильно работающих microVM Kata. После этого ограничением стал CPU.
Кстати, Kata Containers и agent sandbox доступны и у нас в облаке, в Managed Kubernetes. Подробнее о первом здесь, о втором здесь.
При максимальной плотности поды дольше отвечают главным образом из-за конкуренции за CPU, а не из-за ввода-вывода swap. Если нужно уложиться в определенное время отклика, размещайте меньше подов, чем в пиковых результатах теста. Тогда и рост задержек будет меньше.
3. Не браузерами едиными: изолированные среды Python
Swap на узле полезен и для изолированного выполнения недоверенного кода. В этом тесте мы одновременно запускали Python-сессии. Каждая анализировала 5 млн строк из набора MovieLens 20M и занимала в RAM примерно 375 MiB. Подробные результаты масштабирования и код развертывания есть в том же репозитории, что и выше.
Без swap одновременные всплески потребления памяти исчерпывали RAM: узел уже не справлялся при 80 параллельных сессиях. Swap на локальном SSD позволил выгрузить неактивную анонимную память, освободить RAM и сохранить страничный кеш узла. В результате удалось запустить 240 изолированных Python-песочниц одновременно — втрое больше.
Как и в браузерных тестах, при максимальной плотности задержки растут главным образом из-за конкуренции за CPU, а не из-за самого swap.
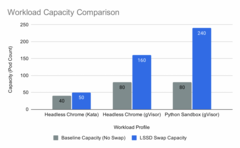 Плотность размещения со swap на узле и без него
Как использовать
Если вы управляете инфраструктурой Kubernetes для сред разработки, ферм браузерного тестирования, JVM-приложений или сред выполнения ИИ, swap на локальных SSD может значительно увеличить число нагрузок на одном узле.
В Kubernetes 1.34 и новее поддержка swap на узлах общедоступна. Включить ее можно в конфигурации kubelet:
kind: KubeletConfigurationapiVersion: kubelet.config.k8s.io/v1beta1failSwapOn: falsememorySwap: swapBehavior: LimitedSwapДля нагрузок, которым нужен swap, используйте класс QoS Burstable. У контейнера, которому нужен доступ к swap, запрос памяти должен быть меньше лимита. При LimitedSwap доступный объем swap рассчитывается с учетом запроса памяти контейнера и объема RAM узла. После настройки проверьте поведение своей нагрузки: рост плотности размещения и время отклика зависят и от дисков, и от того, какая часть памяти активно используется.
От себя дополню: для swap особенно важны низкие задержки и высокая производительность диска. От них зависит, как быстро страницы вернутся в RAM. Например, Google Kubernetes Engine поддерживает Node Memory Swap на профилях с Local SSD. Результаты тестов выше получены на быстрых локальных SSD, поэтому переносить их на другую дисковую подсистему без собственных замеров я бы не стал.
Также пара слов о том, как можно поэкспериментировать с swap у нас на узлах Managed Kubernetes. Для такой ручной настройки нужно отключить автовосстановление группы узлов. Параметр описан в инструкции по созданию группы узлов, в пункте «Автовосстановление».
Помимо изменений в конфигурации на каждом рабочем узле, где нужен swap, выполните команды с правами root. В примере делаем файл подкачки размером 2 GiB:
# Создаем файл размером 2 GiB для подкачкиfallocate --length 2GiB /swapfile# Задаем права доступаchmod 600 /swapfile# Подготавливаем файл подкачкиmkswap /swapfile# Подключаем файл подкачкиswapon /swapfile# Проверяем: в выводе должен быть /swapfile размером 2 GiBswapon -s# Перезапускаем kubelet, чтобы он обновил конфигурацию и увидел подключенный swapsystemctl restart kubelet.serviceИсточник: habr.com