
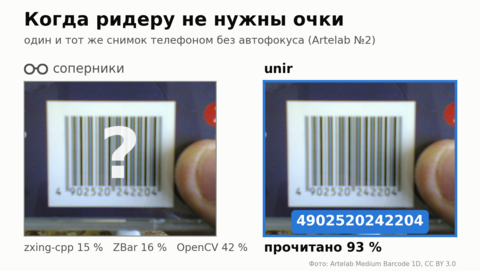
EAN-13 на пачке, сфотографированной телефоном без автофокуса. Code 128 на коробке под углом, SSCC на паллетной этикетке, которая проезжает под камерой конвейера. Мы сравнили, как такие снимки читают zxing-cpp, ZBar, OpenCV и движок линейных штрихкодов нашего универсального ридера кодов (unir). Снимки — из открытых наборов с чужой разметкой, их может скачать любой, и любую цифру можно проверить.
Коротко:
Всего прочитано: unir — 72 % из 6899 штрихкодов, ZBar — 56 %, zxing-cpp — 54 %, OpenCV — 42 %.
Главная разница — на размытых снимках. На наборе Artelab-2 unir читает 93 %, соперники — от 15 до 42 %.
Ложных чтений нет у unir, zxing-cpp и ZBar на 4231 снимке без кода; у OpenCV — 7.
По скорости ридеры почти равны: на обычном снимке у всех, кроме ZBar, 10–20 мс. Если на кадр дано 60 мс, чёткие коды все читают почти одинаково, а трудные — только unir.
Слабое место unir: на снимке, который он не может прочитать, он долго перебирает варианты. И часть кодов соперники читают, а он нет — о них ниже.
Зачем мы это мерили
Мы делаем библиотеку чтения кодов для производства и логистики (libscanner.com). Для DataMatrix «Честного знака» у неё есть ридер dmr: прошлая статья сравнивала его с ZXing, zxing-cpp и libdmtx. Но на той же этикетке почти всегда есть и линейные штрихкоды. На коробке — EAN-13 товара, на паллете — GS1-128 с номером SSCC, на складе и в почте — просто Code 128. Их читает второй движок библиотеки — движок линейных штрихкодов. Дальше в тексте мы называем его просто unir: в сравнении участвует только он, без ридеров DataMatrix и QR.
Линейный штрихкод считается простым, и открытых ридеров для него много. Под рукой у каждого четыре: zxing-cpp (C++ порт ZXing), ZBar — старожил, на нём построено множество сканеров, OpenCV со своим детектором barcode::BarcodeDetector и он же с моделью сверхразрешения от WeChat, которая перед чтением увеличивает вырезку нейросетью. Вопрос тот же, что с DataMatrix: где у каждого кончается надёжное чтение и насколько дальше можно уйти.
Коммерческие SDK в сравнение снова не вошли: их лицензии запрещают публиковать замеры без согласия производителя.
Почему открытые наборы
В прошлый раз мы сравнивали на синтетике: реальные кадры с линий выложить нельзя. Синтетику можно проверить, но у неё понятный недостаток: символы, условия и истину придумали мы сами, а ридер разрабатывали под похожие кадры.
Для линейных штрихкодов есть способ лучше. Исследователи давно собирают наборы снимков с разметкой: какой код на снимке. Снимки делали не мы, размечали не мы, а скачать их может любой. Мы взяли пять таких наборов и два собрали сами из открытых источников:
Набор
Снимков с истиной
Что на снимках
Лицензия
Artelab Medium Barcode 1D, №1
214
EAN-13, телефон с автофокусом
CC BY 3.0
Artelab Medium Barcode 1D, №2
213
те же товары, телефон без автофокуса
CC BY 3.0
DEAL KAIST, barcode_bb
3200
EAN-13, разный размер и съёмка
CC BY 4.0
DEAL KAIST, e8_bb
89
EAN-8 и UPC-E
CC BY 4.0
SmartEngines barcode, test
3000 из 3960
EAN-13, UPC-A/E и Code 128 в «диких» условиях
авторами не указана *
Open Food Facts
145
фото товаров, присланные покупателями
CC BY-SA
Wikimedia Commons
38
Code 128 на коробках, этикетках, посылках
свободные лицензии Commons
* Лицензию набора SmartEngines авторы не указали; подробнее — в разделе «Как повторить».
У Artelab, DEAL и SmartEngines истина — разметка авторов набора. У Open Food Facts истина — штрихкод товара из их базы, то есть номер, под которым товар заведён. Но на многих фото товара штрихкода нет вовсе (лицевая сторона, состав), поэтому из 1258 скачанных фото в набор вошли 145, где код товара прочитал хотя бы один из двух ридеров — ранняя версия нашего движка или zxing-cpp. Такой отбор играет на руку им обоим, а ZBar и OpenCV в нём не участвовали; цифры по этому набору стоит читать с этой поправкой. Из SmartEngines мы взяли только снимки с EAN/UPC и Code 128 и случайную подвыборку из 3000 (зерно 1, в скрипте), чтобы прогон шёл часы, а не сутки.
У снимков с Commons разметки нет. Истиной считали код, который дали хотя бы два из четырёх источников: zxing-cpp, ZBar, ранний прогон unir и имя файла на Commons. Это слабее разметки, поэтому набор маленький, и выводы по нему мы делаем осторожно.
Для ложных чтений нужны снимки, где штрихкода нет, но есть то, что на него похоже. Мы взяли 4231 такой снимок: 788 фонов из DEAL, 3243 кадра DataMatrix с производственных линий (рядом текст, рельсы конвейера, блистеры; выложить их нельзя) и 200 синтетических ловушек: полосатая ткань, жалюзи, клетка, растр, псевдоштрихи. Любой код, прочитанный на этих снимках, — ложный.
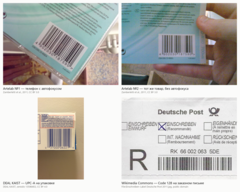 Примеры снимков: Artelab №1 и №2 — один и тот же товар с автофокусом и без (второй из них zxing-cpp и ZBar не читают), DEAL KAIST, Wikimedia Commons. Источник и лицензия — под каждым снимком. SmartEngines не показываем: лицензию набора авторы не указали.
Как мерили
Каждый ридер получает тот же файл и возвращает все коды, которые нашёл. Соперникам стенд подаёт снимок, переведённый в полутон: читают они всё равно по яркости. unir читает его в цвете (--color, ниже) — цвет ему нужен только для одного запасного прохода; что он даёт, мы приводим отдельно. Снимок считается прочитанным, если среди выданных кодов есть код из истины. UPC-A сравнивается как EAN-13 с ведущим нулём, UPC-E — и как есть, и в развёрнутом виде. У Code 128 разделитель GS и скобки AI не учитываются.
Если ридер выдал код, которого нет в истине, это чужой код. Чужой код — не обязательно ложное чтение: на снимке может быть второй штрихкод, которого нет в разметке. Поэтому мы делим чужие коды на два вида. Подтверждённые — такой же код выдал и другой ридер; почти всегда это настоящий соседний код. Одиночные — код выдал только один ридер; это кандидаты в ложные.
Соперники работают в лучшем режиме, который мы смогли у них найти, и одинаково на всех снимках. В прошлый раз в комментариях спросили, какие именно были настройки, поэтому приводим вызовы целиком (Python, сокращённо; полный код — harness/bench.py в репозитории стенда):
# zxing-cpp 3.1.1: два бинаризатора, ответы объединяютсяfor b in (zxingcpp.Binarizer.LocalAverage, zxingcpp.Binarizer.GlobalHistogram): zxingcpp.read_barcodes(img, formats=EAN13|EAN8|UPCA|UPCE|Code128, try_rotate=True, try_downscale=True, try_invert=True, text_mode=zxingcpp.TextMode.Plain, binarizer=b)# ZBar через pyzbar 0.1.9: строки он ведёт только по осям x и y,# поэтому снимок, он же инвертированный и он же повёрнутый на 45°, ответы объединяютсяpyzbar.decode(img, symbols=[EAN13, EAN8, UPCA, UPCE, CODE128])# OpenCV 5.0.0 — без модели; OpenCV 4.10.0 — с моделью сверхразрешения WeChat# (в OpenCV 5 конструктор с моделью Caffe убран)cv2.barcode.BarcodeDetector() # илиcv2.barcode.BarcodeDetector("sr.prototxt", "sr.caffemodel") # github.com/WeChatCV/opencv_3rdpartyЗапускали unir так, как его запустит читатель, — утилитой из выпуска 1.2.7 (pip install libscanner-unir ставит её же): unir --batch --color --sym ean,128,gs1 --codes 0 --budget-ms 0. Это EAN/UPC и любой Code 128, все коды на снимке, без предела времени. Снимок читается в цвете: если по яркости кода не нашлось, а символ виден, движок пробует ещё синий канал — цветные штрихи и этикетки теряют в яркости контраст, а в канале его сохраняют. Без --color (полутон) unir прочитал бы 4881 код вместо 4974, разница почти вся на Artelab №2 (152 против 198); ложных нет в обоих режимах.
Одна тонкость для тех, кто будет повторять. На пограничных снимках ответ зависит даже от декодера JPEG: наша внутренняя утилита движка декодирует снимки через stb_image, а unir — через libjpeg-turbo, и на нескольких десятках снимков из 11 151 ответы различаются (для unir 1.2.1 — на 36: 4731 прочитанный против 4728). Внутри одного декодера опыт повторяется точно: два полных прогона стенда совпали на всех 11 151 снимке.
Процессор — Intel Core i5-1335U, Windows 11. Время мерили отдельно, на свободной машине, о нём ниже.
Результаты
Общий итог
Прочитано штрихкодов (доля от всех символов с истиной в наборе):
Набор
символов
unir
zxing-cpp
ZBar
OpenCV + SR
Artelab №1, автофокус
214
211 (98,6 %)
193 (90,2 %)
200 (93,5 %)
206 (96,3 %)
Artelab №2, без автофокуса
213
198 (93,0 %)
32 (15,0 %)
34 (16,0 %)
89 (41,8 %)
DEAL, EAN-13
3200
2889 (90,3 %)
2369 (74,0 %)
2385 (74,5 %)
2244 (70,1 %)
DEAL, EAN-8 и UPC-E
89
84 (94,4 %)
79 (88,8 %)
80 (89,9 %)
62 (69,7 %)
SmartEngines
3000
1417 (47,2 %)
892 (29,7 %)
1030 (34,3 %)
222 (7,4 %)
Open Food Facts
145
138 (95,2 %)
125 (86,2 %)
120 (82,8 %)
96 (66,2 %)
Commons, Code 128
38
37 (97,4 %)
34 (89,5 %)
33 (86,8 %)
0 — Code 128 не читает
Всего
6899
4974 (72,1 %)
3724 (54,0 %)
3882 (56,3 %)
2919 (42,3 %)
OpenCV без модели сверхразрешения читает почти столько же (2827): модель добавляет 92 кода, почти все на DEAL.
Как и в прошлый раз, доля «из всех» сама по себе говорит мало: она зависит от того, какие наборы мы взяли, а DEAL с его 3200 снимками весит в ней больше всех. Важнее, на каких снимках расходятся ридеры.
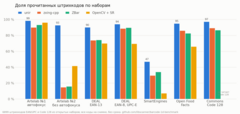 Доля прочитанных штрихкодов по наборам для четырёх ридеров.Что видно
Размытие — главное различие. Artelab сняли одни и те же товары дважды: телефоном с автофокусом и телефоном без него. На резких снимках все четыре ридера читают 90–99 %. На размытых zxing-cpp и ZBar падают до 15–16 %, а unir держит 93 %. OpenCV держится лучше классических ридеров (42 %), но и ему размытие стоит половины. Что делает unir, чтобы читать размытый код, — в разделе ниже.
Трудные «дикие» снимки. SmartEngines — самый тяжёлый набор: мелкие коды, блики, плёнка, сильная перспектива. Почти половину его штрихкодов не читает ни один ридер: все вместе прочитали 1642 из 3000. unir здесь первый (47 %), но до полного чтения далеко всем. Отдельно по Code 128 из этого набора: unir читает 392 из 1210, zxing-cpp — 137, ZBar — 140.
Обычные фото товаров. На Open Food Facts и DEAL разница меньше, но тоже заметная: unir читает на 9–16 процентных пунктов больше лучшего из соперников.
Где unir не лучший
На каждом наборе есть снимки, которые читает кто-то из соперников, но не unir. Больше всего их на двух наборах. На SmartEngines таких 225 символов, и почти все их читает ZBar (201). На DEAL — 65: их почти поровну читают zxing-cpp (41) и ZBar (38). Обратных, когда unir читает, а ни один из соперников нет, — 374 на SmartEngines и 187 на DEAL.
Значит, ридеры ошибаются на разных снимках, и выигрыш одного не покрывает другого полностью. Если важен каждый код, а время не жмёт, можно читать двумя ридерами по очереди: на SmartEngines «unir, затем ZBar» прочитал бы 1618 вместо 1417.
Ложные чтения
На 4231 снимке без штрихкода ни одного кода не выдали unir, zxing-cpp и ZBar. OpenCV выдал 7: один на фонах DEAL и шесть на синтетических ловушках.
Одиночные чужие коды на снимках со штрихкодами — то, что ридер выдал, а никто другой не подтвердил:
unir
zxing-cpp
ZBar
OpenCV + SR
одиночных чужих на 6899 символах
6
56
80
102
Это кандидаты в ложные, а не доказанные ложные: часть из них — вторые коды на снимке, которых нет в разметке. Но порядок понятен. Для склада и производства неверно прочитанный код хуже непрочитанного: непрочитанную коробку снимет контроль, а коробка с чужим номером уйдёт дальше. Поэтому unir отказывается от чтения, в котором не уверен, даже ценой нескольких процентов прочтения. Как именно — в разделе ниже.
Время
Среднее время по всем снимкам говорит мало: его делают несколько медленных снимков, а какие они — зависит от набора. Поэтому мы разложили снимки на группы по тому, кто их читает, и в каждой группе спросили две вещи. Сколько уходит на снимок? И сколько кодов ридер прочитает, если на кадр дано 60, 100 или 500 мс?
Группы — по итогам прогона выше, по 150 случайных снимков в каждой:
-
чёткие — читают все четыре ридера;
-
средние — читает unir и часть соперников;
-
трудные — читает только unir;
-
код читает кто-то из соперников, но не unir;
-
код не читает никто, хотя он на снимке есть;
-
кода на снимке нет — снимки из отрицательных наборов.
Все ридеры получают одни и те же байты: снимок заранее переведён в полутон и лежит в памяти, время — только вызов чтения. Каждый ридер работает в своём процессе, закреплённом за одним производительным ядром, в один поток. Три круга, у каждого снимка берётся лучшее время. unir ищет один код (до первого прочитанного) и получает срок по-настоящему: budgetMs = 60, 100 или 500. Задать срок соперникам нельзя, поэтому им засчитан код, прочитанный не дольше срока. unir засчитан тоже, только если он в срок уложился.
Сначала — сколько времени уходит на снимок, если срока нет. В каждой клетке два числа: медиана и 90-й процентиль. Например, «14 / 145» значит, что половину снимков ридер обработал быстрее 14 мс, а 90 % — быстрее 145 мс. В скобках у группы — медианный размер снимка.
Снимки, которые unir читает, мс:
Группа (размер)
unir
zxing-cpp
ZBar
OpenCV + SR
чёткие (1,9 Мп)
14 / 145
20 / 91
171 / 965
20 / 45
средние (0,6 Мп)
10 / 132
9 / 27
71 / 263
16 / 44
трудные (0,6 Мп)
11 / 194
7 / 19
67 / 182
15 / 45
Здесь время unir — это время до прочитанного кода. У соперников на средних и трудных снимках это часто время до отказа: код они не нашли.
Снимки, на которых unir ничего не находит, мс. Здесь время unir — это сколько он ищет, прежде чем сдаться. Чем меньше, тем лучше: на конвейере это время, потраченное на кадр впустую.
Группа (размер)
unir
zxing-cpp
ZBar
OpenCV + SR
код читает кто-то из соперников (0,4 Мп)
152 / 642
5 / 16
43 / 152
14 / 34
код не читает никто (0,4 Мп)
43 / 275
4 / 8
38 / 89
12 / 28
кода на снимке нет (0,3 Мп)
39 / 201
4 / 8
40 / 61
8 / 10
Первая строка — худший случай для unir: код на снимке есть, другой ридер его видит, а unir перебирает все свои приёмы и не находит. zxing-cpp тратит на те же снимки в 30 раз меньше. Две другие строки — снимки, где прочитать не может никто. По медиане unir здесь наравне с ZBar, но хвост у него в три раза длиннее, а zxing-cpp сдаётся в 10 раз быстрее.
Прочитано из 150 за 60 / 100 / 500 мс:
Группа
unir
zxing-cpp
ZBar
OpenCV + SR
чёткие
139 / 148 / 150
131 / 141 / 150
23 / 59 / 112
149 / 150 / 150
средние
134 / 141 / 150
91 / 93 / 95
40 / 71 / 93
47 / 47 / 47
трудные
123 / 132 / 149
0
0
0
код читает кто-то из соперников
1 / 1 / 2
56 / 58 / 58
86 / 103 / 118
19 / 20 / 20
У unir число в срок может чуть плавать от круга к кругу: чтение со сроком зависит от того, успел ли нужный шаг. В таблице — медиана трёх кругов, круги расходятся не больше чем на 2 кода из 150.
Время меряли в полутоне, на одних и тех же байтах для всех ридеров. Проход по синему каналу (раздел «Как мерили») в этот замер не входит: он запускается только на цветном кадре, где по яркости ничего не прочитано, и добавляет время именно таким кадрам — на нашем поиске в среднем около четверти.
Что из этого следует.
Главное: в срок unir читает больше всех. Если на кадр дано 60 мс, unir читает 134 средних кода из 150, а лучший из соперников, zxing-cpp, — 91. На чётких снимках все, кроме ZBar, близки: OpenCV — 149, unir — 139, zxing-cpp — 131, а за 500 мс у всех троих 150.
Трудные снимки за 60 мс unir читает 123 из 150. Соперники не читают ни одного — даже за полсекунды.
Цена — снимки, которые unir не читает. На них он долго ищет, прежде чем сдаться: где код видит кто-то из соперников, у unir медиана 152 мс, у zxing-cpp — 5. Такие снимки соперники и читают: ZBar за полсекунды — 118 из 150, zxing-cpp — 58, unir — 2.
На обычном снимке скорость у всех, кроме ZBar, одинаковая. Медиана unir — 10–14 мс, zxing-cpp — 7–20, OpenCV — 15–20. Длинный хвост unir на чётких снимках (90-й процентиль 145 мс против 45 у OpenCV) дают фото по 8–12 мегапикселей. Поэтому при коротком сроке unir сначала читает снимок, уменьшенный в 3, затем в 2 раза: крупный код так читается за 5–30 мс. Без этого в 60 мс было бы 116 чётких вместо 139. ZBar медленнее всех: в нашем режиме он прогоняет снимок трижды.
Срок unir соблюдает. Превышение — не больше 22 мс, а на снимках, которые он читает, — не больше 8.
Для сканера в руке или камеры над конвейером со снимком до 2 Мп unir укладывается в 60 мс на большинстве кадров. Для фото, присланного на сервер, где срок — секунды, время у всех ридеров приемлемо, и разница — только в том, сколько прочитано.
Чтобы убрать цену unir на нечитаемых снимках, указывайте бюджет времени — budgetMs в библиотеке или --budget-ms в утилите. Тогда на снимке, который он не прочитает, unir остановится через заданное время, например через 60 мс вместо 152 мс по медиане и 642 мс в хвосте. Сколько он прочитает в этот срок, показывает таблица выше.
SSCC на конвейере
С этого движок начинался. На паллетной этикетке GS1-128 с SSCC — длинный символ из 156 модулей, а камера над конвейером видит его мелко: 1,5–2 пикселя на модуль, под любым углом, со смазом от движения.
Здесь публичных наборов нет, поэтому сравнение — на синтетике, как в прошлой статье. Символы рисует отдельный, независимый от ридера генератор, рядом на этикетке — текст и второй GS1-128. Чтобы соперники не проигрывали из-за поворота (линейные коды они ищут строками около 0° и 90°), символ почти горизонтален: поворот ±5°. Номинал — 2,2 пикселя на модуль, меняется одно условие за раз, на точку — 50 кадров. Соперники — zxing-cpp и ZBar в тех же режимах, что выше; OpenCV Code 128 не читает.
В таблице — предел: худшее значение условия, при котором ридер читает не меньше 90 % кадров, как в статье о DataMatrix.
Условие
unir
zxing-cpp
ZBar
Размер модуля
от 0,8 px
от 1,6 px
от 1,4 px
Размытие σ
до 2,6 px
до 1,2 px
до 0,6 px
Шум σ
до 70 (дальше не проверяли)
до 18
до 3
Контраст печати
до 0,04
только полный (на 0,3 — 78 %)
до 0,2
Наклон этикетки
до 65°
до 45°
до 55°
Смаз поперёк штрихов
до 6 px
до 2 px
только без смаза
JPEG
до качества 5 у всех
Растискивание краски
±0,4 модуля у всех
На растискивании ±0,5 модуля одномодульные элементы закрываются, и читать нечего никому — это предел самой проверки, а не ридеров.
Одна странность у zxing-cpp: при модуле ровно 1,0 px он читает все 50 кадров, хотя при 1,1–1,2 px — ни одного. Похоже, дело в том, что при таком модуле и почти нулевом повороте модуль ложится ровно в пиксель, и порог бинаризации работает как на идеальном символе. На реальной камере такого совпадения не бывает.
Поворот под любым углом. На конвейере этикетка редко лежит ровно, поэтому тот же замер мы повторили с поворотом символа на случайный угол от 0 до 360° (по 30 кадров на точку). Предел — по тому же правилу, 90 % кадров:
Условие
unir
zxing-cpp
ZBar
Размер модуля
от 0,8 px
—
1,8–3 px
Размытие σ
до 2,6 px
—
до 0,6 px
Шум σ
до 70
—
до 3
Контраст печати
до 0,04
—
до 0,3
Наклон этикетки
до 65°
—
только без наклона
Смаз поперёк штрихов
до 7 px
—
только без смаза
JPEG
до качества 5
—
до 15
Растискивание краски
±0,4 модуля
—
от −0,2 до +0,4
Прочерк значит, что 90 % не набрано ни в одной точке. zxing-cpp и на номинале читает только 12–19 кадров из 30, а лучший его результат — 22 из 30.
Дело в том, как ридеры ищут линейный код. zxing-cpp и ZBar проводят строки сканирования по горизонтали и вертикали; ZBar мы вдобавок даём снимок, повёрнутый на 45°. Длинный SSCC читается, только если строка пересекает все 156 модулей. Если символ повёрнут на произвольный угол, строка выходит за его край раньше. Поэтому соперники читают только кадры, где угол случайно оказался близок к одному из «их» направлений: у zxing-cpp таких около половины, у ZBar с тремя проходами — почти все на номинале, но при любой порче запас пропадает. unir сначала находит направление штрихов и ведёт строки вдоль символа, поэтому угол поворота на его пределы не влияет: они те же, что у ровного символа, а по смазу даже на 1 px дальше.
Неверные номера. На 7840 кадрах проверки у unir неверных номеров нет. Это не само собой: у SSCC две контрольные суммы, и неверный знак может пройти обе, а две строки одного символа — «подтвердить» друг друга. Поэтому unir принимает SSCC-строку, только если она в целом уверенная или на каждом месте лучший знак заметно обгоняет второй. У ZBar на тех же кадрах 4 неверных номера, у zxing-cpp — ни одного.
Наклон долго был нашим слабым местом, и как раз подготовка этой статьи это показала: прежняя версия при 55° читала 21 кадр из 50 против 34 у zxing-cpp. Причина оказалась не в перспективе, как мы думали. При наклоне вокруг промежуточной оси штрихи перекашиваются относительно оси символа, он становится параллелограммом, а наша строка шла строго поперёк штрихов и выходила за их конец раньше стопа. Горизонтальная строка zxing-cpp при почти горизонтальном символе идёт вдоль его оси и этой беды не знает. Теперь ридер оценивает перекос по области штрихов и читает такой символ строками вдоль оси; чтобы принять номер, нужны две согласные строки. Предел отодвинулся, но не исчез: при 75° мы читаем чуть больше половины кадров.
Синтетика повторяема: генератор кадров детерминирован, и прогон с тем же зерном даёт те же кадры и те же ответы — мы проверили это повтором. А 10 кадров на точку мало: на прежней версии при наклоне 55° две выборки по 10 кадров дали 4 и 7 прочитанных. И даже 50 случайных кадров не всё решают: исход зависит от оси наклона, и с другим зерном прежняя версия на той же точке шла впереди zxing-cpp. Поэтому мы проверяли ещё и по сетке «наклон × ось»: 630 кадров от 35° до 75° — у zxing-cpp 316, у нас 571, неверных номеров у нас нет. Все 5840 кадров синтетики с истиной и ответами трёх ридеров по каждому кадру выложены в репозиторий стенда.
Почему размытый штрихкод — это трудно
Классический ридер читает строку так: бинаризует её (светлое — пробел, тёмное — штрих), измеряет ширины и сравнивает их с таблицей. Так работают и ZBar, и zxing-cpp. На резком снимке это быстро и надёжно.
Размытие ломает первый шаг. У EAN-13 самые узкие элементы — один модуль. Когда пятно размытия становится шире модуля, узкий штрих и узкий пробел рядом с ним сливаются в серое: у них больше нет своих краёв, и порог не может их разделить. Ширины выходят неверными, и цифра не читается. На снимках Artelab №2 это видно по цифрам: zxing-cpp и ZBar теряют 85 % кодов.
Линейный движок unir не бинаризует строку. Вот что он делает, коротко.
Детектор по направлению градиента. Кадр режется на клетки, и в каждой считается тензор структуры градиента. Штрихкод даёт сильный градиент одного направления со сменой знака: штрих, пробел, штрих. Связные клетки с одним направлением становятся кандидатом с углом и протяжённостью. Строки сканирования кладутся строго поперёк штрихов, под любым углом. Перед чтением профиль усредняется вдоль штрихов, и шум падает.
Анализ через синтез. Устройство символа известно заранее. У EAN-13 — 95 модулей с охранными штрихами по краям и в середине, у Code 128 каждый знак — ровно 11 модулей. По охранным зонам ридер подбирает концы символа, ширину размытия, растискивание краски и перспективу. Затем каждое место символа сравнивается с профилями всех возможных цифр, размытыми так же, как кадр. Сравнение — корреляцией, которой безразличны свет и контраст. Краёв для этого не нужно: размытый профиль сравнивается с размытым эталоном. Тот же подход описан у Rocholl, Klenk и Heidemann (ICPR 2010).
Цифры со своим сдвигом. Этикетка на банке, на мятой плёнке, на изогнутой коробке растянута неравномерно. Если строить сетку только по концам, к середине символа она съезжает. Поэтому у каждой цифры EAN-13 свой небольшой сдвиг и масштаб, а их согласованность ищется динамическим программированием, как у Gallo и Manduchi (PAMI 2011). Для банки и бутылки отдельно есть развёртка профиля с цилиндра.
Ширины — тоже. На резких кодах, особенно на длинных Code 128 произвольной длины, чтение по ширинам надёжнее корреляции. unir читает обоими способами, а края берёт по экстремумам производной, а не по порогу.
Повтор на уменьшенном снимке. Если символ виден, но не прочитан, поиск повторяется на снимке, уменьшенном в 2–4 раза. Уменьшение сглаживает шум и растр печати. Отсюда и хвост времени. При коротком сроке на большом снимке порядок обратный: сначала уменьшенный, потом полный.
Строгая приёмка. У EAN-13 одна контрольная цифра: случайная строка проходит её с вероятностью 1 из 10. Этого мало, поэтому unir принимает чтение только при нескольких условиях сразу:
-
на каждом месте лучшая цифра должна обгонять вторую с запасом;
-
свободные зоны по краям должны быть чистыми — и проверяются они по самому кадру, за концом строки сканирования: иначе кусок длинного символа, который детектор нашёл отдельно, читался как короткий код;
-
у прочего Code 128 число найденных штрихов и пробелов должно сходиться с ожидаемым для прочитанных знаков: иначе длинный «Code 128» иногда складывался из штрихов Code 39 или Codabar, у которых элементы двух ширин;
-
EAN и прочий Code 128 должны прочитаться хотя бы двумя строками сканирования, и строки должны согласиться;
-
Code 128 короче трёх печатных знаков не выдаётся: на полосатом фоне такие «коды» находятся слишком легко.
Самый поучительный урок мы получили на SSCC. Первая версия ридера при неудаче пробовала заменить одно-два неуверенных места соседними по оценке знаками, пока не сойдутся контрольные суммы. Казалось бы, две суммы сразу (mod 103 и цифра SSCC) — надёжная защита. На калибровке это дало 13 верных чтений и 36 неверных. Случайный ряд проходит обе суммы с вероятностью около 1 из 1000, и перебор сотни подмен на плохой строке находил его. А вторая строка того же символа «подтверждала» неверный номер: строки одного символа не независимы. Подмены мы убрали. Теперь неуверенное место не угадывается: ридер отвечает «не прочитал».
Ограничения этого сравнения
Наборы публичные, но выбирали их мы. Это пять наборов, которые удалось скачать: Muenster BarcodeDB сейчас недоступен по ссылке авторов, BarBeR требует регистрации. Мы разрабатывали unir, глядя на промахи на этих же наборах, так что это всё равно наше «домашнее поле», хотя и с чужой разметкой. Поэтому выкладываем скрипт стенда целиком: его можно прогнать на любом своём наборе.
Время снято на одном ноутбуке, абсолютные цифры зависят от процессора. Сравнивать стоит ридеры между собой.
Как повторить
Скрипт стенда, подготовка истины из разметки каждого набора и сырые ответы всех ридеров по каждому снимку лежат в репозитории libscanner/barcode-1d-benchmark. Сами снимки мы не перекладываем: их нужно скачать у авторов наборов, ссылки — в README.
-
Artelab Medium Barcode 1D — artelab.dista.uninsubria.it (Zamberletti, Gallo, Carullo, Binaghi, 2011);
-
DEAL KAIST — zenodo.org/records/13586402;
-
SmartEngines barcode — ftp://smartengines.com/barcode/ (Milovzorov, Bezmaternykh, Arlazarov, doi:10.1117/12.2587628). Лицензию набора авторы не указали — ни в README на сервере, ни в статье; каталог BenSouchet/barcode-datasets пишет CC BY 4.0, но без источника, а соседние наборы Smart Engines на том же сервере идут под CC BY-SA 2.5. Поэтому снимки SmartEngines мы не перекладываем и не показываем: в репозитории только разметка и ответы ридеров;
-
Open Food Facts и Wikimedia Commons — скрипт в репозитории скачивает те же снимки по списку.
Соперники ставятся одной командой:
pip install zxing-cpp pyzbar opencv-contrib-pythonДвижок линейных штрихкодов входит в наш универсальный ридер кодов unir вместе с ридерами DataMatrix и QR. Попробовать на своих снимках:
pip install libscanner-unirили прямо в браузере — libscanner.com/scan. Пробный период — 30 дней, без регистрации. Примеры на C++, C и Python — в репозитории библиотеки.
Источник: habr.com