
Input tokens exceed 922,000 tokens. Your messages resulted in 1,674,813 tokens — с этой ошибки началась история, которая растянулась на полгода. У нас self-hosted OpenWebUI, на нём внутренний ассистент для небольшой команды: файлы, документы, мелкие инженерные задачи. Сначала я писал фильтр, который вычищает из истории результаты инструментов. Потом понял, что латаю не то место, и вынес исполнение агента в отдельный сервис на OpenAI Agents SDK и Codex SDK. По дороге ещё споткнулся о потоковый Responses API.
Про версии сразу. 21 апреля мы перевели прод с 0.8.12 на OpenWebUI v0.9.1, в тот же день, когда она вышла, и фильтр я писал уже под неё. Всё, что ниже сказано про внутренности OpenWebUI, относится к v0.9.1. Пилот с отдельным агентом в июле запускался на v0.9.5, в конце июля прод переехал на v0.11.0. Порядок вызовов в middleware я потом сверил с текущим main (коммит b0e6098, он же тег v0.13.3, 9 ноября 2026) — одно отличие отмечу по ходу.
Апрель: один read_file на 66 871 символ
Всё упёрлось в Native Function Call. Как только я его включил, каждый результат вызова инструмента стал ездить к модели вместе со всей историей, в каждом следующем запросе. На внутреннем тесте 21 апреля 2026 года, в день того самого обновления, один read_file вернул 66 871 символ. Одиннадцать вызовов инструментов дали в сумме 129 972 символа, грубо 32 000 токенов. Через несколько ходов запрос перевалил за лимит, и пришла та самая ошибка про 1,67 млн токенов.
Хуже было поведение модели. Она раз за разом решала, что надо ещё что-то проверить или поправить, снова звала инструменты, контекст снова рос. Заканчивалось тем, что пользователь отменял задачу.
Где резать
Глядя на интерфейс, легко решить, что резать надо HTML: вызов инструмента там выглядит как свёрнутый блок
chat_message.content. Я полез в middleware и в базу, и картина оказалась другой. Настоящие данные хранятся в chat_message.output — это структурированный массив результатов. Функция process_messages_with_output ещё до вызова inlet-фильтра разворачивает output в обычный OpenAI-формат: assistant с tool_calls, за ним сообщения role=tool с полным содержимым. Там и сидели те 66 871 символ.
Outlet не подходил. Он срабатывает, когда ответ уже сохранён, и в v0.9.1 записывает обратно в базу только изменённый content. Поле output, из которого и рождаются сообщения role=tool, он не трогает. (В v0.11.0 и в текущем main outlet уже умеет сохранять и изменённый output, но весной у меня этого не было.) Оставался inlet: он получает развёрнутый список messages и может переписать его перед отправкой модели.
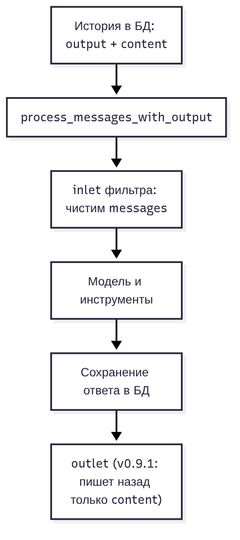 Схема: порядок вызовов в OpenWebUI v0.9.1 — process_messages_with_output, inlet, сохранение, outlet
Минус такого решения: база остаётся прежней, и чистить приходится заново на каждом запросе.
Phase 1: выкинуть старые результаты
Первая версия нашего фильтра получилась короткой. Ищу последнее сообщение role=user — всё, что после него, считается текущим ходом и не трогается, иначе сломаются инструменты, которые выполняются прямо сейчас. Всё, что раньше, чистится: старые role=tool удаляются, у старых ответов assistant обнуляются tool_calls, текст ответа остаётся. Потом обрезка по числу ходов. Ход — это пара user/assistant, сообщения инструментов не считаются, системные я не трогаю.
22 апреля прошли восемь юнит-тестов: сохранение текущего хода, очистка исторических tool_calls, подсчёт ходов, возврат исходного body при внутренней ошибке. Dry-run на подготовленной истории с длинными результатами выдал:
[ContextFilter] INFO | tool_strip | before_tokens=~3637 | after_tokens=~103 | deleted_tool_msgs=2История была синтетическая, и позже это аукнулось.
Ещё на одну мелочь ушло время: фильтр какое-то время просто не работал. Код обновлён, к модели привязан, а сама Function выключена. С тех пор, если в логах нет строк trigger и tool_strip, я первым делом проверяю, активна ли Function.
Phase 2: сжатие, Valves и дедлок на одном воркере
Просто выбрасывать историю жалко — теряется смысл разговора. Во второй фазе я добавил сжатие: последние ходы остаются как есть, более ранние уходят в модель-суммаризатор и превращаются в одну историческую сводку. При следующем сжатии старая сводка идёт в материал и заменяется новой, так что сводки не копятся стопкой. Ходы после сжатия считаются заново, только по оставшимся парам user/assistant, иначе свёрнутая история продолжала бы раздувать счётчик.
Настройки вынесены в Valves. По умолчанию max_recent_turns=20, compress_trigger_turns=10, token_budget=30000, freeze_turns=5. Сжатие запускается, когда исторических ходов больше порога или примерная оценка токенов выше бюджета. Подключение и модель для сжатия по умолчанию не заданы, и тогда работает только Phase 1. На freeze_turns >= max_recent_turns фильтр пишет warning и тоже откатывается на Phase 1. Для Claude через LiteLLM к сводке добавляется cache_control с type=ephemeral.
Первая версия сжатия ходила за суммаризацией в собственный /api/chat/completions OpenWebUI прямо из inlet. В логах появилось compress_failed | TimeoutError: timed out. Причина нашлась в параметрах запуска: uvicorn ... --workers 1. Текущий запрос держит единственный воркер, внутренний запрос на сжатие ждёт, пока тот освободится, и через 30 секунд отваливается по таймауту. Я убрал этот путь совсем. Теперь фильтр читает конфигурацию подключений OpenWebUI, берёт оттуда адрес и ключ и идёт напрямую в OpenAI-совместимый шлюз. Нет подключения, оно выключено или настроено не полностью — пишет cache_skip и откатывается на Phase 1.
Тестов стало 25 вместо 8. Добавились условия запуска, неполные конфиги, падения HTTP, поведение cache_control и проверка, что при Native FC фильтр не переписывает tools и metadata.
Что показал прод через неделю
28 апреля я посмотрел логи за сутки: trigger=128, tool_strip=128. Фильтр срабатывал на каждом запросе. А вот реально удалённых сообщений role=tool за эти 128 срабатываний набралось два. Основной объём шёл другим путём. OpenWebUI сохранял в текст ответов assistant те самые блоки
Там же нашлись четыре compress_failed. У модели сжатия, gpt-4o-mini, лимит 128 000 токенов, а запросы на сжатие доходили до 161 590 – 169 575. Сводку пытались собрать из того, что само уже не влезало. Я переключил сжатие на qwen2.5-14b-instruct-1m с контекстом на миллион токенов, остальные Valves оставил.
Июль: перестать латать и вынести агента
К июлю стало понятно, что проблема шире истории сообщений. Не хватало инженерного цикла: прочитать файл, поправить, запустить команду, проверить, отдать отчёт. Встроенный агент OpenWebUI больше про подключение инструментов к чату. Большие файлы всё равно попадали в обычный контекст и раздували его или подвешивали фронтенд, а фильтр мог только подрезать хвост.
7 июля 2026 года я сел и сравнил варианты. Форкнуть OpenWebUI и заменить его agent loop технически можно, но тогда каждое обновление превращается в мёрж с апстримом, который сам активно развивает Agent, Tools и OpenTerminal. Отдельный сервис со ссылкой из OpenWebUI надёжнее, зато у пользователя два разных интерфейса. Я выбрал середину: в OpenWebUI появляется отдельный вход-«модель» на базе Pipe, а вся работа уходит во внешний Agent Runtime.
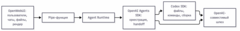 Схема: OpenWebUI → Pipe-функция → Agent Runtime → OpenAI Agents SDK / Codex SDK → OpenAI-совместимый шлюз
OpenWebUI осталась оболочкой: пользователи, сессии, загрузка файлов, отрисовка ответов и артефактов. Pipe-функция стала тонким адаптером. Историю из базы она не пересобирает: берёт последнее сообщение пользователя, системные правила передаёт отдельным полем, а для вложений отдаёт в Runtime исходный загруженный файл. История в БД OpenWebUI теперь нужна только для отображения и аудита.
Состояние живёт в Runtime. Внешний агент хранит стандартные items Agents SDK в файловой Session, по файлу на разговор. У Codex свой threadId, и следующие сообщения того же разговора продолжаются через resumeThread(threadId). Историю OpenWebUI ни тот, ни другой не копируют, так что вопрос «кто отвечает за контекст» закрылся сам.
Одно правило я принял сразу: в рамках одного входа исполнитель не переключается между встроенным агентом OpenWebUI и Runtime. Иначе два набора состояния — контекст, вызовы инструментов, файлы, повторы, — и при каждом сбое непонятно, чей он. Обычные модели работают как раньше, в «инженерном» входе всё идёт через Runtime.
Внутри Runtime два режима. Первый — маршрутизатор на Agents SDK, который через handoff отдаёт задачу либо агенту общего назначения, либо агенту с Codex SDK для разработки, файлов и команд. Второй, который со временем стал основным, — один SandboxAgent без маршрутизации; оркестратор остался как переключаемый вариант. 10 июля я вынес Runtime из репозитория с доработками OpenWebUI в отдельный проект. Поиск файлов в webui.db специально оставил в Pipe-функции, чтобы Runtime ничего не знал про внутренности OpenWebUI.
Сентябрь: в стриме вызов есть, в итоге — нет
До осени Runtime ходил в шлюз через Chat Completions. 9 сентября я проверял переход на Responses API, в том числе ради compaction. Обычный непотоковый запрос работал. Нативный сценарий Agents SDK с handoff и инструментами падал так:
Max turns (8) exceededАгент вызывал инструмент, не видел его и вызывал снова, пока не кончались ходы. Я стал смотреть сырые SSE-события. В response.output_item.done вызов function_call приходил нормально, а в финальном response.completed поле response.output было пустым массивом. Установленная версия Agents SDK (0.13.0) собирала итог хода как раз из response.output финального события. Тот же запрос с stream:false возвращал JSON, где function_call на месте.
С compaction то же самое. Промежуточные события приносили compaction, message, ещё раз compaction, у элементов сжатия есть encrypted_content, а финальный output снова пустой.
Ключевая строка пробника, переформатированная
// raw — тело SSE-ответа целикомconst events = raw.split("n") .filter(l => l.startsWith("data:")) .flatMap(l => { try { return [JSON.parse(l.slice(5))]; } catch { return []; } });let obj = events.findLast(e => e.type === "response.completed")?.response;// финальный output пустой — собираем его из промежуточных событийif (obj && !obj.output?.length) { obj = { ...obj, output: events .filter(e => e.type === "response.output_item.done") .map(e => e.item), };}Я написал отдельный пробник, который просто собирал response.output_item.done в памяти, SDK и прод не трогал. С ним результат инструмента возвращался к модели, и модель отвечала значением из инструмента. Compaction тоже заработал: с store:false и context_management=[{type:compaction,compact_threshold:1000}] пришёл зашифрованный элемент сжатия. Дальше я выкинул длинную историю, оставил только последний compaction item и новый вопрос, и модель восстановила все три контрольных факта.
На экономию я рассчитывал зря. Шлюз отчитался input_tokens=28102, на следующем ходу — 28 053. Байты запроса в тот раз я не замерял. Кто теряет output, шлюз или то, что за ним, тоже не выяснил: поток до и после прокси я побайтно не сравнивал.
В тот день прод остался на Chat. Кроме пустого output, висели 400 Upstream request failed у SandboxAgent на Responses и недоделанная связка compaction с Session. Был и подвох в отчёте: часть сценариев формально «прошла», файл сгенерирован. Только в списке запросов там же стоял /v1/chat/completions — Runtime молча откатился на Chat. Такие прогоны я записал в провалы.
Октябрь: переключение
Перед переключением пришлось чинить связь между OpenWebUI и Runtime. Из процесса OpenWebUI, с его реальным окружением, запросы к Runtime стабильно давали URLError / Errno 111 Connection refused, а без прокси проходили с 200. Проверка из обычного шелла тут ничего не доказывала. С тех пор в приёмке есть запрос именно из окружения процесса OpenWebUI и реальный прогон через Pipe.
23 октября прод переключили на Responses вместе с обновлением зависимостей Runtime. Версии «после» взяты из состояния работающего контейнера, «до» — из lock-файла и Dockerfile прежней сборки:
Компонент
Было
Стало
OpenWebUI
v0.11.0
v0.11.0 (не обновлялся)
@openai/agents
0.13.0
0.21.0
Codex SDK
0.143.0
0.163.0
openai (npm)
6.45.0
7.43.0
Node.js
20
22.23.4
Все агенты по умолчанию читают конфигурацию Responses. Старую логику «превысил число ходов — откатись на Chat Completions» я удалил, чтобы откат больше не прятал ошибки. Фронтенд OpenWebUI по-прежнему ходит в свой /api/chat/completions, но это вход оболочки, к протоколу между Runtime и шлюзом он не относится.
Шлюз не поддерживал нативный инструмент apply_patch из Codex. Я выключил его отдельным флагом в конфигурации Runtime, правка файлов через Shell осталась.
Приёмка: потоковый Responses, файлы через Shell, память сессии, handoff и HTML через Codex — 6/6, без отката на другой протокол. Копию тестовой сессии, созданной старым SDK, удалось продолжить на новом — 1/1, реальные разговоры пользователей я не трогал. Проверял через API: страница чата в браузере отдавала ERR_EMPTY_RESPONSE. Вне приёмки остались восстановление внутреннего Codex thread между версиями SDK, генерация изображений и долгая параллельная нагрузка. И да, healthcheck контейнера помечает его unhealthy, но сам не перезапускает.
Что бы я сделал иначе
Фильтр надо было гонять на выгрузке настоящей истории. Красивые ~3637 → ~103 из dry-run проверили только то, что я сам туда положил, а основной объём в проде шёл через текст ответов assistant. Узнал я об этом из суточной статистики: 128 срабатываний, два удалённых сообщения.
Модель сжатия выбирают под худший случай. Сводка нужна как раз тогда, когда история огромная, и gpt-4o-mini с лимитом в 128 000 токенов отказывал на тех разговорах, ради которых всё и затевалось.
Агента стоило выносить из OpenWebUI раньше. Фильтр полезен, он у нас остался. Но цикл «прочитать, поправить, запустить, проверить» требует своего исполнителя со своей сессией, а OpenWebUI хорошо работает как оболочка вокруг него.
С потоковым API правило теперь простое: промежуточные items сохраняю с первого дня и сверяю с финальным объектом. Зелёный тест ничего не значит, пока не видно, по какому протоколу на самом деле ушли запросы.
Источник: habr.com